library(ggplot2)
library(gganimate)
library(magrittr)
library(dplyr)
library(kableExtra)Mínimos Quadrados Ordinários
Utilizaremos o banco de dados trees. Esse banco de dados contém informações sobre o diâmetro em polegadas, altura em pés e volume em pés³ de 31 árvores black cherry.
Além disso, os gráficos serão gerados utilizando o pacote ggplot2, com comentários pertinentes sobre as funções utilizadas. Os comandos do pacote ggplot2 são inseridos em camadas, normalmente iniciando por uma função que indica o banco de dados utilizado e, posteriormente, pelas demais funções. As variáveis utilizadas para criar os gráficos devem estar “mapeadas”, e a maneira de fazer isso é inserindo-as dentro do argumento aes(). No exemplo abaixo, o primeiro nível de comando especifica o banco de dados utilizado. O segundo indica o tipo de gráfico a ser criado e mapeia as variáveis de interesse. O terceiro comando introduz os títulos dos eixos, do gráfico etc. E o quarto comando aplica um tema pronto ao gráfico. Para mais informações sobre o pacote ggplot2, acesse este breve tutorial.
data("trees")

# Transforma as variáveis para unidades comumente utilizadas
d  <- trees$Girth * 2.54       # polegadas para centímetros
ht <- trees$Height * 0.3048    # pés para metros
v  <- trees$Volume / 35.3147   # pés cúbicos para metros cúbicos

d2h <- d^2 * ht

# 'd' é um vetor de diâmetros e possui 31 elementos.
d
[1] 21.082 21.844 22.352 26.670 27.178 27.432 27.940 27.940 28.194 28.448
[11] 28.702 28.956 28.956 29.718 30.480 32.766 32.766 33.782 34.798 35.052
[21] 35.560 36.068 36.830 40.640 41.402 43.942 44.450 45.466 45.720 45.720
[31] 52.324length(d)[1] 31# O mesmo ocorre com ht, v e d2h.
# Agrupa tudo em um único data frame
dados <- data.frame(d, ht, v, d2h)
g.base <- ggplot(
data = dados,
aes(x = d2h, y = v)
) +
geom_point() +
labs(
x = expression(d^2 * h),
y = "Volume (m³)",
title = expression("Volume em função de " * d^2 * h)
) +
theme_bw()
plot(g.base)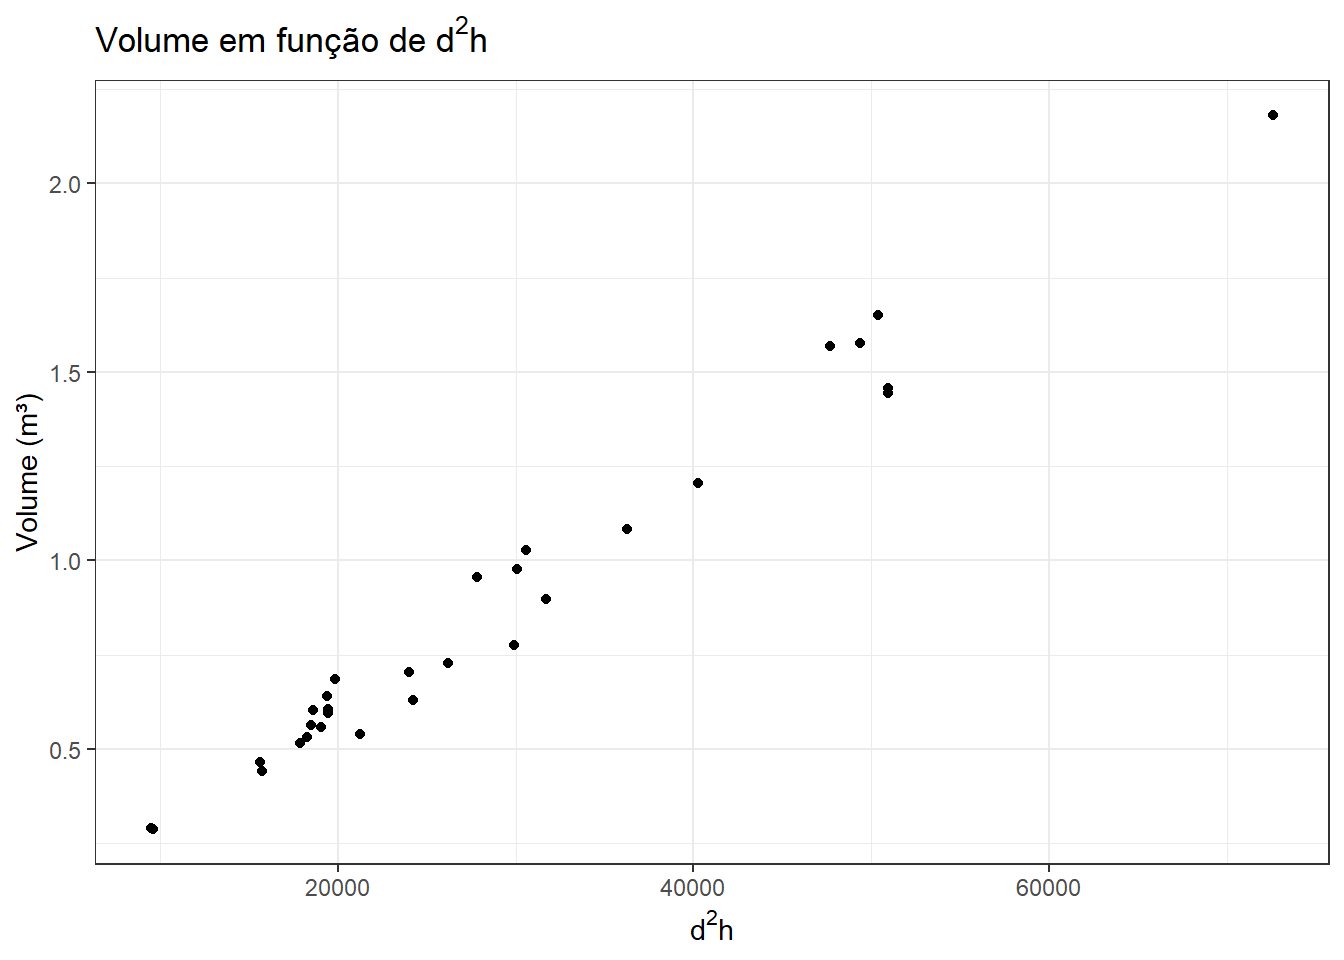
A figura acima demonstra a relação entre volume e \(d^2h\). Essa relação é conhecida no meio florestal pelo modelo de Spurr,
\[ v = \beta_0 + \beta_1d^2h, \]
e evidencia uma relação aproximadamente linear entre as duas variáveis.
Para encontrar os parâmetros do modelo, basta utilizar a função lm().
spurr <- lm(v ~ d2h, data = dados)

summary(spurr)
Call:
lm(formula = v ~ d2h, data = dados)

Residuals:
      Min        1Q    Median        3Q       Max
-0.130808 -0.031154 -0.004689  0.049416  0.118861

Coefficients:
                 Estimate    Std. Error t value            Pr(>|t|)
(Intercept) -0.0084293350  0.0272848246  -0.309                0.76
d2h          0.0000305910  0.0000008566  35.711 <0.0000000000000002 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 0.07059 on 29 degrees of freedom
Multiple R-squared:  0.9778,    Adjusted R-squared:  0.977
F-statistic: 1275 on 1 and 29 DF, p-value: < 0.00000000000000022coef(spurr) (Intercept) d2h
-0.00842933501 0.00003059096 g.base +
labs(title = "Modelo de Spurr ajustado") +
geom_abline(
intercept = coef(spurr)[1], # coeficiente linear (b0)
slope = coef(spurr)[2], # coeficiente angular (b1)
color = "steelblue"
)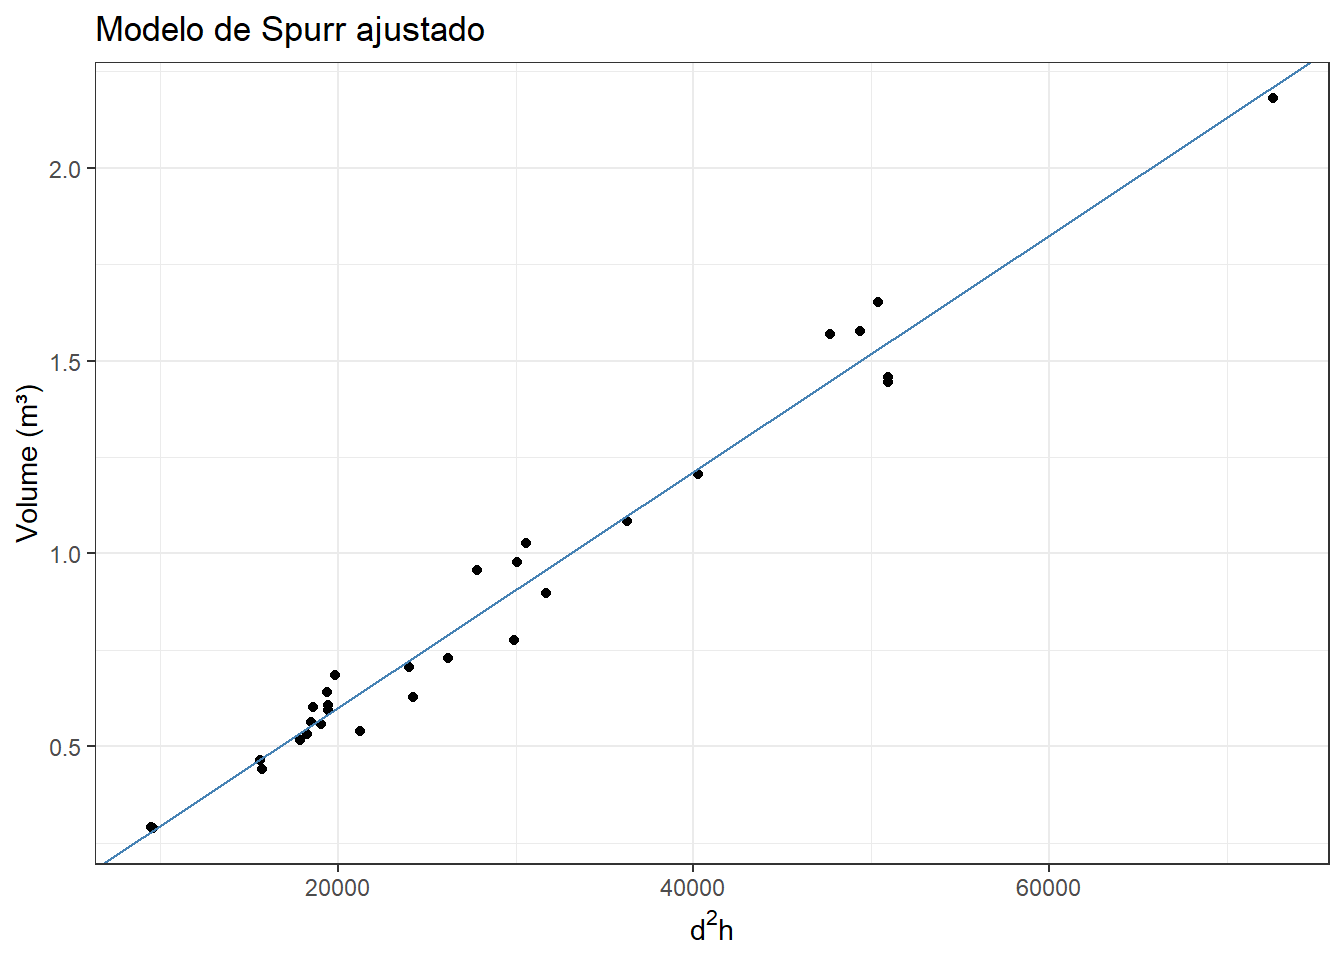
Os valores estimados de \(\beta_0\) e \(\beta_1\) foram, respectivamente, -0.00843 e 0.00003059.
Agora vamos chegar aos mesmos parâmetros realizando o método dos mínimos quadrados ordinários passo a passo.
Mínimos Quadrados Ordinários
O método dos mínimos quadrados ordinários (MQO) é o principal método de estimação dos parâmetros em modelos lineares. Seu objetivo é encontrar os valores dos parâmetros que resultam na menor soma de quadrados dos resíduos.
É importante separar o cálculo dos estimadores de MQO dos pressupostos utilizados para estabelecer suas propriedades estatísticas e realizar inferência. A minimização da soma de quadrados pode ser realizada mesmo sem pressupor normalidade dos erros. No modelo linear clássico, as condições usuais incluem:
- 1. Média condicional do erro igual a zero: \(E(\epsilon_i \mid X) = 0\);
- 2. Homocedasticidade: \(\operatorname{Var}(\epsilon_i \mid X) = \sigma^2\);
- 3. Ausência de correlação entre os erros: \(\operatorname{Cov}(\epsilon_i,\epsilon_j \mid X)=0\), para \(i \neq j\).
Quando se deseja realizar inferência exata em amostras finitas por meio das distribuições \(t\) e \(F\), é comum acrescentar a hipótese de normalidade:
\[ \boldsymbol{\epsilon}\mid X \sim N(\mathbf{0},\sigma^2I). \]
A normalidade dos erros não é necessária para calcular os estimadores de MQO nem para o resultado de Gauss–Markov. Ela é uma hipótese adicional para a inferência exata no modelo linear normal.
A formulação tradicional do modelo linear simples é
\[ y_i = \beta_0 + \beta_1x_i + \epsilon_i. \]
Onde \(\beta_0\) é o intercepto ou constante; \(\beta_1\) é o coeficiente angular associado à variável \(x\); e \(\epsilon_i\) é o erro aleatório da \(i\)-ésima observação, representando a diferença entre o valor observado e o valor esperado pelo modelo. Outra notação encontrada na literatura é \(y = \alpha + \beta x + \epsilon\).
O valor esperado de \(y_i\), condicionado a \(x_i\), é
\[ E(Y_i\mid x_i) = \beta_0 + \beta_1x_i. \]
Como os parâmetros verdadeiros \(\beta_0\) e \(\beta_1\) são desconhecidos, eles são estimados a partir da amostra. Os valores ajustados ou preditos são denotados por
\[ \hat{y}_i = \hat{\beta}_0 + \hat{\beta}_1x_i. \]
O erro populacional é
\[ \epsilon_i = y_i - (\beta_0 + \beta_1x_i), \]
e não é diretamente observável, pois depende dos parâmetros populacionais desconhecidos.
Após o ajuste do modelo, obtém-se o resíduo
\[ e_i = y_i - \hat{y}_i. \]
Portanto, erro e resíduo não são sinônimos: \(\epsilon_i\) pertence ao modelo populacional, enquanto \(e_i\) é calculado após a estimação do modelo.
Como citado anteriormente, o objetivo do MQO é encontrar os parâmetros que resultem na menor soma de quadrados dos resíduos. Se simplesmente somássemos os resíduos, valores positivos e negativos poderiam se compensar. Além disso, em uma regressão com intercepto ajustada por MQO, a soma dos resíduos é exatamente zero:
\[ \sum_{i=1}^{n}e_i = 0. \]
Por isso, a soma simples dos resíduos não mede adequadamente a magnitude dos desvios. Ao elevar cada resíduo ao quadrado, eliminamos o sinal, penalizamos mais fortemente desvios grandes e obtemos uma função diferenciável com solução analítica conveniente.
Essa ainda é uma justificativa intuitiva. Uma fundamentação probabilística adicional surge quando se assume normalidade dos erros: nesse caso, minimizar a soma de quadrados dos resíduos é equivalente a maximizar a função de verossimilhança.
Para qualquer par de valores candidatos \(b_0\) e \(b_1\), podemos escrever
\[ e_i(b_0,b_1) = y_i - b_0 - b_1x_i. \]
Assim, a função a ser minimizada é
\[ S(b_0,b_1) = \sum_{i=1}^{n}e_i(b_0,b_1)^2 = \sum_{i=1}^{n}(y_i-b_0-b_1x_i)^2. \]
Os valores de \(b_0\) e \(b_1\) que minimizam essa função serão chamados de \(\hat{\beta}_0\) e \(\hat{\beta}_1\).
Agora, se atribuirmos valores quaisquer para \(b_0\) e \(b_1\) e calcularmos o somatório, obteremos um valor de \(S\). Conforme os valores dos parâmetros mudam, a Soma de Quadrados dos Resíduos também muda.
# Função que calcula a soma de quadrados dos resíduos
S <- function(x, y, b0, b1) {
  sum((y - b0 - b1 * x)^2)
}

# Para visualizar apenas o efeito de b0 sobre S,
# mantemos b1 fixo.
b1.fixo <- unname(coef(spurr)[2])
b0.centro <- unname(coef(spurr)[1])

# Valores candidatos de b0 ao redor da região do mínimo
b_0 <- seq(
  from = b0.centro - 0.10,
  to   = b0.centro + 0.10,
  length.out = 201
)

# Calcula S para cada valor de b0, mantendo b1 constante
S.est <- vapply(
  b_0,
  FUN = function(b0) {
    S(
      x = dados$d2h,
      y = dados$v,
      b0 = b0,
      b1 = b1.fixo
    )
  },
  FUN.VALUE = numeric(1)
)

df <- data.frame(
  b0 = b_0,
  S = S.est
)

b0.min <- df$b0[which.min(df$S)]
S.min <- min(df$S)

g.S <- ggplot(df, aes(x = b0, y = S)) +
  geom_line(aes(color = S), linewidth = 1) +
  labs(
    x = expression("Parâmetro " * beta[0]),
    y = expression(S ~ "(m"^3*")"^2),
    subtitle = expression(
      "Efeito de " * beta[0] *
      " na Soma de Quadrados dos Resíduos, com " *
      beta[1] * " fixo"
    )
  ) +
  scale_color_gradient(
    low = "blue",
    high = "red",
    name = expression(S ~ "(m"^3*")"^2)
  ) +
  geom_segment(
    x = b0.min - 0.02,
    xend = b0.min + 0.02,
    y = S.min,
    yend = S.min,
    linewidth = 0.7
  ) +
  theme_bw()

plot(g.S)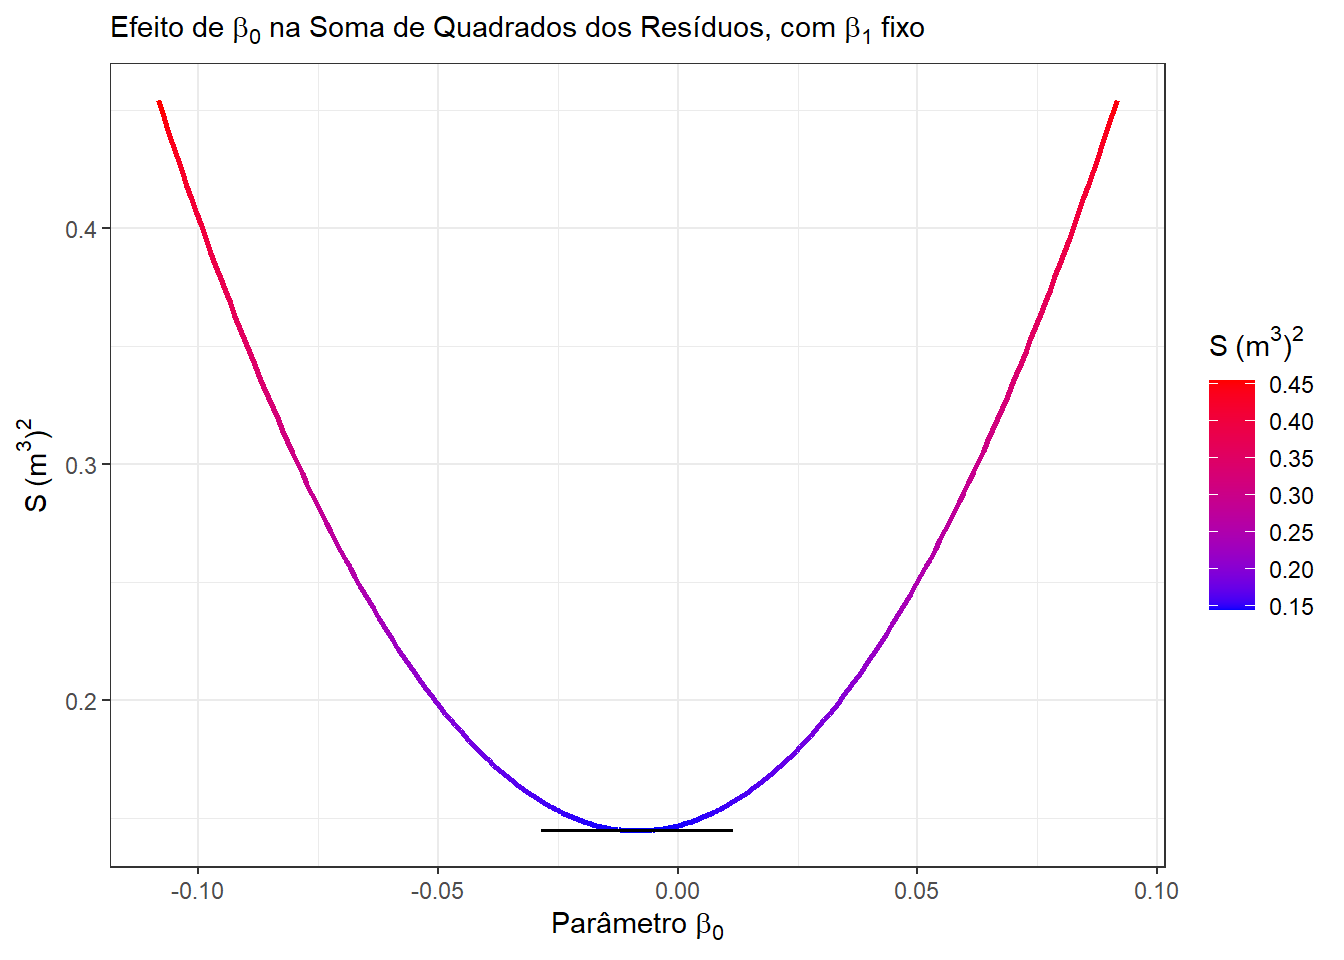
Na figura acima, apenas \(b_0\) varia, enquanto \(b_1\) permanece fixo. Dessa forma, o gráfico representa um corte unidimensional da função \(S(b_0,b_1)\). Percebe-se que existe um valor de \(b_0\) para o qual \(S\) é mínimo. Se repetíssemos o procedimento variando apenas \(b_1\), mantendo \(b_0\) fixo, observaríamos o mesmo comportamento quadrático.
Na realidade, \(S\) depende simultaneamente de dois parâmetros. Portanto, no caso da regressão linear simples, podemos imaginar \(S(b_0,b_1)\) como uma superfície. O MQO procura o ponto mais baixo dessa superfície.
Uma maneira de encontrar pontos críticos de uma função diferenciável é igualar suas derivadas a zero. Entretanto, uma derivada igual a zero, isoladamente, pode indicar um ponto de mínimo, máximo ou, em problemas multidimensionais, até um ponto de sela. No caso do MQO, a função \(S\) é quadrática e convexa; portanto, sob as condições usuais de posto da matriz de regressão, o ponto crítico corresponde ao mínimo global.
Para encontrarmos \(\hat{\beta}_0\) e \(\hat{\beta}_1\), derivaremos \(S\) em relação aos parâmetros. Esse procedimento é chamado de derivada parcial, denotada por \(\partial\).
Primeiramente, podemos expandir o quadrado:
\[ S(\beta_0,\beta_1) = \sum_{i=1}^{n} (y_i-\beta_0-\beta_1x_i)^2, \]
\[ S(\beta_0,\beta_1) = \sum_{i=1}^{n} \left( y_i^2 +\beta_0^2 +\beta_1^2x_i^2 -2y_i\beta_0 -2y_i\beta_1x_i +2\beta_0\beta_1x_i \right). \]
Derivada parcial em relação a \(\beta_0\)
As regras de derivação são as mesmas de qualquer outra diferenciação. Como a variável de interesse é \(\beta_0\), os termos que não dependem de \(\beta_0\) são tratados como constantes.
\[ \frac{\partial S}{\partial \beta_0} = \sum_{i=1}^{n} \left( 2\beta_0 -2y_i +2\beta_1x_i \right). \]
No ponto que minimiza \(S\), \(\beta_0=\hat{\beta}_0\) e \(\beta_1=\hat{\beta}_1\). Assim,
\[ \left. \frac{\partial S}{\partial \beta_0} \right|_{\hat{\beta}_0,\hat{\beta}_1} = \sum_{i=1}^{n} \left( 2\hat{\beta}_0 -2y_i +2\hat{\beta}_1x_i \right) = 0. \]
Colocando 2 em evidência,
\[ 2 \sum_{i=1}^{n} \left( \hat{\beta}_0-y_i+\hat{\beta}_1x_i \right) = 0. \]
Dividindo por 2 e multiplicando por \(-1\),
\[ \sum_{i=1}^{n} \left( y_i-\hat{\beta}_0-\hat{\beta}_1x_i \right) = 0. \]
Observe que o termo entre parênteses é exatamente o resíduo \(e_i\). Portanto, uma consequência do MQO em modelos com intercepto é
\[ \sum_{i=1}^{n}e_i=0. \]
Expandindo o somatório,
\[ \sum_{i=1}^{n}y_i - n\hat{\beta}_0 - \hat{\beta}_1\sum_{i=1}^{n}x_i = 0. \]
Dividindo tudo por \(n\),
\[ \frac{\sum_{i=1}^{n}y_i}{n} - \hat{\beta}_0 - \hat{\beta}_1 \frac{\sum_{i=1}^{n}x_i}{n} = 0. \]
Como
\[ \bar{y}=\frac{\sum_{i=1}^{n}y_i}{n} \qquad\text{e}\qquad \bar{x}=\frac{\sum_{i=1}^{n}x_i}{n}, \]
temos
\[ \bar{y} - \hat{\beta}_0 - \hat{\beta}_1\bar{x} = 0, \]
e, portanto,
\[ \boxed{ \hat{\beta}_0 = \bar{y} - \hat{\beta}_1\bar{x} }. \]
Derivada parcial em relação a \(\beta_1\)
A derivada de \(S\) em relação a \(\beta_1\) é
\[ \frac{\partial S}{\partial \beta_1} = \sum_{i=1}^{n} \left( 2\beta_1x_i^2 -2y_ix_i +2\beta_0x_i \right). \]
Colocando \(2x_i\) em evidência,
\[ \frac{\partial S}{\partial \beta_1} = 2 \sum_{i=1}^{n} x_i \left( \beta_1x_i-y_i+\beta_0 \right). \]
No ponto de mínimo,
\[ \left. \frac{\partial S}{\partial \beta_1} \right|_{\hat{\beta}_0,\hat{\beta}_1} = 2 \sum_{i=1}^{n} x_i \left( \hat{\beta}_1x_i-y_i+\hat{\beta}_0 \right) = 0. \]
Dividindo por 2,
\[ \sum_{i=1}^{n} x_i \left( -y_i+\hat{\beta}_0+\hat{\beta}_1x_i \right) = 0. \]
Expandindo,
\[ -\sum_{i=1}^{n}x_iy_i + \hat{\beta}_0\sum_{i=1}^{n}x_i + \hat{\beta}_1\sum_{i=1}^{n}x_i^2 = 0. \]
Portanto,
\[ \hat{\beta}_0\sum_{i=1}^{n}x_i + \hat{\beta}_1\sum_{i=1}^{n}x_i^2 = \sum_{i=1}^{n}x_iy_i. \]
Encontradas as duas equações, ainda precisamos resolvê-las simultaneamente. Uma solução é substituir
\[ \hat{\beta}_0 = \bar{y} - \hat{\beta}_1\bar{x} \]
na segunda equação normal:
\[ (\bar{y}-\hat{\beta}_1\bar{x}) \sum_{i=1}^{n}x_i + \hat{\beta}_1\sum_{i=1}^{n}x_i^2 = \sum_{i=1}^{n}x_iy_i. \]
Como
\[ \bar{x} = \frac{\sum_{i=1}^{n}x_i}{n}, \]
então
\[ \sum_{i=1}^{n}x_i=n\bar{x}. \]
Logo,
\[ (\bar{y}-\hat{\beta}_1\bar{x})n\bar{x} + \hat{\beta}_1\sum_{i=1}^{n}x_i^2 = \sum_{i=1}^{n}x_iy_i, \]
\[ n\bar{x}\bar{y} - \hat{\beta}_1n\bar{x}^2 + \hat{\beta}_1\sum_{i=1}^{n}x_i^2 = \sum_{i=1}^{n}x_iy_i, \]
\[ -\hat{\beta}_1n\bar{x}^2 + \hat{\beta}_1\sum_{i=1}^{n}x_i^2 = \sum_{i=1}^{n}x_iy_i - n\bar{x}\bar{y}, \]
\[ \hat{\beta}_1 \left( \sum_{i=1}^{n}x_i^2-n\bar{x}^2 \right) = \sum_{i=1}^{n}x_iy_i - n\bar{x}\bar{y}. \]
Assim,
\[ \boxed{ \hat{\beta}_1 = \frac{ \displaystyle \sum_{i=1}^{n}x_iy_i - n\bar{x}\bar{y} }{ \displaystyle \sum_{i=1}^{n}x_i^2 - n\bar{x}^2 } } \]
ou, de forma equivalente,
\[ \boxed{ \hat{\beta}_1 = \frac{ \displaystyle \sum_{i=1}^{n}x_iy_i - \frac{ \left(\sum_{i=1}^{n}x_i\right) \left(\sum_{i=1}^{n}y_i\right) }{n} }{ \displaystyle \sum_{i=1}^{n}x_i^2 - \frac{ \left(\sum_{i=1}^{n}x_i\right)^2 }{n} } }. \]
Uma forma ainda bastante comum de escrever o mesmo estimador é
\[ \boxed{ \hat{\beta}_1 = \frac{ \sum_{i=1}^{n} (x_i-\bar{x})(y_i-\bar{y}) }{ \sum_{i=1}^{n} (x_i-\bar{x})^2 } }. \]
Agora podemos calcular os valores de \(\hat{\beta}_0\) e \(\hat{\beta}_1\) diretamente.
x <- d2h
y <- v

n <- length(x)

# Estimadores obtidos pelas expressões deduzidas acima
b1.mqo <- (
  sum(x * y) - (sum(x) * sum(y)) / n
) / (
  sum(x^2) - (sum(x)^2) / n
)

b0.mqo <- mean(y) - b1.mqo * mean(x)

b0.mqo
[1] -0.008429335b1.mqo[1] 0.00003059096O caso mostrado acima foi montado para a regressão linear simples, com os parâmetros \(\hat{\beta}_0\) e \(\hat{\beta}_1\). O sistema de equações normais é
\[ \begin{cases} n\hat{\beta}_0 + \hat{\beta}_1\displaystyle\sum_{i=1}^{n}x_i = \displaystyle\sum_{i=1}^{n}y_i \\[0.5em] \hat{\beta}_0\displaystyle\sum_{i=1}^{n}x_i + \hat{\beta}_1\displaystyle\sum_{i=1}^{n}x_i^2 = \displaystyle\sum_{i=1}^{n}x_iy_i \end{cases} \]
Para uma regressão linear múltipla, com mais de uma variável explicativa, o processo é semelhante, mas o número de equações normais aumenta com o número de parâmetros.
Quando muitas variáveis são adicionadas, é mais conveniente escrever o problema por meio de álgebra matricial.
Considere o modelo
\[ \mathbf{Y} = \mathbf{X}\boldsymbol{\beta} + \boldsymbol{\epsilon}. \]
Adotaremos \(p\) como o número total de parâmetros do modelo, incluindo o intercepto. Assim,
\[ \boldsymbol{\beta} = \begin{bmatrix} \beta_0\\ \beta_1\\ \vdots\\ \beta_{p-1} \end{bmatrix}_{p\times1}, \qquad \mathbf{Y} = \begin{bmatrix} y_1\\ y_2\\ \vdots\\ y_n \end{bmatrix}_{n\times1}, \qquad \boldsymbol{\epsilon} = \begin{bmatrix} \epsilon_1\\ \epsilon_2\\ \vdots\\ \epsilon_n \end{bmatrix}_{n\times1}. \]
A matriz de regressão é
\[ \mathbf{X} = \begin{bmatrix} 1 & x_{11} & \cdots & x_{1,p-1}\\ 1 & x_{21} & \cdots & x_{2,p-1}\\ \vdots & \vdots & \ddots & \vdots\\ 1 & x_{n1} & \cdots & x_{n,p-1} \end{bmatrix}_{n\times p}. \]
Após a estimação,
\[ \hat{\mathbf{Y}} = \mathbf{X}\hat{\boldsymbol{\beta}}, \]
e o vetor de resíduos é
\[ \mathbf{e} = \mathbf{Y} - \hat{\mathbf{Y}} = \mathbf{Y} - \mathbf{X}\hat{\boldsymbol{\beta}}. \]
Assim como anteriormente, queremos minimizar a soma de quadrados dos resíduos. Para um vetor candidato de parâmetros \(\boldsymbol{\beta}\),
\[ S(\boldsymbol{\beta}) = (\mathbf{Y}-\mathbf{X}\boldsymbol{\beta})^\top (\mathbf{Y}-\mathbf{X}\boldsymbol{\beta}). \]
Expandindo,
\[ S(\boldsymbol{\beta}) = \mathbf{Y}^\top\mathbf{Y} - \mathbf{Y}^\top\mathbf{X}\boldsymbol{\beta} - \boldsymbol{\beta}^\top\mathbf{X}^\top\mathbf{Y} + \boldsymbol{\beta}^\top\mathbf{X}^\top\mathbf{X}\boldsymbol{\beta}. \]
Como \(\mathbf{Y}^\top\mathbf{X}\boldsymbol{\beta}\) é um escalar,
\[ \mathbf{Y}^\top\mathbf{X}\boldsymbol{\beta} = \boldsymbol{\beta}^\top\mathbf{X}^\top\mathbf{Y}. \]
Portanto,
\[ S(\boldsymbol{\beta}) = \mathbf{Y}^\top\mathbf{Y} - 2\boldsymbol{\beta}^\top\mathbf{X}^\top\mathbf{Y} + \boldsymbol{\beta}^\top\mathbf{X}^\top\mathbf{X}\boldsymbol{\beta}. \]
O gradiente em relação a \(\boldsymbol{\beta}\) é
\[ \nabla_{\boldsymbol{\beta}}S = -2\mathbf{X}^\top\mathbf{Y} + 2\mathbf{X}^\top\mathbf{X}\boldsymbol{\beta}. \]
No ponto de mínimo, \(\boldsymbol{\beta}=\hat{\boldsymbol{\beta}}\) e o gradiente é igual a zero:
\[ -2\mathbf{X}^\top\mathbf{Y} + 2\mathbf{X}^\top\mathbf{X}\hat{\boldsymbol{\beta}} = 0, \]
\[ \mathbf{X}^\top\mathbf{X}\hat{\boldsymbol{\beta}} = \mathbf{X}^\top\mathbf{Y}. \]
Essas são as equações normais em forma matricial.
Se \(\mathbf{X}\) possui posto completo de colunas, então \(\mathbf{X}^\top\mathbf{X}\) é invertível e
\[ \boxed{ \hat{\boldsymbol{\beta}} = (\mathbf{X}^\top\mathbf{X})^{-1} \mathbf{X}^\top\mathbf{Y} }. \]
Além disso, a matriz Hessiana da função \(S\) é
\[ \mathbf{H} = 2\mathbf{X}^\top\mathbf{X}. \]
Quando \(\mathbf{X}\) possui posto completo, \(\mathbf{X}^\top\mathbf{X}\) é definida positiva. Portanto, o ponto crítico encontrado acima é o único mínimo global da soma de quadrados.
Também podemos utilizar a expressão matricial para encontrar os parâmetros.
X <- model.matrix(y ~ x)

betas <- solve(t(X) %*% X) %*% t(X) %*% y

betas
[,1]
(Intercept) -0.00842933501
x 0.00003059096A expressão acima é útil para compreender a álgebra do MQO. Na prática computacional, não é recomendável formar explicitamente \((X^\top X)^{-1}\) quando existem métodos numericamente mais estáveis. A função
lm(), por exemplo, utiliza uma decomposição QR.
E, para verificarmos que os cálculos coincidem:
coef(lm(y ~ x)) (Intercept) x
-0.00842933501 0.00003059096 As três formas produzem os mesmos coeficientes, salvo diferenças numéricas de arredondamento.
| MQO | MQO_Mat | R | |
|---|---|---|---|
| B0 | -0.0084293 | -0.0084293 | -0.0084293 |
| B1 | 0.0000306 | 0.0000306 | 0.0000306 |
Esse é o método dos mínimos quadrados.