Geração de Números Aleatórios
INTRODUÇÃO
Esse trabalho foi requisito para aprovação na disciplina CE089 - Estatística Computacional II, ofertada para o curso de Estatística da Universidade Federal do Paraná, e ministrada pelos professores Paulo Justiniano Ribeiro Júnior e Walmes Zeviani. O objetivo do trabalho foi gerar amostras aleatórias de uma certa distribuição de probabilidade com um parâmetro \(\theta\), e a partir dessas amostras realizar a estimativa pontual e intervalar de \(\hat{\theta}\) via máxima verossimilhança, jackknife e bootstrap.
Em linhas gerais, esses são os principais pontos do trabalho, que eu gostaria que o leitor se atentasse para os seguintes pontos:
A geração de números aleatórios a partir do algoritmo de Metropolis-Hastings
O tamanho do intervalo de confiança é diferente para diferentes valores de \(\theta\)
O intervalo de confiança diminui à medida que aumenta o tamanho da amostra
A distribuição de probabilidade escolhida foi
\[\begin{equation} F(x) = 1-e^{-x^2 \over 2\theta^2} \quad , \quad x > 0 , \enspace \theta > 0 (\#eq:f) \end{equation}\]Veja que @ref(eq:f) já é a distribuição acumulada de \(x\). Já a densidade pode ser obtida derivando a função em relação a \(x\):
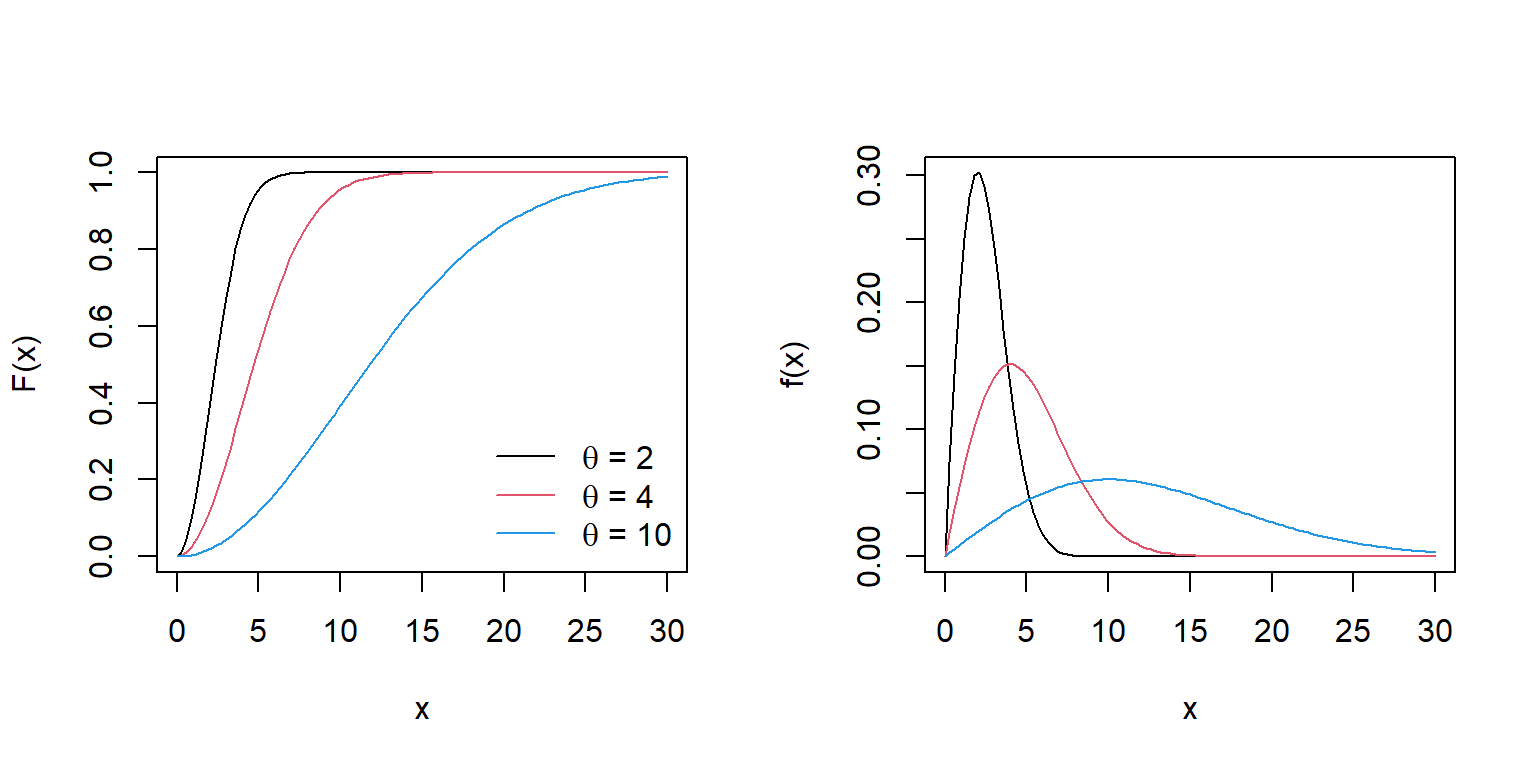
\[\begin{equation} f(x) = {dF(x) \over dx} = {d \over dx} \Big[1-e^{-x^2 \over 2\theta^2} \Big] = {x e^{ {-x^2 \over 2\theta^2}} \over \theta^2} (\#eq:fder) \end{equation}\]Na @ref(fig:f2) estão apresentadas as curvas de densidade e acumuladas da distribuição escolhida para diferentes valores do parâmetro \(\theta\).
Veja que nosso objetivo é gerar valores de \(x\) pertencentes à essa distribuição com um determinado valor de \(\theta\) fixado, e a partir dessa amostra de \(x\) encontrar o valor de \(\theta\) que foi usado para gerar esses dados, denotado por \(\hat{\theta}\). Portanto \(\theta\) se refere ao valor paramétrico, verdadeiro, aquele que gerou os dados, e \(\hat{\theta}\) é a nossa estimativa do valor verdadeiro a partir dos dados. Como é uma estimativa, há uma incerteza associada à essa estimativa. Essa incerteza é a base dos intervalos de confiança.
Vamos tentar estimar o parâmetro \(\theta\) e sua incerteza a partir de três métodos. O primeiro é a partir da máxima verossimilhança, o segundo a partir de jackknife, e o terceiro a partir de bootstrap. Também vamos repetir esse experimento inúmeras vezes e avaliar o comportamento da estimativa para um grande número de repetições, o que também caracteriza esse trabalho como um estudo de Monte Carlo.
Gerador de números aleatórios
Como gerar números aleatórios dessa distribuição? no R, diversas distribuições de probabilidade possuem geradores de números aleatórios já implementados no pacote base: rnorm(), rexp(), rchisq(), etc. A distribuição desse trabalho, no entanto, não possui tal função implementada, e vamos utilizar um algoritmo chamado Metropolis-Hastings para amostrar dessa distribuição. Tudo que precisamos é a função densidade @ref(eq:fder).
De uma maneira resumida, o algoritmo de Metropolis-Hastings usa uma outra distribuição de probabilidade (chamada de proposal) para gerar amostras da distribuição desejada. Se certas condições forem satisfeitas, com o tempo esse processo irá convergir para a distribuição estacionária de uma cadeia de Markov, que não por acaso será a própria distribuição desejada. Veja que devemos ser capazes de gerar números aleatórios da proposal para que isso funcione. Aqui, utilizei uma distribuição qui-quadrado (\(\chi^2\)) como proposal.
Como é uma cadeia de Markov que precisa entrar em estacionariedade, é comum no método “jogar fora” as amostras iniciais (burnin), de forma a só amostrar da distribuição quando o processo entrar em estacionariedade. Além disso, por ser um processo markoviano, cada amostra gerada não é independente da anterior, por isso também é comum aproveitar somente 1 a cada x amostras geradas (thinning) para amenizar essa dependência entre as observações.
Abaixo está minha implementação do algoritmo de Metropolis-Hastings para o problema.
# Proposal
g <- function(x, df, ...) {dchisq(x, df, ...)}

rfun <- function(n, theta, dprop, burnin = 1000, thinning = 10, x0 = rchisq(1,3), ...) {
  # n: número de amostras geradas da distribuição

  # theta: parâmetro da distribuição

  # dprop: função densidade da distribuição proposta

  # burnin: número de amostras de aquecimento. O padrão é 1000

  # thinning: passo de seleção de amostras para amenizar a autocorrelação. O padrão é 10

  # x0: valor inicial da distribuição proposta. O padrão é rchisq(n = 1, df = 3)

  # ...: demais argumentos passados para a função dprop

  x <- numeric(n)
  x[1] <- x0
  k <- 0

  for (i in 2:(n*thinning+burnin)) {

    y <- rchisq(1,x[i-1])

    alpha <- exp((log(dfun(y, theta))+log(g(x[i-1], y))) -
                   (log(dfun(x[i-1], theta))+log(g(y, x[i-1]))))

    if (runif(1) <= alpha) {
      x[i] <- y
      k <- k+1
    } else {
      x[i] <- x[i-1]
    }

  }

  xn <- x[-c(1:burnin)]
  xn <- xn[seq(0,length(xn), thinning)]

  return(list(mcmc = xn, k = k/(n*thinning+burnin)))

}
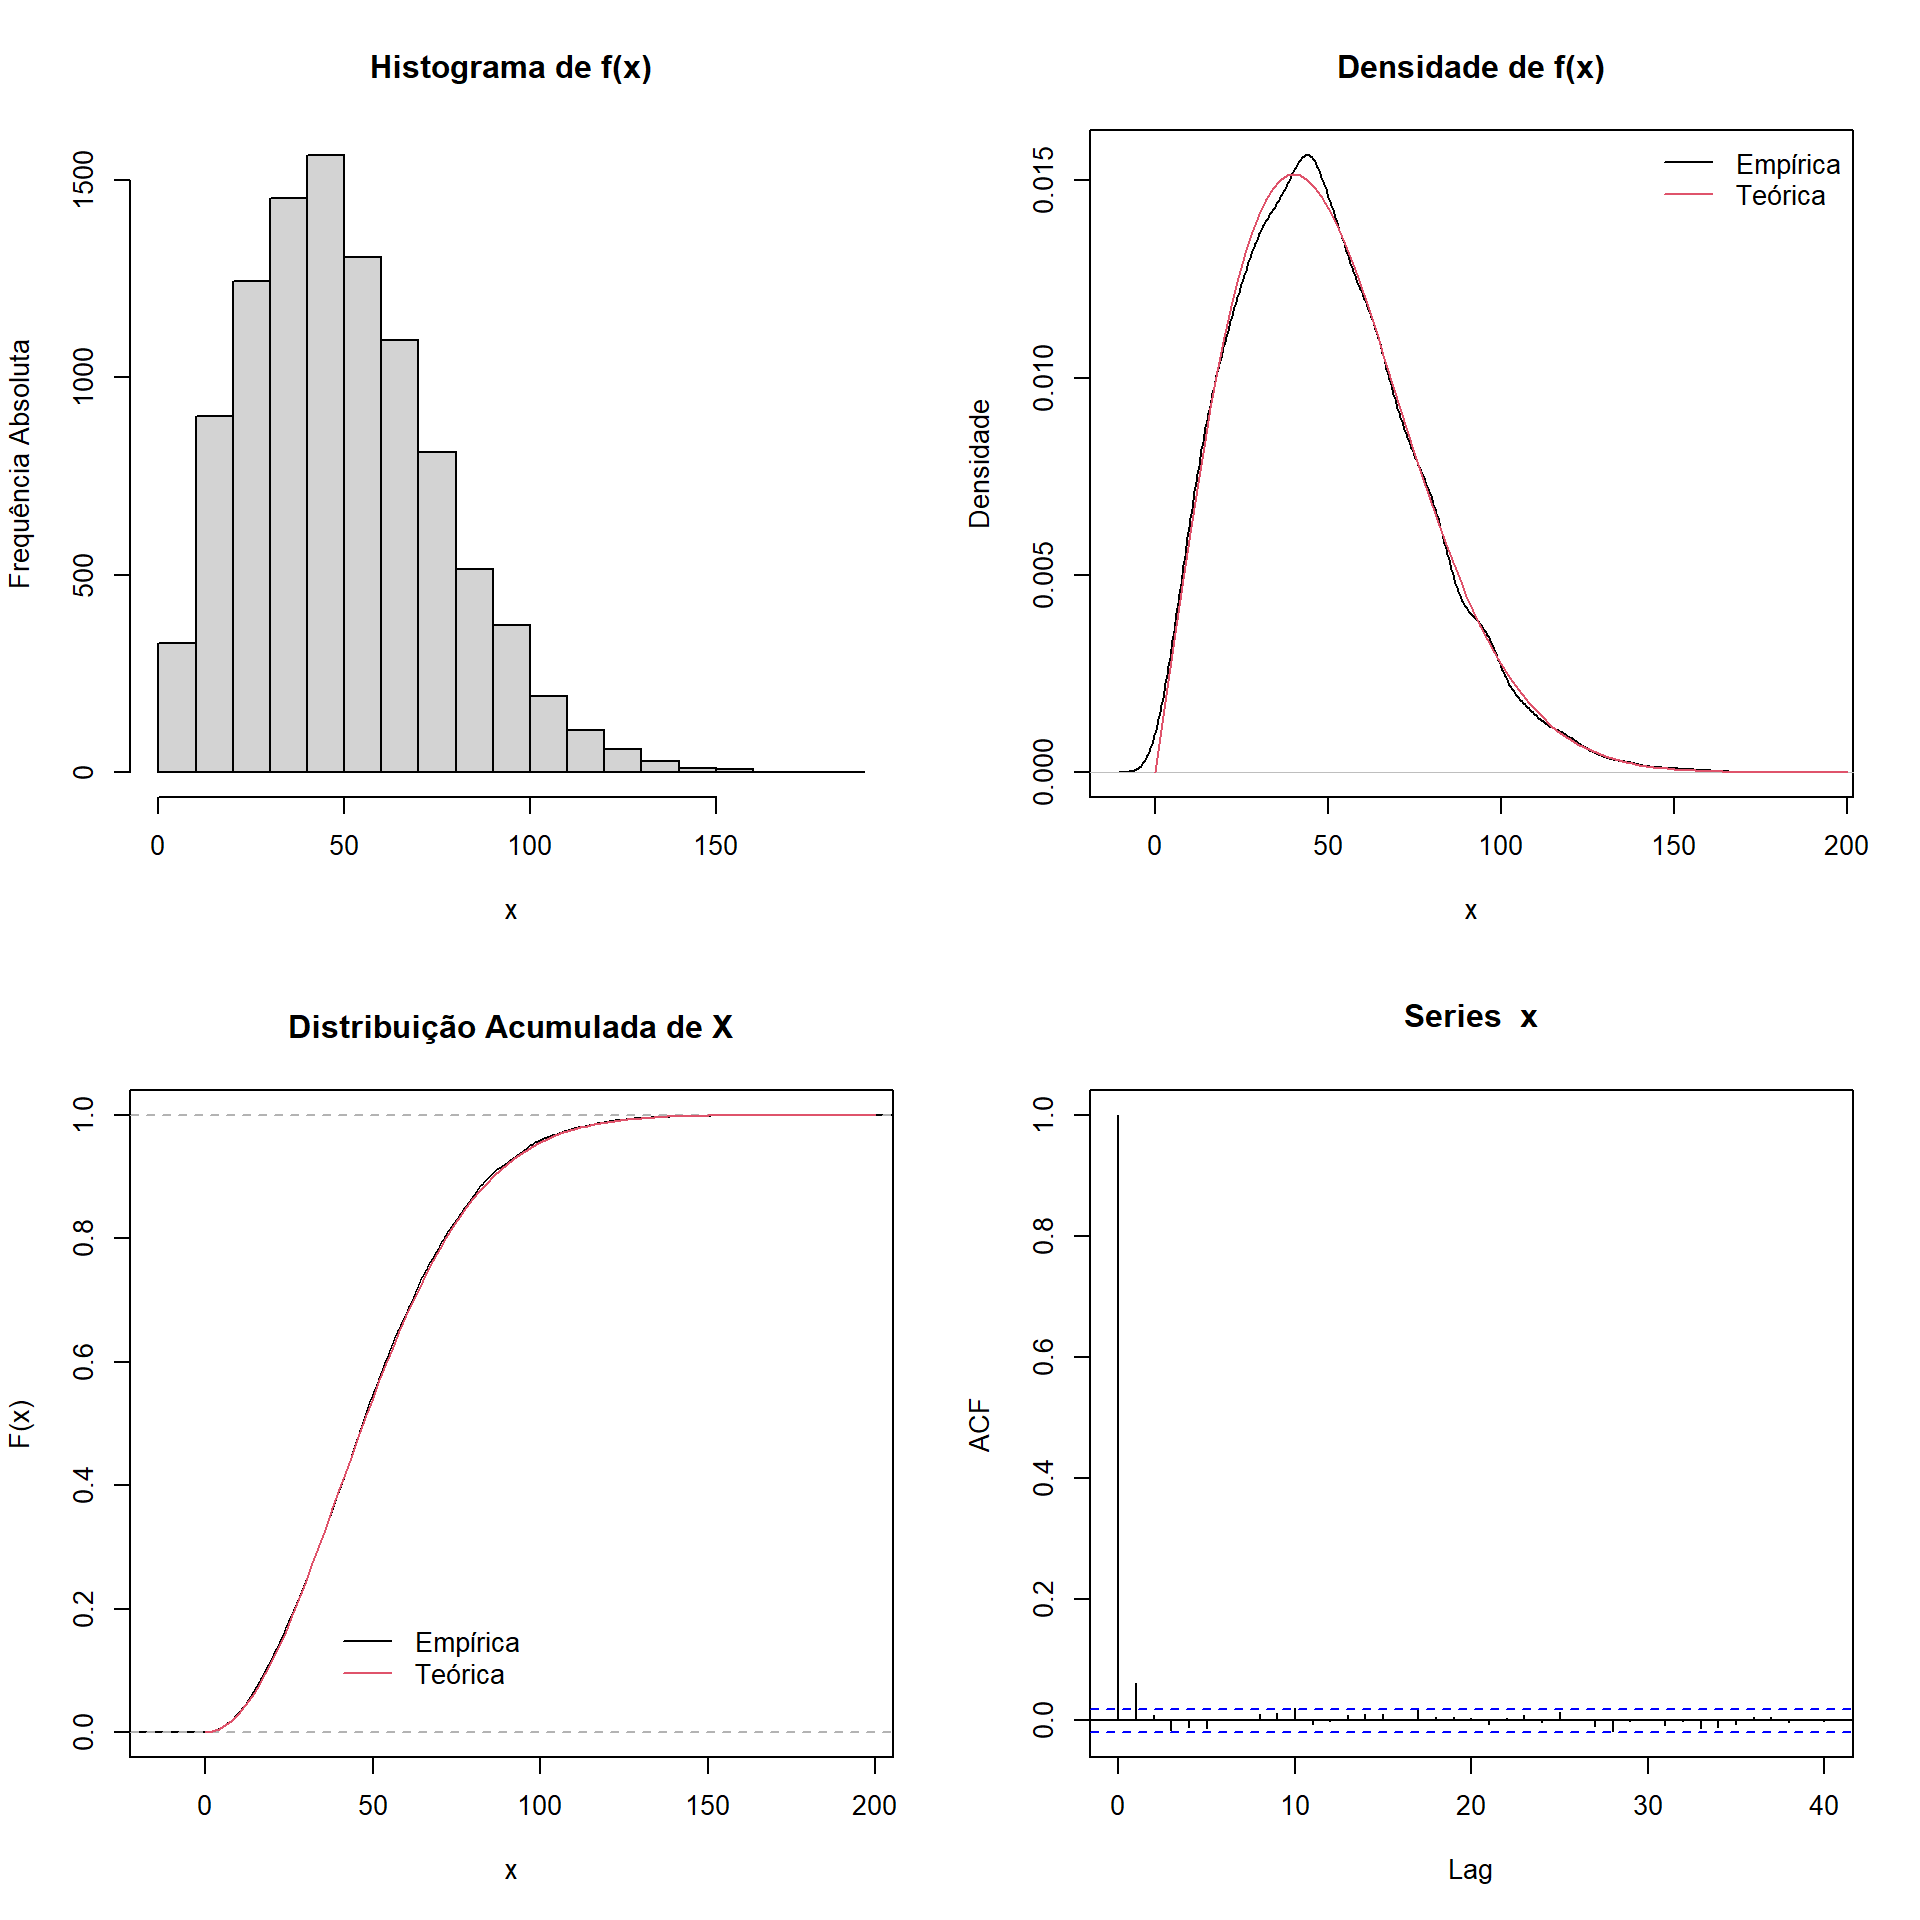
Na Figura @ref(fig:gna) há um exemplo comparando a distribuição teórica de parâmetro \(\theta = 40\) com a distribuição empírica construída a partir de 10000 amostras geradas pelo algoritmo de Metropolis-Hastings. As curvas estão bem parecidas, então aparentemente o algoritmo funciona bem. O painel inferior direito da figura mostra a função de autocorrelação, e aparentemente um valor de raleio de 50 elimina a dependência entre observações.
Foi utilizado um burnin de 1000 amostras, e um thinning de 50. Isso quer dizer que as primeiras 1000 amostras geradas pelo algoritmo foram descartadas, e após isso, apenas uma amostra a cada 50 foi de fato utilizada. Em outras palavras, para ter uma amostra de tamanho 10000, precisamos gerar \(10000*50 + 1000 = 501000\) valores da distribuição desejada.
ESTIMANDO \(\theta\)
Estimador de máxima verossimilhança
Para estimar \(\hat{\theta}\) a partir dos dados, usarei o estimador de máxima verossimilhança de \(\theta\). O método de máxima verossimilhança basicamente nos responde a seguinte questão: dado que esses são os dados, qual seria o valor de \(\theta\) que torna mais provável a geração desses dados? Mais informações podem ser obtidas aqui.
As funções de verissimilhança \(L(x)\) e log-verossimilhança \(lL(x)\) são escritas como
\[\begin{equation} L(x|\theta) = \displaystyle\prod_{i=1}^{n} { x_i e^{-x^2_i \over 2\theta^2} \over \theta^2} = {\displaystyle \prod_{i=1}^n x_i e^{-x^2_i \over 2\theta^2} \over \theta^{2n}} \end{equation}\] \[\begin{equation} \label{eq:lL} lL(\theta | x) = log(L(x|\theta)) = \sum_{i=1}^n log(x_i) - {\displaystyle \sum_{i=1}^n x^2_i \over 2\theta^2} - 2n log(\theta) \end{equation}\]O estimador de máxima verossimilhança de \(\theta\) é obtido a partir da derivada de \(lL(x)\) em relação à \(\theta\) e igualando a derivada a 0.
\[ U(\theta) = {d \over d\theta} [lL(\theta | x)] = {\displaystyle\sum_{i=1}^n x^2_i \over \theta^3} - {2n \over \theta} \]
\[ {\displaystyle\sum_{i=1}^n x^2_i \over \hat{\theta}^3} - {2n \over \hat{\theta}} = 0 \]
\[\begin{equation} \hat{\theta} = \Bigg( {\displaystyle\sum_{i=1}^n x^2_i \over 2n } \Bigg)^{1 \over 2} (\#eq:esttheta) \end{equation}\]Ou seja, dado meu conjunto de dados \(x\), @ref(eq:esttheta) é o estimador de máxima verossimilhança de \(\theta\). Abaixo está sua implementação em R. Usarei essa função para estimar \(\hat{\theta}\) ao longo do trabalho.
esttheta <- function(amostra, ...) (sum(amostra^2)/(2*length(amostra)))^(1/2)Variância do estimador de máxima verossimilhança
A Variância do estimador é definida como \(V(\theta) = -I(\theta)^{-1}\). A informação observada de Fisher para essa distribuição é dada por
\[ I(\theta) = {d \over d\theta} [U(\theta)] = {-3\displaystyle \sum_{i=1}^n x^2_i \over \theta^4} + {2n \over \theta^2} = {-3\displaystyle\sum_{i=1}^n x^2_i + 2n\theta^2 \over \theta^4} \]
\[\begin{equation} V(\theta) = -I(\theta)^{-1} = -\Bigg( {-3\displaystyle\sum_{i=1}^n x^2_i + 2n\theta^2 \over \theta^4} \Bigg)^{-1} = { \theta^4 \over 3\displaystyle\sum_{i=1}^n x^2_i - 2n\theta^2 } (\#eq:var) \end{equation}\]vartheta <- function(amostra, that, ...) {
that^4/(3*sum(amostra^2)-2*length(amostra)*that^2)
}Aqui utilizei a informação observada, e não esperada, de Fisher. De qualquer forma, a variância do estimador não foi utilizada, pois o intervalo de confiança foi construído a partir da Deviance, apresentada abaixo.
Intevalo de confiança baseado na razão de verossimilhança
A deviance pode ser escrita como \(D(\theta) = -2log\big({L(\theta|x) \over L(\hat{\theta}|x)}\big)\), tal que \(D(\theta) \sim \chi^2_1\).
\[ D(\theta) = -2log\Bigg({L(\theta|x) \over L(\hat{\theta}|x)}\Bigg) = -2\Big[ lL(\theta) - lL(\hat{\theta}) \Big] = \]
\[ -2 \Bigg[ \displaystyle \sum_{i=1}^n log(x_i) - {\displaystyle \sum_{i=1}^n x^2_i \over 2\theta^2} - 2nlog(\theta) - \Bigg( \displaystyle \sum_{i=1}^n log(x_i) - {\displaystyle \sum_{i=1}^n x^2_i \over 2\hat{\theta}^2} - 2nlog(\hat{\theta}) \Bigg) \Bigg] = \]
\[ -2 \Bigg[ {\displaystyle\sum_{i=1}^n x^2_i \over 2\hat{\theta}^2} - {\displaystyle\sum_{i=1}^n x^2_i \over 2\theta^2} + 2nlog(\hat{\theta}) - 2nlog(\theta) \Bigg] = -2\Bigg[ {\displaystyle\sum_{i=1}^n x^2_i \over 2} \Bigg({1 \over \hat{\theta}^2} - {1 \over \theta^2} \Bigg) + 2nlog\Bigg({\hat{\theta} \over \theta} \Bigg) \Bigg] \]
\[\begin{equation} D(\theta) = \displaystyle\sum_{i=1}^n x^2_i \Bigg( {1 \over \theta^2} - {1 \over \hat{\theta}^2} \Bigg) - 4nlog\Bigg( {\hat{\theta} \over \theta} \Bigg) (\#eq:deviance) \end{equation}\]Portanto os valores de \(\theta\) que resultem em um valor extremo de \(D(\theta)\) (sabendo que \(D(\theta) \sim \chi^2_1\)), serão valores não contidos pelo intervalo de confiança (Figura @ref(fig:deviance)).
devtheta <- function(t, that, amostra, ...) {
  sum(amostra^2)*(1/t^2 - 1/that^2) - 4*length(amostra)*log(that/t)
}set.seed(50)
par(mfrow = c(2, 1))
curve(devtheta(x, that = 40, rfun(30, 40, g)$mcmc), xlim = c(30, 50),
xlab = expression(theta), ylab = 'Deviance',
main = expression(theta*' = 40'))
abline(h = qchisq(0.95, 1), col = 2)
curve(devtheta(x, that = 1, rfun(30, 1, g)$mcmc), xlim = c(0.7, 1.5),
xlab = expression(theta), ylab = 'Deviance',
main = expression(theta*' = 1'))
abline(h = qchisq(0.95, 1), col = 2)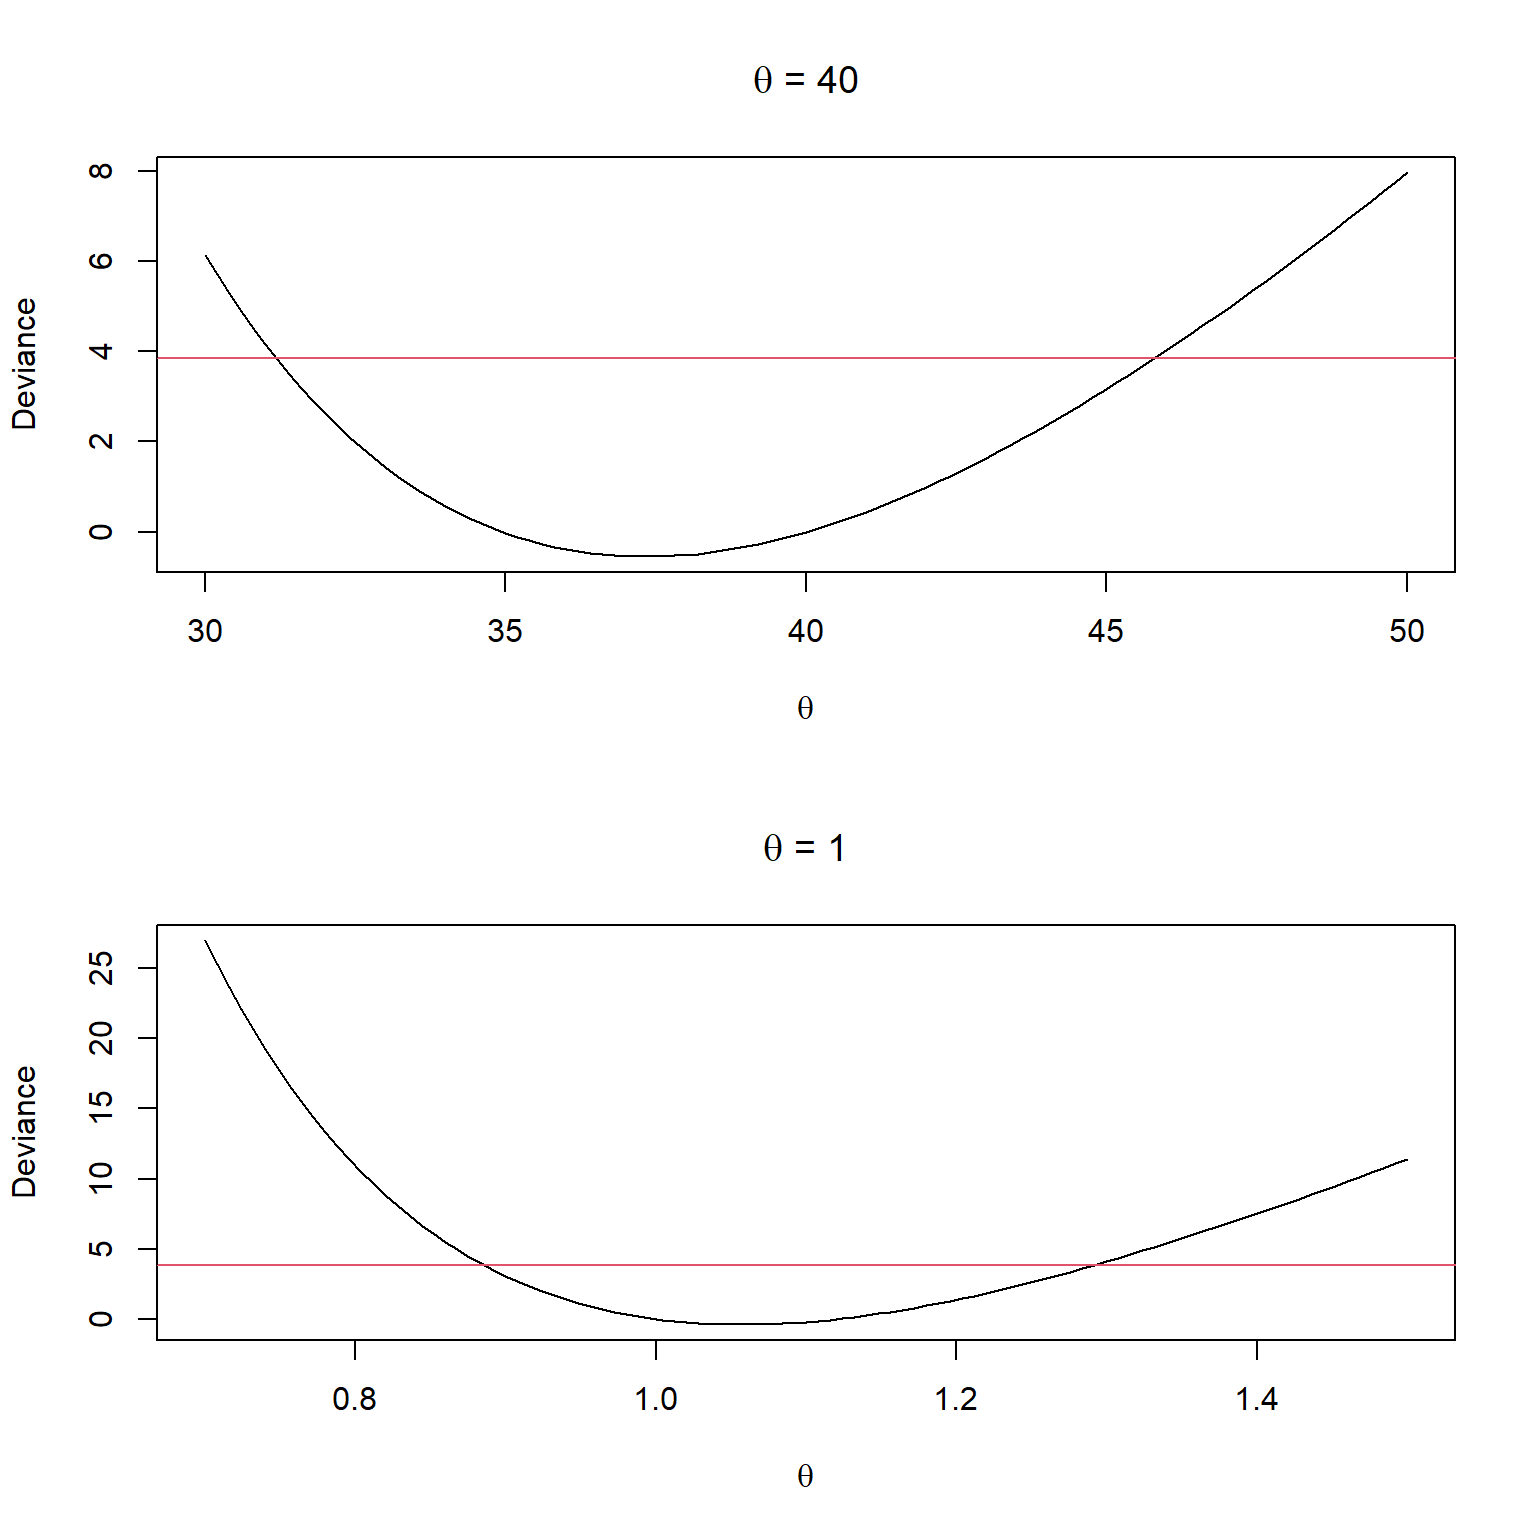
layout(1)ESTUDO DO VIÉS E COBERTURA DE IC PARA \(\theta\).
Foram considerados 2 cenários para a simulação:
\(\theta = 40\);
\(\theta = 1\).
No entanto, em cada cenário foram geradas amostras aleatórias da distribuição escolhida de tamanhos 2 a 30, e depois de 50 a 1000 ao passo de 20, o que totaliza 77 tamanhos de amostra diferentes. De cada uma dessas amostras foram feitas a estimativa pontual do parâmetro (Equação @ref(eq:esttheta)) e delimitação do intervalo de confiança utilizando máxima verossimilhança, jackknife e bootstrap. Além disso, cada uma dessas etapas foi repetida 100 vezes, a fim de avaliar a taxa real de cobertura dos intervalos de confiança por cada método para cada cenário.
A Figura @ref(fig:densidades) apresenta a curva da densidade de probabilidade da função para os dois parâmetros escolhidos. Veja que quando \(\theta = 1\), a curva é muito mais assimétrica e com menor dispersão.
par(mfrow = c(1,2))
curve(dfun(x, theta = 1), col = 4, xlim = c(0, 40),
      xlab = NA, ylab = 'Densidade')
curve(dfun(x, theta = 40), col = 2, add = T)
legend('topright', legend = c(expression(theta*' = 1'), expression(theta*' = 40')),
       col = c(4, 2), bg = 'transparent', bty = 'n', text.col = c(4, 2))

curve(dfun(x, theta = 40), col = 2, xlim = c(0, 120), xlab = NA,
      ylab = 'Densidade')
curve(dfun(x, theta = 1), col = 4, add = T)
legend('topright', legend = c(expression(theta*' = 1'), expression(theta*' = 40')),
       text.col = c(4, 2), bg = 'transparent', bty = 'n')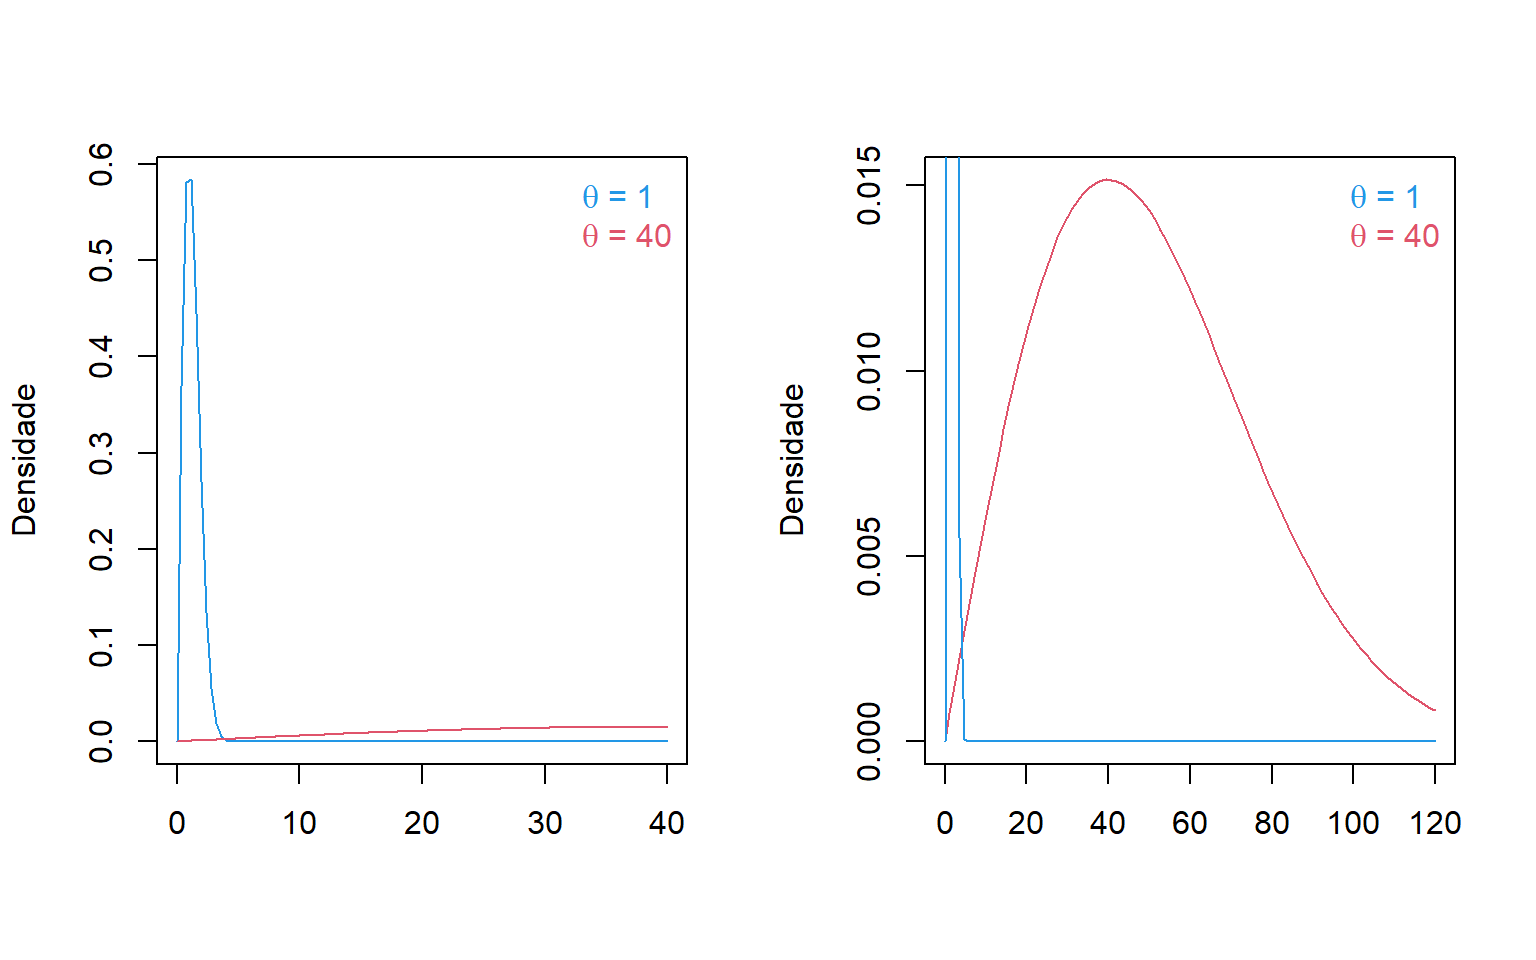
layout(1)set.seed(123)
C1 <- lapply(1:N, function(y) lapply(n, function(x) rfun(n=x, theta = par_C1, dprop = g, thinning = 50)$mcmc))
C2 <- lapply(1:N, function(y) lapply(n, function(x) rfun(n=x, theta = par_C2, dprop = g, thinning = 50)$mcmc))
# Estimativas de theta
that_C1 <- lapply(C1, function(x) sapply(x, esttheta))
that_C2 <- lapply(C2, function(x) sapply(x, esttheta))
# médias de theta estimado para cada tamanho de amostra
media_C1 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) that_C1[[y]][[x]])))
media_C2 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) that_C2[[y]][[x]])))Na Figura @ref(fig:simulacoes) estão os valores estimados de \(\hat{\theta}\) para cada tamanho de amostra e cada uma das 100 realizações de monte carlo. Os paineis à esquerda são um recorte dos da direita, limitando a um tamanho de amostra entre 2 e 30. Veja que conforme aumenta o tamanho de amostra, há uma redução da variabilidade de \(\hat{\theta}\). Ou seja, passamos a ser mais confiantes da nossa estimativa conforme aumenta o tamanho da amostra.
Veja que também que a dispersão das linhas para \(\theta = 40\) é maior que quando \(\theta = 1\). Veja também que de acordo com a equação @ref(eq:var), a variância do estimador depende de seu valor. Portanto maiores valores de \(\theta\) incorrem em uma maior variabilidade em torno de si.
par(mfrow = c(2, 2))

plot(n[1:29], media_C1[1:29], type = 'l', col = 2, ylim= c(0, 80),
     main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)))
foo <- lapply(1:N, function(x) lines(n[1:29], that_C1[[x]][1:29], col='lightgrey'))
abline(h=par_C1, col = 'blue')
lines(n[1:29], media_C1[1:29], type='l', col = 2)

plot(n, media_C1, type = 'l', col = 2, ylim= c(0, 80),
     main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, that_C1[[x]], col='lightgrey'))
abline(h=par_C1, col = 'blue')
lines(n, media_C1, type='l', col = 2)
legend('topright', legend = c('Média', 'Parâmetro', 'Simulações'),
       lty = 1, lwd = 1, col = c('red', 'blue', 'lightgrey'),
       bg = 'transparent', bty = 'n')


plot(n[1:29], media_C2[1:29], type = 'l', col = 2, ylim= c(0, 3),
     main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)))
foo <- lapply(1:N, function(x) lines(n[1:29], that_C2[[x]][1:29], col='lightgrey'))
abline(h=par_C2, col = 'blue')
lines(n[1:29], media_C2[1:29], type='l', col = 2)

plot(n, media_C2, type = 'l', col = 2, ylim= c(0, 3),
     main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, that_C2[[x]], col='lightgrey'))
abline(h=par_C2, col = 'blue')
lines(n, media_C2, type='l', col = 2)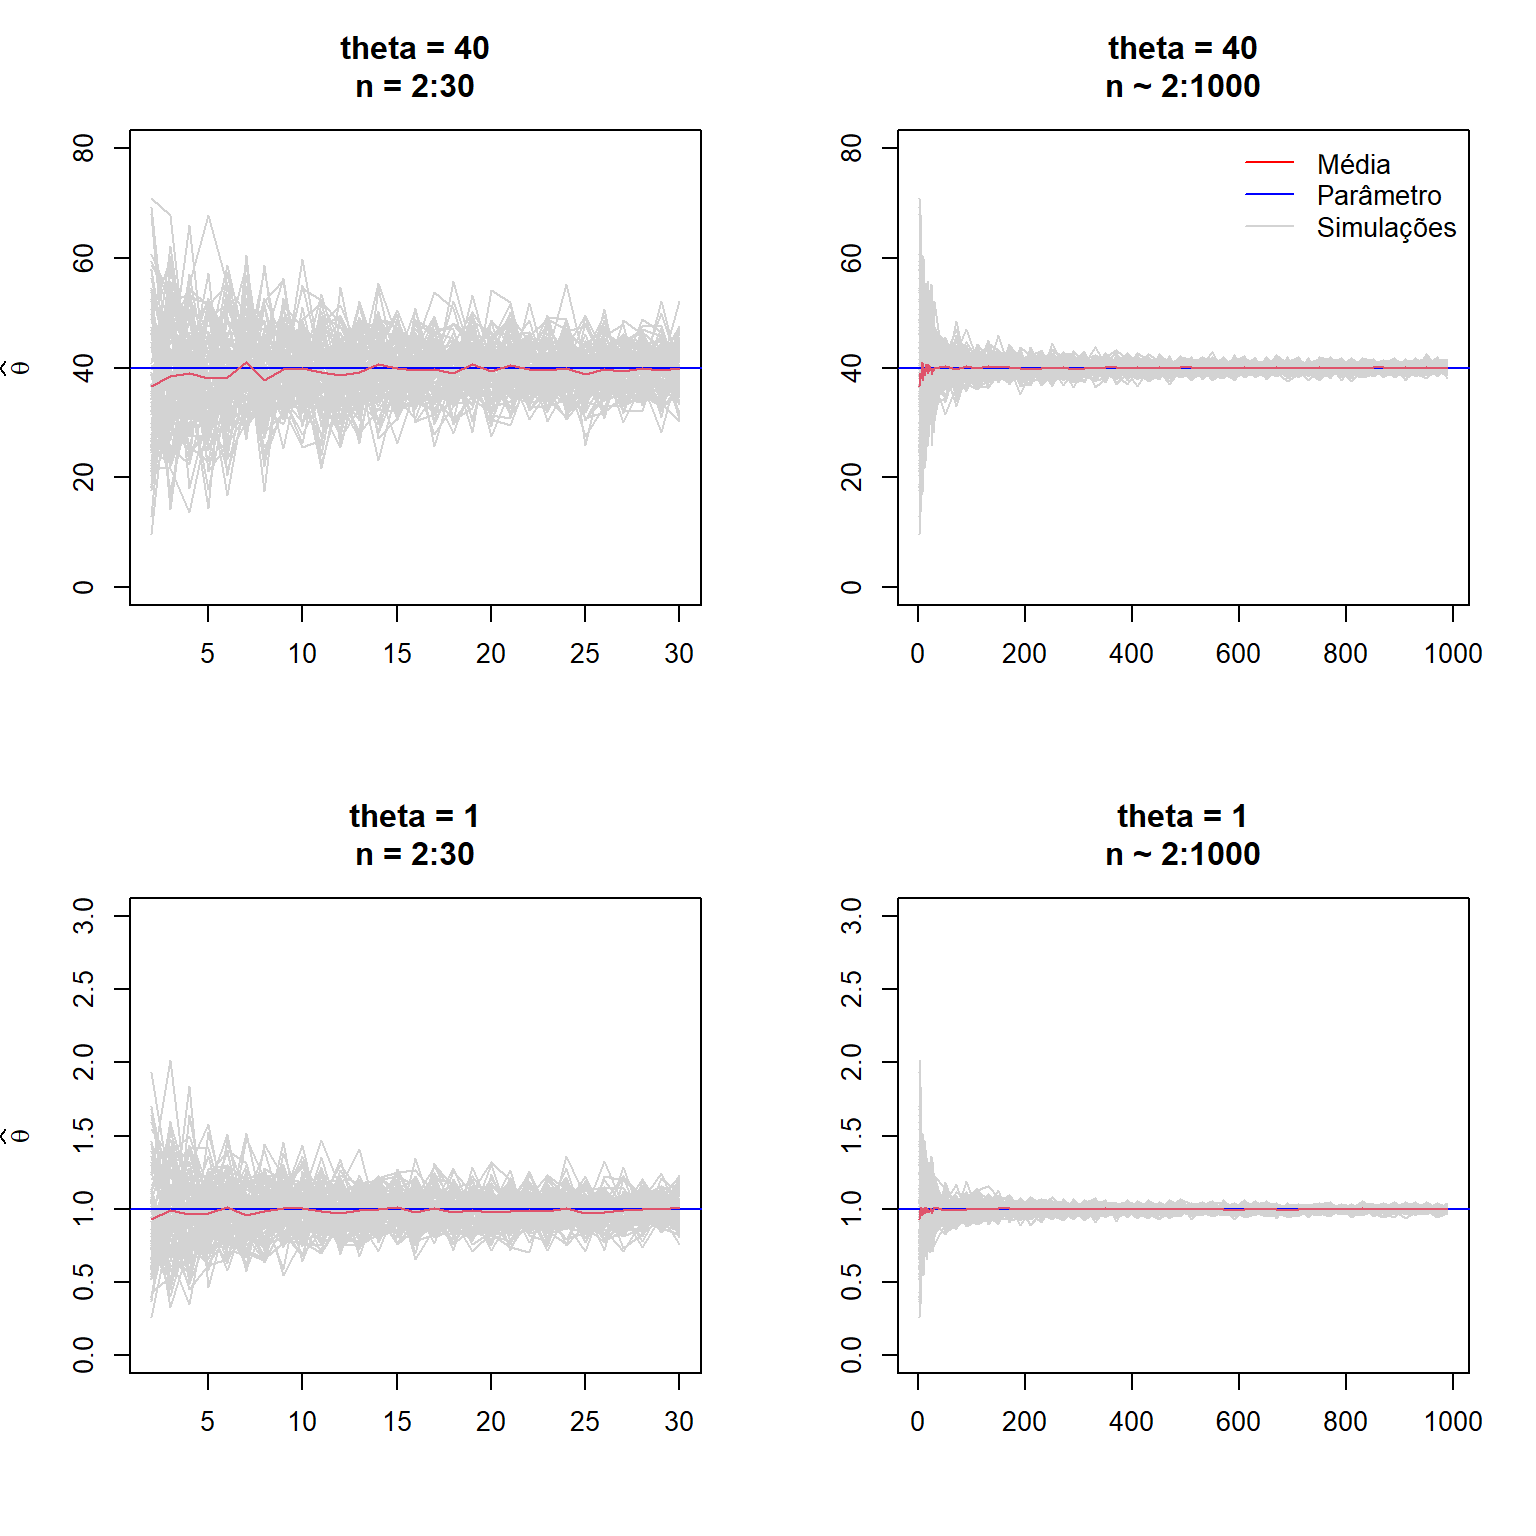
layout(1)Via Máxima Verossimilhança
A partir da função Deviance (Equação @ref(eq:deviance)), podemos calcular o intervalo de confiança da nossa estimativa \(\hat{\theta}\) para cada uma das 100 realizações de Monte Carlo. A Figura @ref(fig:ICLL) mostra esses intervalos para a primeira realização de Monte Carlo. As barras vermelhas representam intervalos que não contiveram o valor verdadeiro (40 e 1, linha azul).
# Utilizando máxima verossimilhança -----------

# Variância de theta
var_LL_C1 <- lapply(1:N, function(y) lapply(1:length(n), function(x) vartheta(amostra = C1[[y]][[x]], that = that_C1[[y]][[x]])))

var_LL_C2 <- lapply(1:N, function(y) lapply(1:length(n), function(x) vartheta(amostra = C2[[y]][[x]], that = that_C2[[y]][[x]])))


# Intervalos de confiança de 95%
require(rootSolve)

IC_LL_C1 <- lapply(1:N, function(j) {lapply(1:length(n),
                                            function(y) {

                                             LI <-  uniroot(f = function(x) {
                                                devtheta(t = x, that = that_C1[[j]][[y]],
                                                         amostra = C1[[j]][[y]]) - qchisq(0.95,1)},
                                                lower = 0.001, upper = that_C1[[j]][[y]])$root

                                             LS <-  uniroot(f = function(x) {
                                                devtheta(t = x, that = that_C1[[j]][[y]],
                                                         amostra = C1[[j]][[y]]) - qchisq(0.95,1)},
                                                lower = that_C1[[j]][[y]], upper = 200)$root

                                             return(c(LI, LS))
                                              }
                                            )
  }
)


IC_LL_C2 <- lapply(1:N, function(j) {lapply(1:length(n), function(y) {

  uniroot.all(f = function(x) {
  devtheta(t = x, that = that_C2[[j]][[y]], amostra = C2[[j]][[y]]) - qchisq(0.95,1)},
                                                                      interval=c(0.0001, 5))

  }
)}
)
contem_C1 <- sapply(IC_LL_C1[[1]], function(x) x[1] < par_C1 & x[2] > par_C1)
contem_C2 <- sapply(IC_LL_C2[[1]], function(x) x[1] < par_C2 & x[2] > par_C2)
par(mfrow = c(2, 2))
plot(n[1:29], media_C1[1:29], type = 'l', ylim= c(0, 80),
main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)),
bg = 'black')
segments(x0 = n[1:29], x1=n[1:29], y0 = sapply(IC_LL_C1[[1]], function(x) x[1])[1:29],
y1 = sapply(IC_LL_C1[[1]], function(x) x[2])[1:29],
col = ifelse(contem_C1, 'green', 'red')[1:29])
abline(h = par_C1, col = 'blue')
plot(n, media_C1, type = 'l', ylim= c(0, 80),
main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
segments(x0 = n, x1=n, y0 = sapply(IC_LL_C1[[1]], function(x) x[1]),
y1 = sapply(IC_LL_C1[[1]], function(x) x[2]),
col = ifelse(contem_C1, 'green', 'red'))
abline(h = par_C1, col = 'blue')
legend('topright', legend = c('Média', 'Parâmetro'), lwd = 1, lty = 1,
col = c('black', 'blue'), bg = 'transparent', bty = 'n')
plot(n[1:29], media_C2[1:29], type = 'l', col = 2, ylim= c(0, 2),
main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)))
segments(x0 = n[1:29], x1=n[1:29], y0 = sapply(IC_LL_C2[[1]], function(x) x[1])[1:29],
y1 = sapply(IC_LL_C2[[1]], function(x) x[2])[1:29],
col = ifelse(contem_C2, 'green', 'red')[1:29])
abline(h = par_C2, col = 'blue')
plot(n, media_C2, type = 'l', col = 2, ylim= c(0, 2),
main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
segments(x0 = n, x1=n, y0 = sapply(IC_LL_C2[[1]], function(x) x[1]),
y1 = sapply(IC_LL_C2[[1]], function(x) x[2]),
col = ifelse(contem_C2, 'green', 'red'))
abline(h = par_C2, col = 'blue')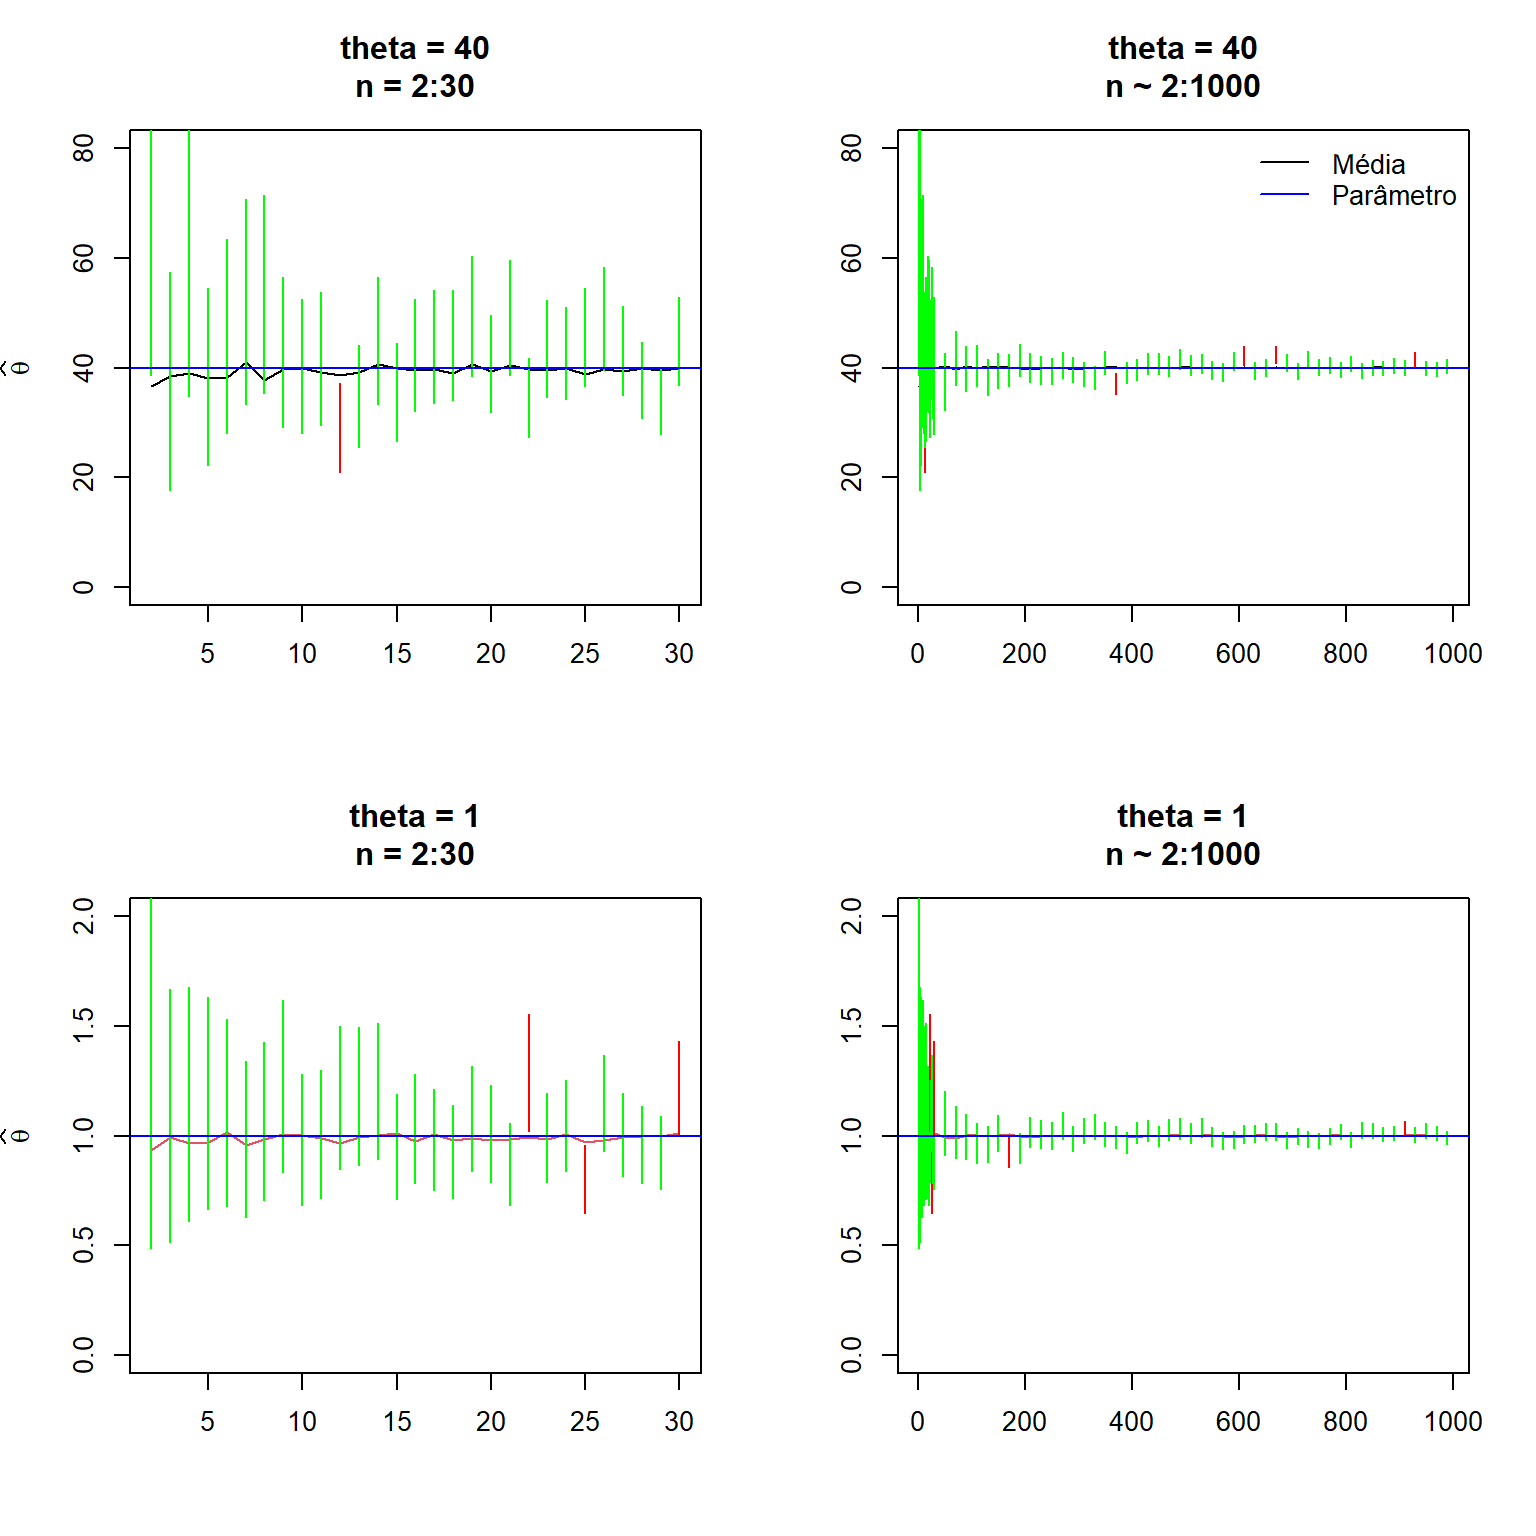
layout(1)Para cada intervalo de confiança dessas figuras, existem outros 99 intervalos construídos via simulação. Como os intervalos são de 95% de confiança, espera-se que 95% dessas 100 realizações contenham o valor verdadeiro. Isso se chama taxa de cobertura do intervalo de confiança (quanto ele realmente é confiável).
A Figura @ref(fig:coberturaLL) apresenta a taxa de cobertura dos intervalos de confiança para os diferentes tamanhos de amostra. Aparentemente os intervalos possuem uma cobertura similar para todo os tamanhos de amostra, mas esse resultado não está muito de acordo com o que se vê na literatura, portanto deve ser verificado com mais calma.
ATENÇÃO: Essa taxa de cobertura está estranha. a taxa de cobertura utilizando bootstrap é o comportamento esperado.
cobertura_LL_C1 <- numeric(length=length(n))
cobertura_LL_C2 <- numeric(length(length(n)))

for (i in 1:length(n)) {

  a <- lapply(IC_LL_C1, '[[', i)
  b <- lapply(IC_LL_C2, '[[', i)


  cobertura_LL_C1[i] <- sum(sapply(a, function(x) x[1] < par_C1 & x[2] > par_C1),
                            na.rm = T)/length(a)
  cobertura_LL_C2[i] <- sum(sapply(b[validos_C2==2], function(x) x[1] < par_C2 & x[2] > par_C2),
                            na.rm = T)/length(b)
}


par(mfrow = c(1, 2))
plot(n, cobertura_LL_C1, main = c('Taxa de cobertura para\ntheta = 40'),
     xlab = 'Tamanho de amostra', ylab = 'Taxa de Cobertura')
abline(h = 0.95, col = 2)

plot(n, cobertura_LL_C2, main = c('Taxa de cobertura para\ntheta = 1'),
     xlab = 'Tamanho de amostra', ylab = 'Taxa de Cobertura')
abline(h = 0.95, col = 2)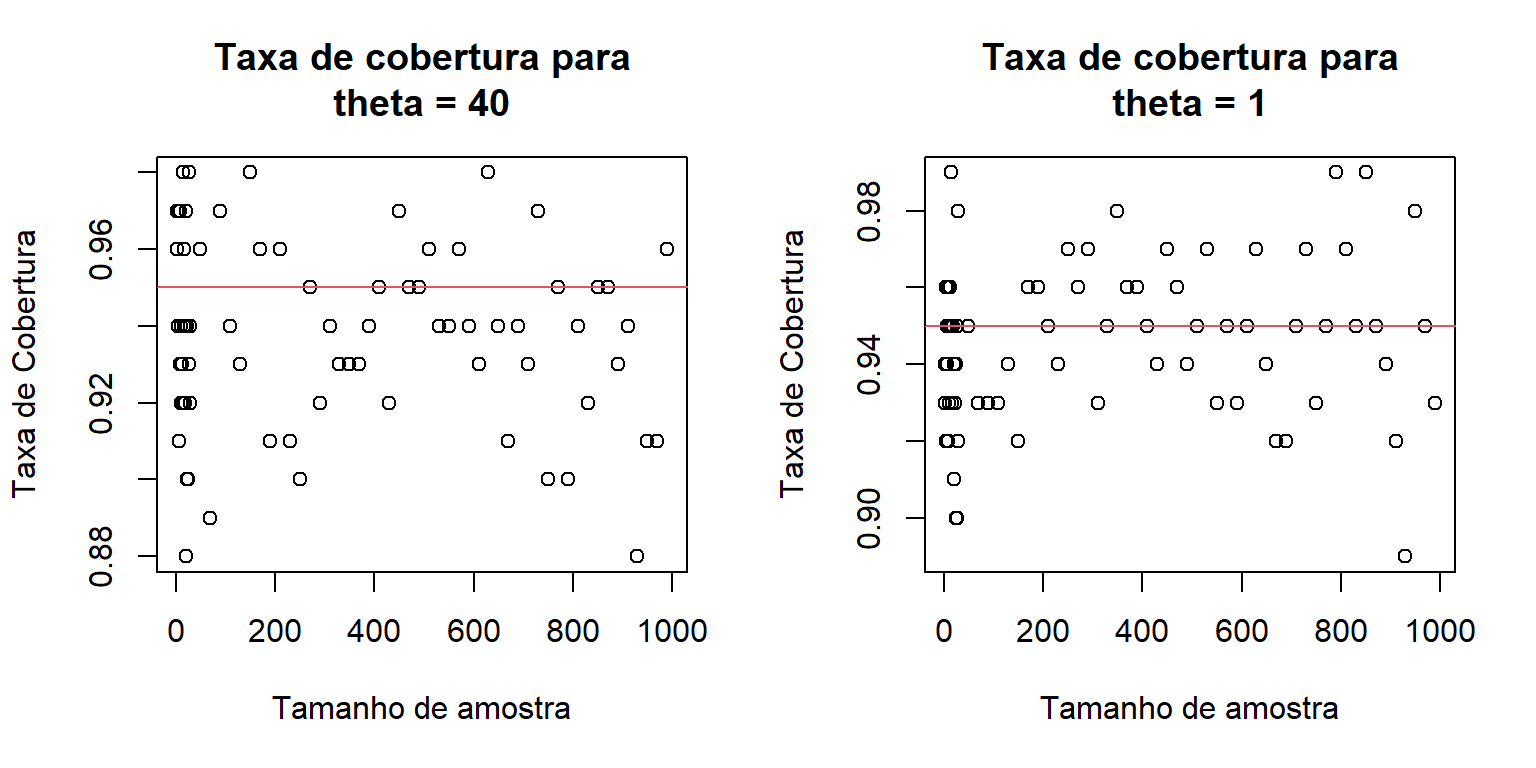
layout(1)Já ná Figura @ref(fig:ViesLL) está o viés de estimativa dos parâmetros para os diferentes tamanhos de amostra. Aparentemente não foi identificado nenhum viés no estimador (lembrando que o estimador de máxima verossimilhança é assintoticamente não viesado).
vies_LL_C1 <- lapply(that_C1, function(x) sapply(x, function(y) y - par_C1))
vies_medio_LL_C1 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_LL_C1[[y]][[x]])))


vies_LL_C2 <- lapply(that_C2, function(x) sapply(x, function(y) y - par_C2))
vies_medio_LL_C2 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_LL_C2[[y]][[x]])))


par(mfrow = c(2, 2))

plot(n[1:29], vies_medio_LL_C1[1:29], type = 'l', col = 2, ylim= c(-40, 40),
     main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_LL_C1[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_LL_C1[1:29], type='l', col = 2)

plot(n, vies_medio_LL_C1, type = 'l', col = 2, ylim= c(-40, 40),
     main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_LL_C1[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_LL_C1, type='l', col = 2)
legend('topright', legend = c('Viés Médio', '0', 'Simulações'),
       lty = 1, lwd = 1, col = c('red', 'blue', 'lightgrey'),
       bg = 'transparent', bty = 'n')


plot(n[1:29], vies_medio_LL_C2[1:29], type = 'l', col = 2, ylim= c(-1.1, 1.1),
     main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_LL_C2[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_LL_C2[1:29], type='l', col = 2)

plot(n, vies_medio_LL_C2, type = 'l', col = 2, ylim= c(-1.1, 1.1),
     main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_LL_C2[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_LL_C2, type='l', col = 2)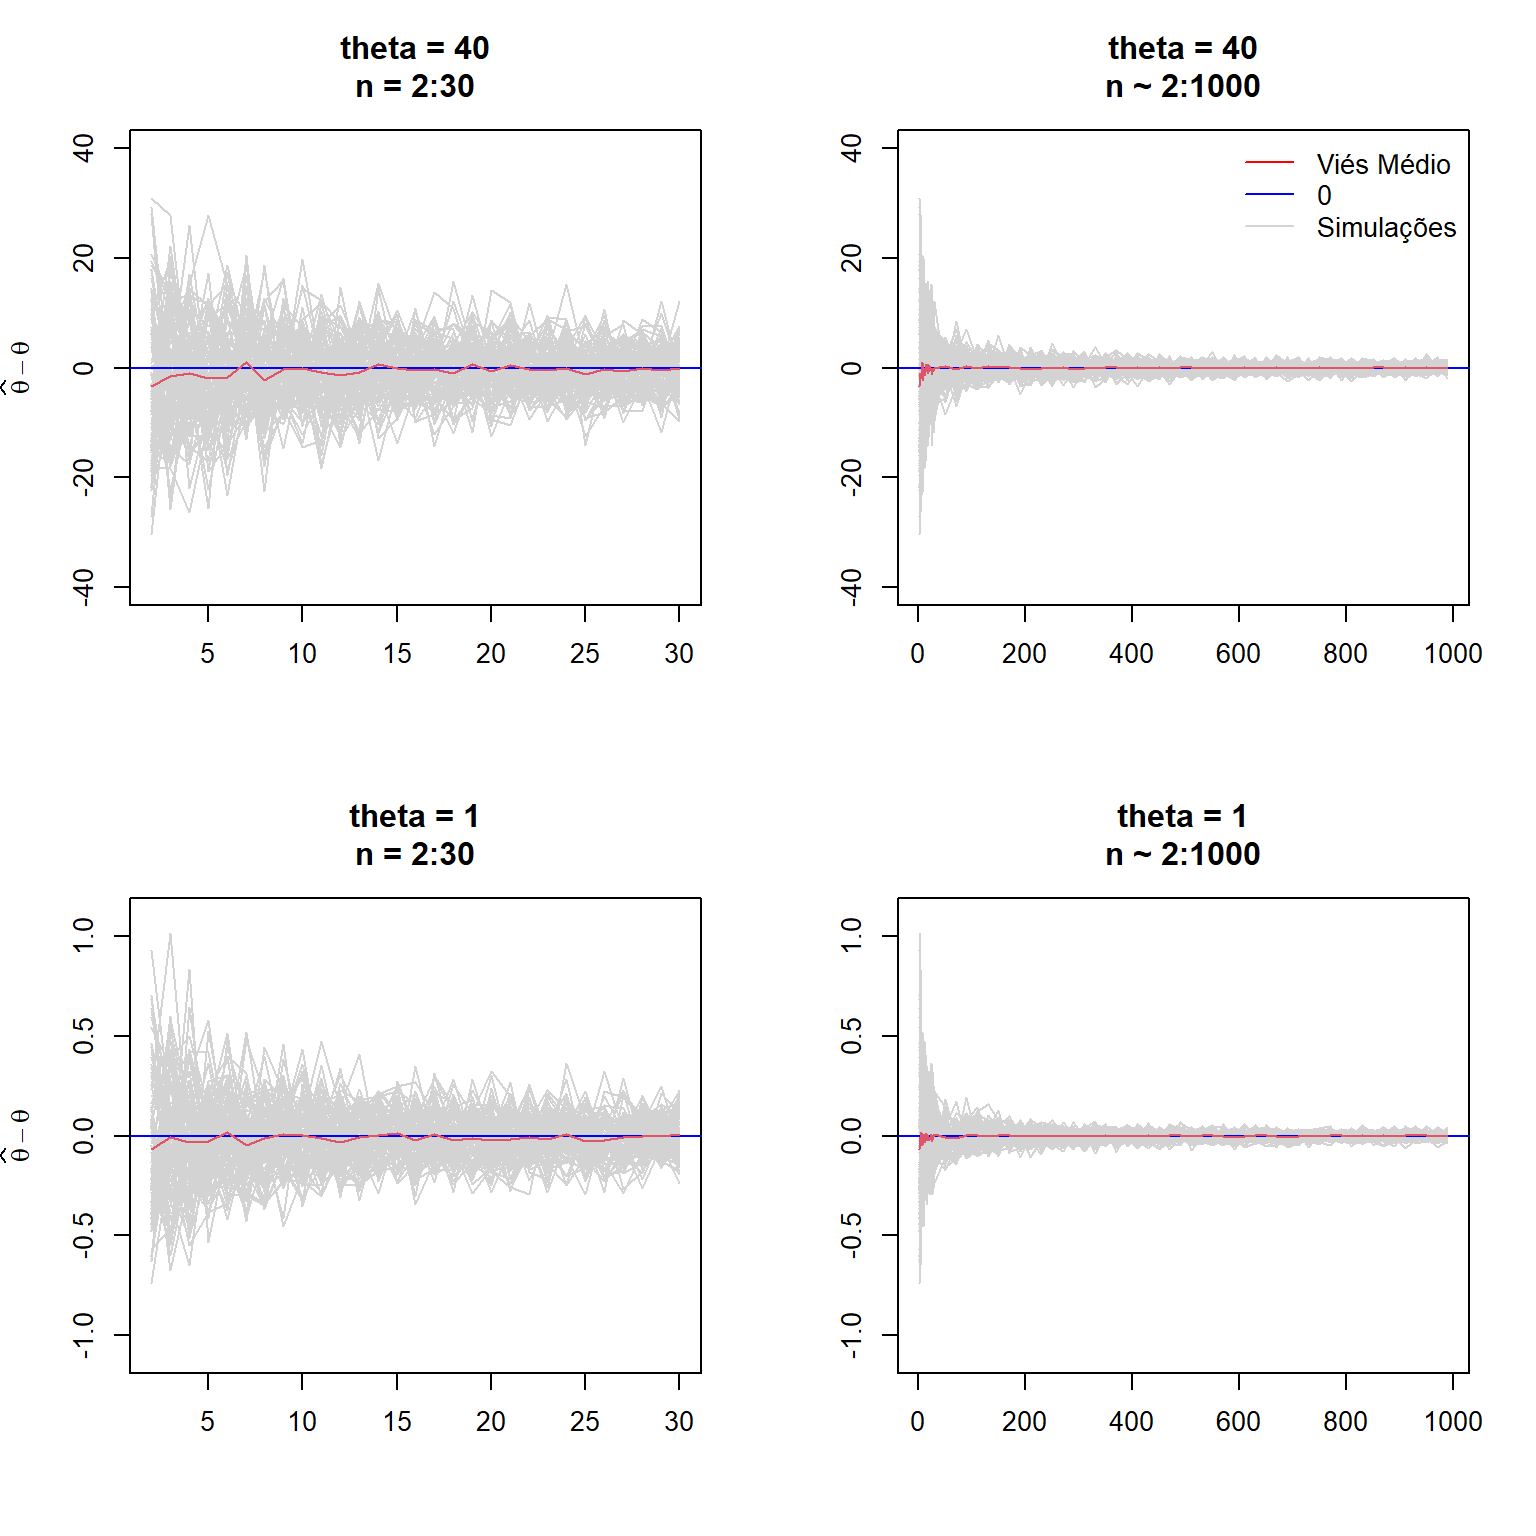
layout(1)Via Jackknife
Seja uma amostra de tamanho \(n = 20\) (\(x_1, x_2, ..., x_n\)), e seja um parâmetro \(\hat{\theta}\) estimado a partir dessas n amostras. A estimativa pontual jackknife consiste em retirar uma observação (a i-ésima) e estimar novamente o parâmetro com as 19 observações restantes, denotado por \(\hat{\theta}^{(i)}\). Repita esse passo retirando uma a uma todas as 20 observações.
\[ \hat{\theta} = f(x_1, x_2, ..., x_n) \]
\[ \hat{\theta}^{(i)} = f(x_1, x_2, ..., x_{i-1}, x_{i+1}, ..., x_n) \]
A seguir, estime os chamados pseudo valores, denotados por \(\hat{\theta}^{*(i)}\), da seguinte forma
\[ \hat{\theta}^{*(i)} = n . \hat{\theta} - (n-1) . \hat{\theta}^{(i)} \]
O estimador pontual jackknife \(\hat{\theta}^*\) será a média dos pseudo valores
\[ \hat{\theta}^* = {\displaystyle\sum_{i=1}^n \hat{\theta}^{*(i)} \over n} \]
O erro padrao do estimador jackknife é dado por
\[ EP[\hat{\theta}^*] = \sqrt{Var[\hat{\theta}^*] \over n} \]
e seu intervalo de confinça pode ser aproximado por uma distribuição t de student se considerarmos que os pseudo valores são independentes. Mais informações sobre jackknife podem ser encontradas aqui.
esttheta_jack <- function(amostra, f, pseudo = F, ...) {
  # amostra: vetor numérico com o conjunto de observações;

  # f: função da estatística desejada para cálculo;

  # pseudo: lógico que indica se os pseudo valores devem ser retornados;

  # ...: outros argumentos passados para f;

  # ---

  # value: se pseudo = F, uma lista contendo a estimativa pontual de Jackknife e a variância estimada do estimador de Jackknife. Se pseudo = T, uma lista igual à anterior mas acrescida dos pseudo valores.

  n <- length(amostra)
  i <- 1:n

  par <- f(amostra, ...)

  val <- sapply(i, function(x) f(amostra[-x], ...), simplify = T)

  pseudovalores <- n*par - (n-1)*val

  est <- mean(pseudovalores)

  var <- var(pseudovalores)/length(pseudovalores)

  if (pseudo) {
    return(list('est' = est, 'var' = var, 'pseudo' = pseudovalores))
  } else {
    return(list('est' = est, 'var' = var))
  }

}
# Utilizando Jackknife --------------
# estimativa pontual
est_jack_C1 <- lapply(C1, function(x) sapply(x, function(y) esttheta_jack(y, f = esttheta)$est))
est_jack_C2 <- lapply(C2, function(x) sapply(x, function(y) esttheta_jack(y, f = esttheta)$est))
# Variância de theta
var_jack_C1 <- lapply(C1, function(x) sapply(x, function(y) esttheta_jack(y, f = esttheta)$var))
var_jack_C2 <- lapply(C2, function(x) sapply(x, function(y) esttheta_jack(y, f = esttheta)$var))
# Intervalos de confiança de 95%
IC_jack_C1 <- lapply(1:N, function(x) {
mapply(function(est, am, var) est + c(LI = -1, LS = 1)*qt(0.975, length(am)-1)*sqrt(var),
est = est_jack_C1[[x]], am = C1[[x]], var = var_jack_C1[[x]])
}
)
IC_jack_C2 <- lapply(1:N, function(x) {
mapply(function(est, am, var) est + c(LI = -1, LS = 1)*qt(0.975, length(am)-1)*sqrt(var),
est = est_jack_C2[[x]], am = C2[[x]], var = var_jack_C2[[x]])
}
)A @ref(fig:estjack) apresenta os intervalos de confiança para uma das 100 realizações de Monte Carlo. A taxa de cobertura (Figura @ref(fig:coberturajack)) mostra um padrão também não muito condizente com o que se vê na literatura.
contem_C1_jack <- apply(IC_jack_C1[[1]], 2, function(x) x[1] < par_C1 & x[2] > par_C1)
contem_C2_jack <- apply(IC_jack_C2[[1]], 2, function(x) x[1] < par_C2 & x[2] > par_C2)


par(mfrow = c(2, 2))

plot(n[1:29], est_jack_C1[[1]][1:29], type = 'l', ylim = c(0, 80),
     main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)))
segments(x0 = n[1:29], x1 = n[1:29],
         y0 = IC_jack_C1[[1]][1, 1:29], y1 = IC_jack_C1[[1]][2, 1:29],
         col = ifelse(contem_C1_jack[1:29], 'green', 'red'))
abline(h = par_C1, col = 'blue')

plot(n, est_jack_C1[[1]], type = 'l', ylim = c(0, 80),
     main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
segments(x0 = n, x1 = n, y0 = IC_jack_C1[[1]][1, ], y1 = IC_jack_C1[[1]][2, ],
         col = ifelse(contem_C1_jack, 'green', 'red'))
abline(h = par_C1, col = 'blue')
legend('topright', legend = c('Média', 'Parâmetro'), lty = 1, lwd = 1,
       col = c('black', 'blue'), bg = 'transparent', bty = 'n')


plot(n[1:29], est_jack_C2[[1]][1:29], type = 'l', ylim = c(0, 3),
     main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)))
segments(x0 = n[1:29], x1 = n[1:29],
         y0 = IC_jack_C2[[1]][1, 1:29], y1 = IC_jack_C2[[1]][2, 1:29],
         col = ifelse(contem_C2_jack[1:29], 'green', 'red'))
abline(h = par_C2, col = 'blue')

plot(n, est_jack_C2[[1]], type = 'l', ylim = c(0, 3),
     main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
segments(x0 = n, x1 = n, y0 = IC_jack_C2[[1]][1, ], y1 = IC_jack_C2[[1]][2, ],
         col = ifelse(contem_C2_jack, 'green', 'red'))
abline(h = par_C2, col = 'blue')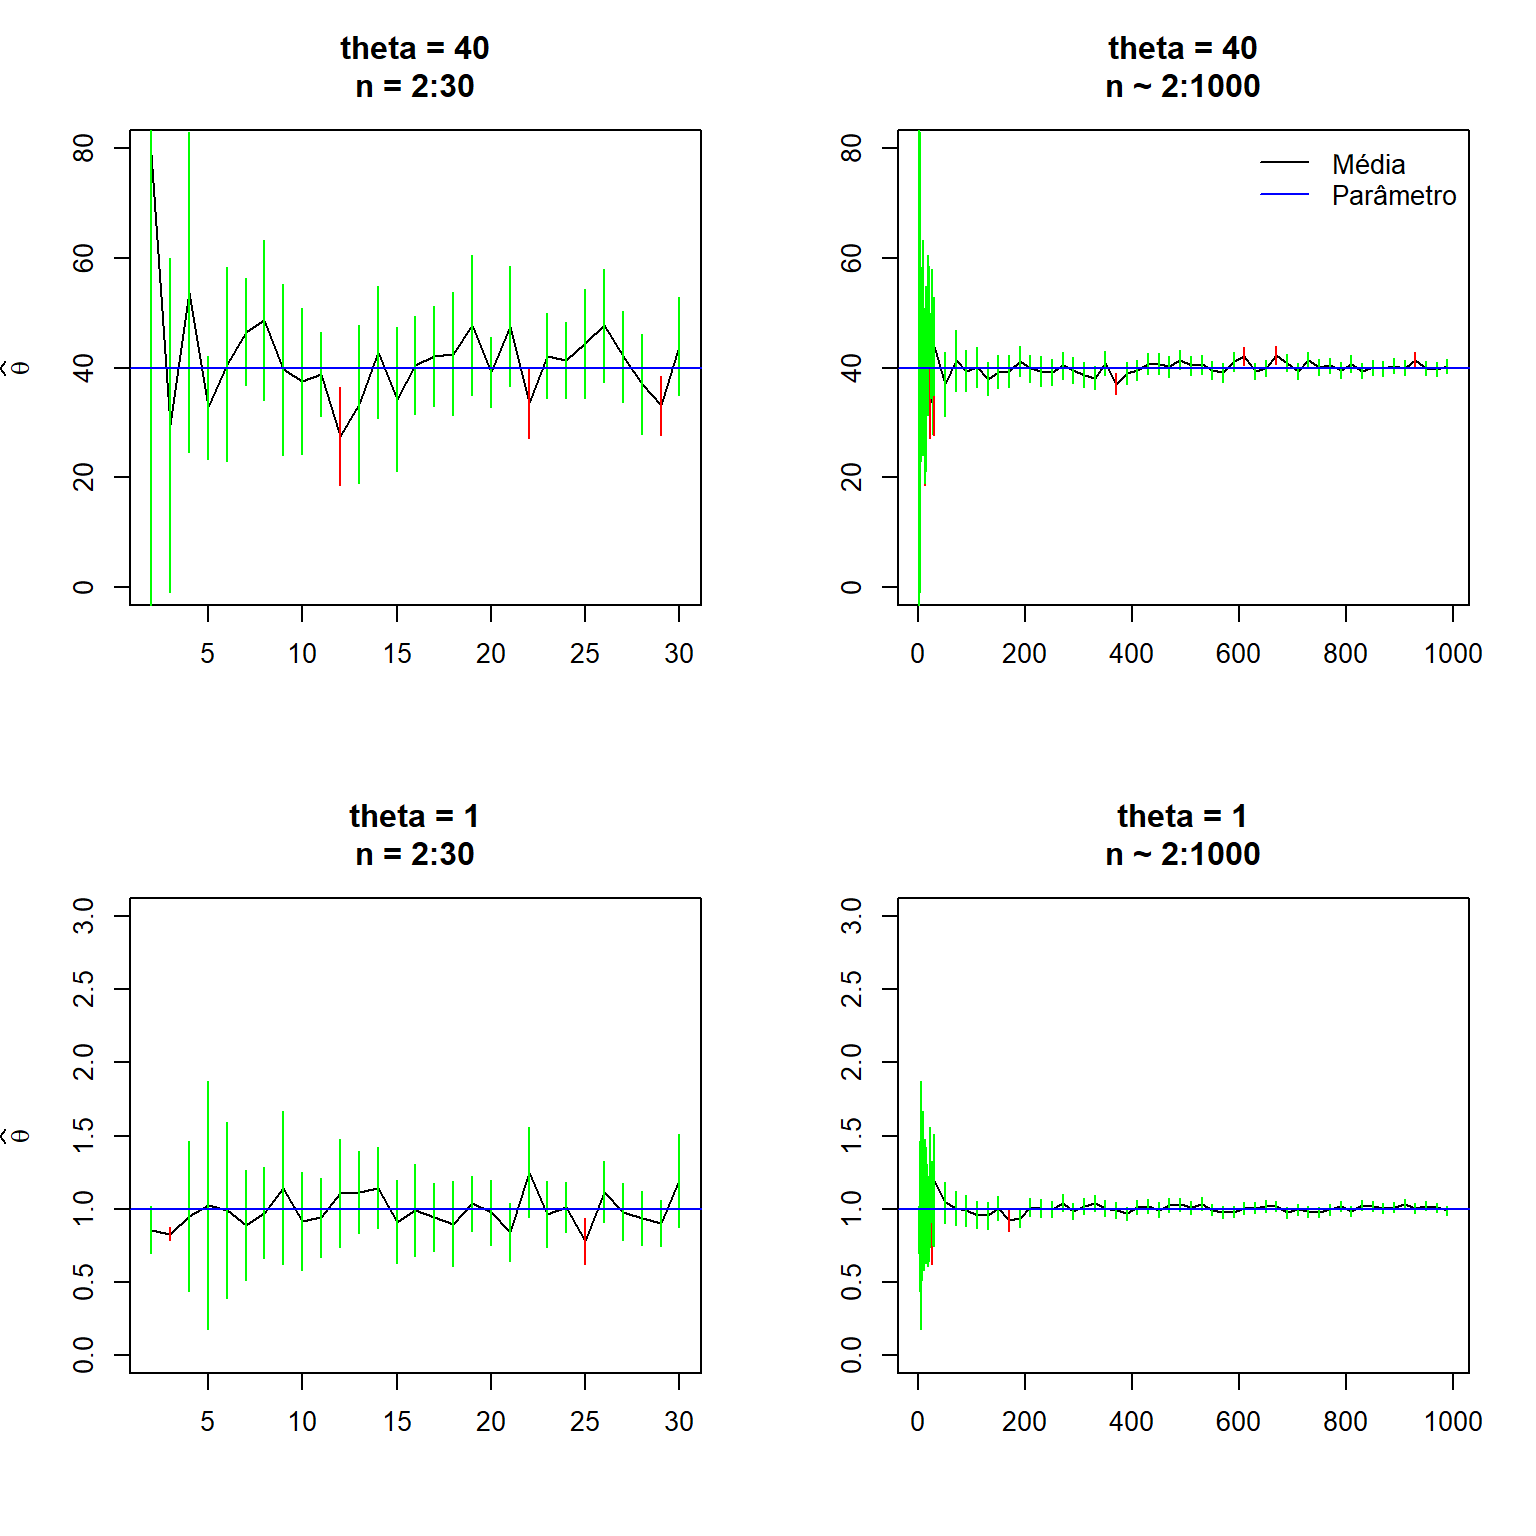
layout(1)ATENÇÃO: Essa taxa de cobertura está estranha. a taxa de cobertura utilizando bootstrap é o comportamento esperado.
cobertura_jack_C1 <- numeric(length=length(n))
cobertura_jack_C2 <- numeric(length(length(n)))

for (i in 1:length(n)) {

  a <- lapply(IC_jack_C1, function(x) x[,i])
  b <- lapply(IC_jack_C2, function(x) x[,i])


  cobertura_jack_C1[i] <- sum(sapply(a, function(x) x[1] < par_C1 & x[2] > par_C1),
                            na.rm = T)/length(a)
  cobertura_jack_C2[i] <- sum(sapply(b, function(x) x[1] < par_C2 & x[2] > par_C2),
                            na.rm = T)/length(b)
}


par(mfrow = c(1, 2))

plot(n, cobertura_jack_C1, main = 'Taxa de cobertura para\ntheta = 40',
     xlab = 'Tamanho de amostra', ylab = 'Taxa de Cobertura')
abline(h = 0.95, col = 2)

plot(n, cobertura_jack_C2, main = 'Taxa de cobertura para\ntheta = 1',
     xlab = 'Tamanho de amostra', ylab = 'Taxa de Cobertura')
abline(h = 0.95, col = 2)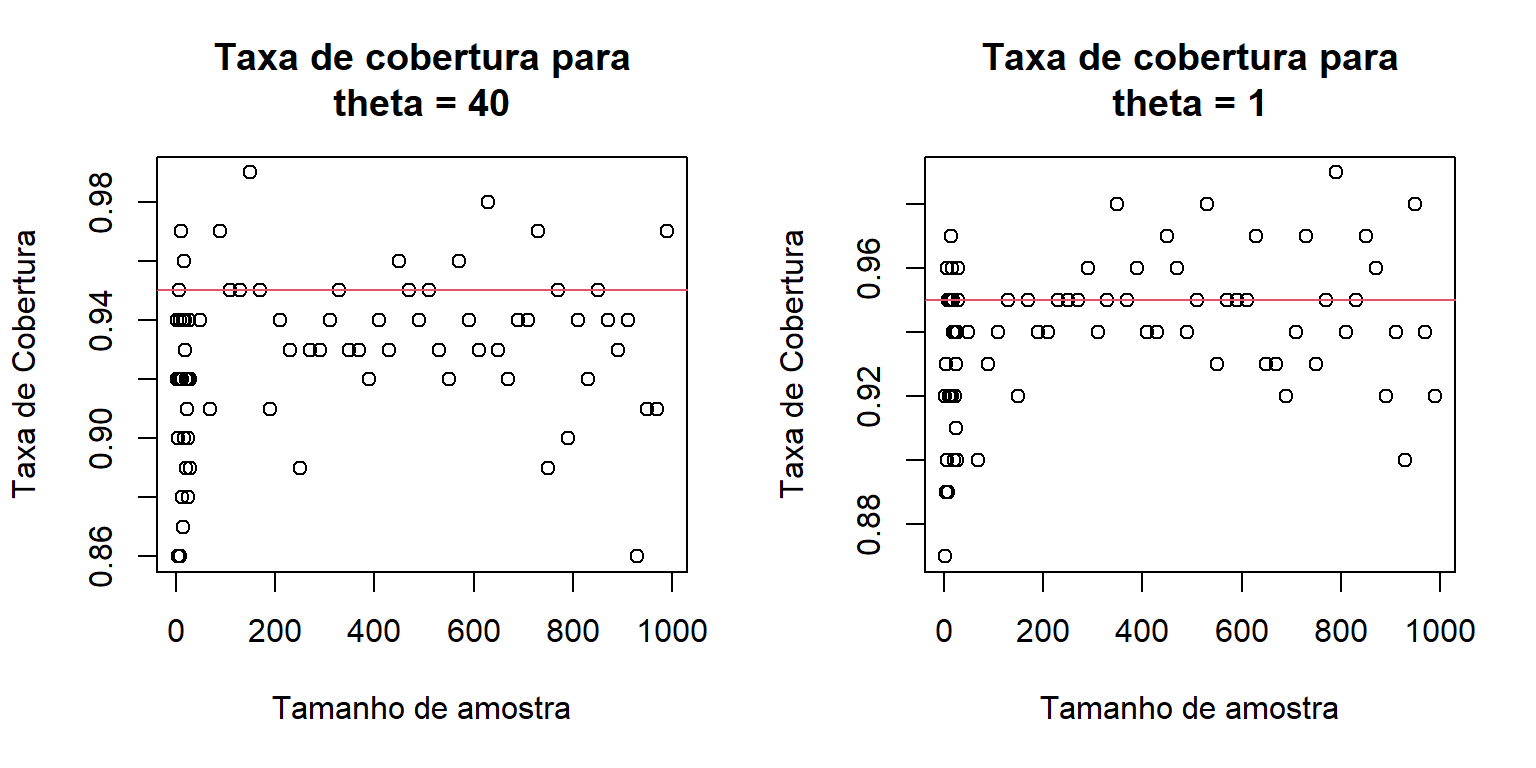
layout(1)vies_jack_C1 <- lapply(est_jack_C1, function(x) sapply(x, function(y) y - par_C1))
vies_medio_jack_C1 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_jack_C1[[y]][[x]])))
vies_jack_C2 <- lapply(est_jack_C2, function(x) sapply(x, function(y) y - par_C2))
vies_medio_jack_C2 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_jack_C2[[y]][[x]])))
par(mfrow = c(2, 2))
plot(n[1:29], vies_medio_jack_C1[1:29], type = 'l', col = 2, ylim= c(-40, 40),
main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_jack_C1[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_jack_C1[1:29], type='l', col = 2)
plot(n, vies_medio_jack_C1, type = 'l', col = 2, ylim= c(-40, 40),
main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_jack_C1[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_jack_C1, type='l', col = 2)
legend('topright', legend = c('Viés Médio', '0', 'Simulações'),
lty = 1, lwd = 1, col = c('red', 'blue', 'lightgrey'),
bg = 'transparent', bty = 'n')
plot(n[1:29], vies_medio_jack_C2[1:29], type = 'l', col = 2, ylim= c(-1.1, 1.1),
main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_jack_C2[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_jack_C2[1:29], type='l', col = 2)
plot(n, vies_medio_jack_C2, type = 'l', col = 2, ylim= c(-1.1, 1.1),
main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_jack_C2[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_jack_C2, type='l', col = 2)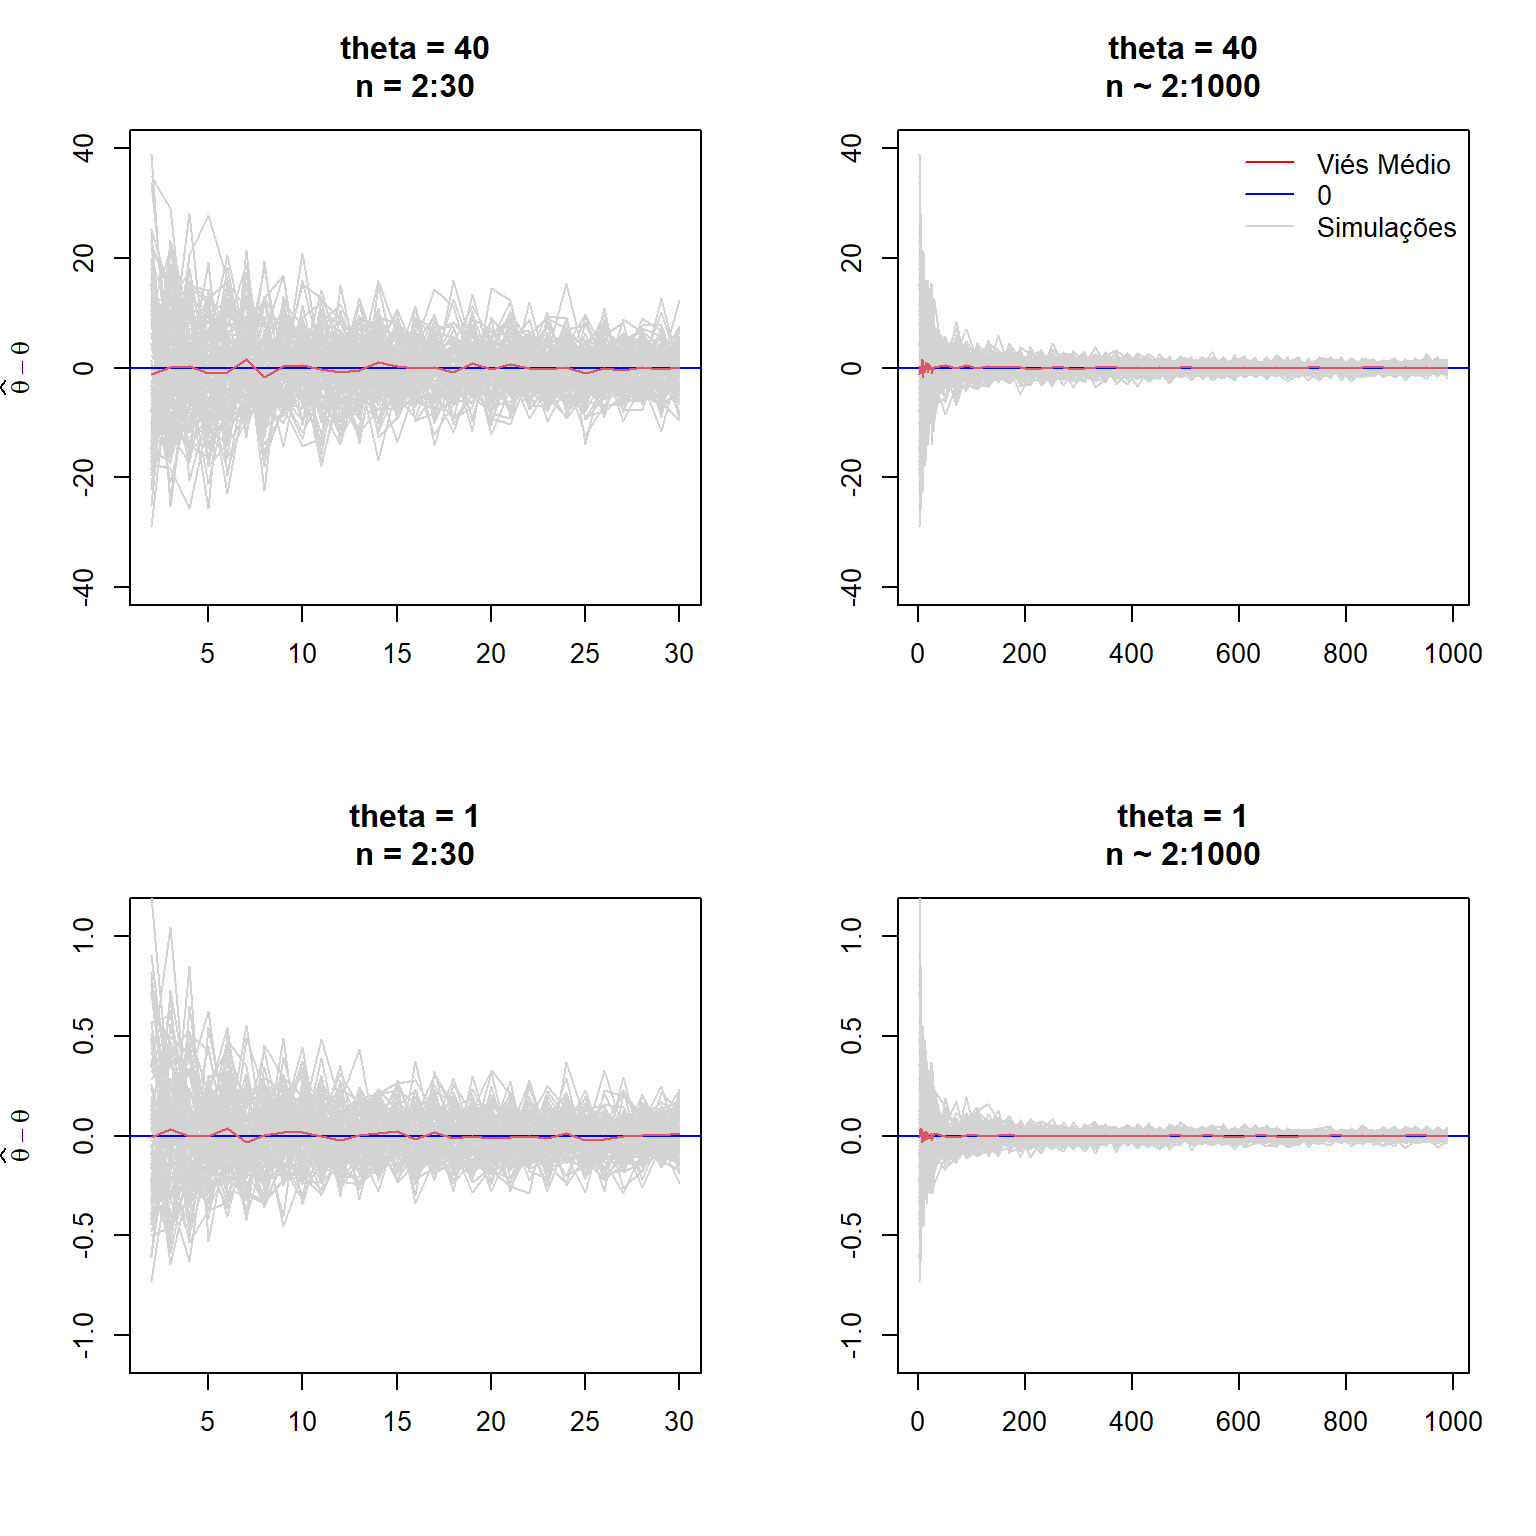
layout(1)Via Bootstrap
O método bootstrap consiste em, dada uma amostra \(x\) de tamanho \(n\) (\(x_1, x_2, ..., x_n\)), faça uma amostragem com reposição de \(x\) com um mesmo tamanho \(n\) e calcule novamente a estatística desejada (nesse caso, \(\hat{\theta}^\)). Repita isso 500, 1000, 2000 ou número grande de vezes. A média de cada uma dessas estimativas de \(\hat{\theta}\) será o estimador pontual bootstrap denotado por \(\hat{\theta}^B\). Um dos intervalos de confiança mais usados é o intervalo básico de bootstrap, que será o utilizado nesse estudo, mesmo que outros dois métodos estejam implementados na função abaixo. Mais informações sobre Bootstrap podem ser encontradas aqui.
boot <- function(n, amostra, f, ...) {
  # amostra: vetor numérico com o conjunto de observações;
  # f: função da estatística desejada para cálculo;
  # ...: outros argumentos passados para f;
  # ---
  # value: vetor numérico com as estimativas de f aplicadas às amostras bootstraps

  replicate(n, f(sample(amostra, replace = T), ...))
}


# estimativa bootstrap corrigida
esttheta_boot <- function(amostra, thetas_boot, f, corr = TRUE, ...) {
  # amostra: vetor numérico com o conjunto de observações
  # thetas_boot: vetor numérico com as estimativas bootstrap do parâmetro
  # f: função da estatística desejada para cálculo
  # corr: lógico que define se será calculada a estimativa corrigida
  # ...: demais argumentos passados para f
  # ---
  # value: escalar com a estimativa bootstrap corrigida

  if (corr) 2*f(amostra, ...) - mean(thetas_boot) else mean(thetas_boot)
}


# Intervalos de confiança bootstrap
boot_IC <- function(amostra, thetas_boot, f, metodo = 'basico',
                    alpha = 0.05, ...) {
  # amostra: vetor numérico com o conjunto de observações
  # thetas_boot: vetor numérico com as estimativas bootstrap do parâmetro
  # f: função da estatística desejada para cálculo
  # metodo: caractere informando o método de intervalo de confiança
  #   desejado. Possíveis valores são 'basico', 'percentil' e 'normal'.
  # alpha: escalar com o nível de significância adotado. Padrão é 0.05
  # ---
  # value: um vetor de comprimento 2 com os limites inferior e superior do IC

  switch(metodo,
         'basico' = {2*f(amostra)-quantile(thetas_boot, c(1-alpha/2, alpha/2))},
         'percentil' = {quantile(thetas_boot, c(alpha/2, 1-alpha/2))},
         'normal' = {f(amostra) + c(-1, 1) * qnorm(1-alpha/2)*sd(thetas_boot)})

}
# Utilizando Bootstrap ---------------
thetas_boot_C1 <- lapply(C1, function(x) lapply(x, function(y) boot(3000, y, f = esttheta)))
thetas_boot_C2 <- lapply(C2, function(x) lapply(x, function(y) boot(3000, y, f = esttheta)))
# Estimativa pontual corrigida
est_boot_C1 <- lapply(1:N, function(x) {
mapply(function(amostra, thetas_boot) esttheta_boot(amostra, thetas_boot, f = esttheta),
amostra = C1[[x]], thetas_boot = thetas_boot_C1[[x]])
}
)
est_boot_C2 <- lapply(1:N, function(x) {
mapply(function(amostra, thetas_boot) esttheta_boot(amostra, thetas_boot, f = esttheta),
amostra = C2[[x]], thetas_boot = thetas_boot_C2[[x]])
}
)
# Variância de theta
var_boot_C1 <- lapply(thetas_boot_C1, function(x) sapply(x, var))
var_boot_C2 <- lapply(thetas_boot_C2, function(x) sapply(x, var))
# Intervalo básico bootstrap para um nível de confiança de 95%
IC_boot_C1 <- lapply(1:N, function(x) {
mapply(function(am, boots) {
boot_IC(amostra = am, thetas_boot = boots,
f = esttheta, metodo = 'basico', alpha = 0.05)},
am = C1[[x]], boots = thetas_boot_C1[[x]]
)})
IC_boot_C2 <- lapply(1:N, function(x) {
mapply(function(am, boots) {
boot_IC(amostra = am, thetas_boot = boots,
f = esttheta, metodo = 'basico', alpha = 0.05)},
am = C2[[x]], boots = thetas_boot_C2[[x]]
)})contem_C1_boot <- apply(IC_boot_C1[[1]], 2, function(x) x[1] < par_C1 & x[2] > par_C1)
contem_C2_boot <- apply(IC_boot_C2[[1]], 2, function(x) x[1] < par_C2 & x[2] > par_C2)
par(mfrow = c(2, 2))
plot(n[1:29], est_boot_C1[[1]][1:29], type='l', ylim = c(0, 80),
main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)))
segments(x0=n[1:29], x1=n[1:29], y0=IC_boot_C1[[1]][1,1:29], y1=IC_boot_C1[[1]][2,1:29],
col = ifelse(contem_C1_boot, 'green', 'red')[1:29])
abline(h = par_C1, col = 'blue')
plot(n, est_boot_C1[[1]], type='l', ylim = c(0, 80),
main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
segments(x0=n, x1=n, y0=IC_boot_C1[[1]][1,], y1=IC_boot_C1[[1]][2,],
col = ifelse(contem_C1_boot, 'green', 'red'))
abline(h = par_C1, col = 'blue')
legend('topright', legend = c('Média', 'Parâmetro'), lty = 1, lwd = 1,
col = c('black', 'blue'), bg = 'transparent', bty = 'n')
plot(n[1:29], est_boot_C2[[1]][1:29], type='l', ylim = c(0, 3),
main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)))
segments(x0=n[1:29], x1=n[1:29], y0=IC_boot_C2[[1]][1,1:29], y1=IC_boot_C2[[1]][2,1:29],
col = ifelse(contem_C2_boot, 'green', 'red')[1:29])
abline(h = par_C2, col = 'blue')
plot(n, est_boot_C2[[1]], type='l', ylim = c(0, 2),
main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
segments(x0=n, x1=n, y0=IC_boot_C2[[1]][1,], y1=IC_boot_C2[[1]][2,],
col = ifelse(contem_C2_boot, 'green', 'red'))
abline(h = par_C2, col = 'blue')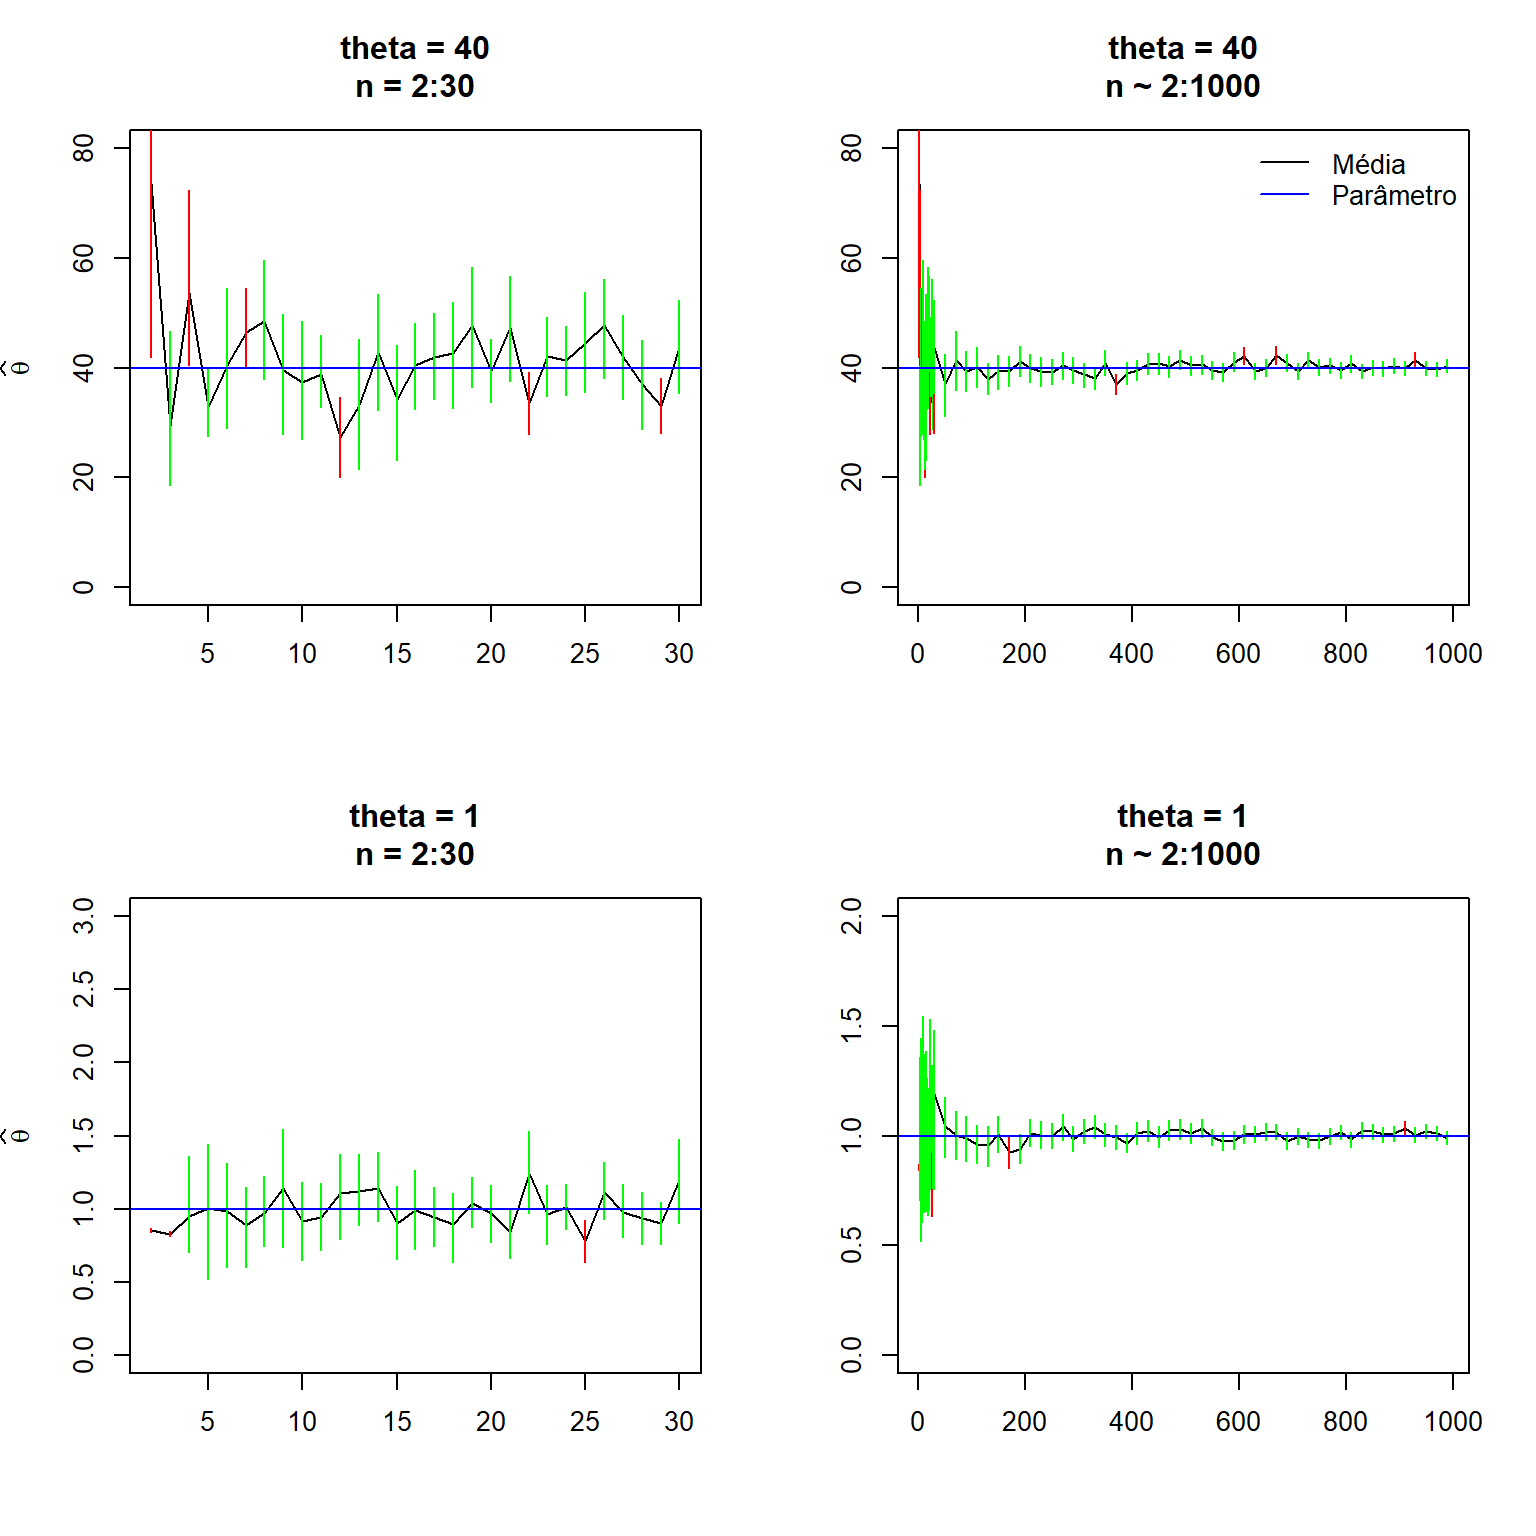
layout(1)Veja que a taxa de cobertura do intervalo de confiança booststrap não é de 95% para pequenas amostras (Figura @ref(fig:coberturaboot)). Porém à medida que o tamanho de amostra aumenta, a taxa de cobertura passa a equivaler o nível de confiança determinado.
cobertura_boot_C1 <- numeric(length=length(n))
cobertura_boot_C2 <- numeric(length(length(n)))

for (i in 1:length(n)) {

  a <- lapply(IC_boot_C1, function(x) x[,i])
  b <- lapply(IC_boot_C2, function(x) x[,i])

  validos_C1 <- sapply(a, length)
  validos_C2 <- sapply(b, length)

  cobertura_boot_C1[i] <- sum(sapply(a[validos_C1==2], function(x) x[1] < par_C1 & x[2] > par_C1),
                            na.rm = T)/sum(validos_C1 == 2)
  cobertura_boot_C2[i] <- sum(sapply(b[validos_C2==2], function(x) x[1] < par_C2 & x[2] > par_C2),
                            na.rm = T)/sum(validos_C2 == 2)
}


par(mfrow = c(1, 2))
plot(n, cobertura_boot_C1, main = 'Taxa de cobertura para\ntheta = 40',
     xlab = 'Tamanho de amostra', ylab = 'Taxa de Cobertura')
abline(h = 0.95, col = 2)

plot(n, cobertura_boot_C2, main = 'Taxa de cobertura para\ntheta = 1',
     xlab = 'Tamanho de amostra', ylab = 'Taxa de Cobertura')
abline(h = 0.95, col = 2)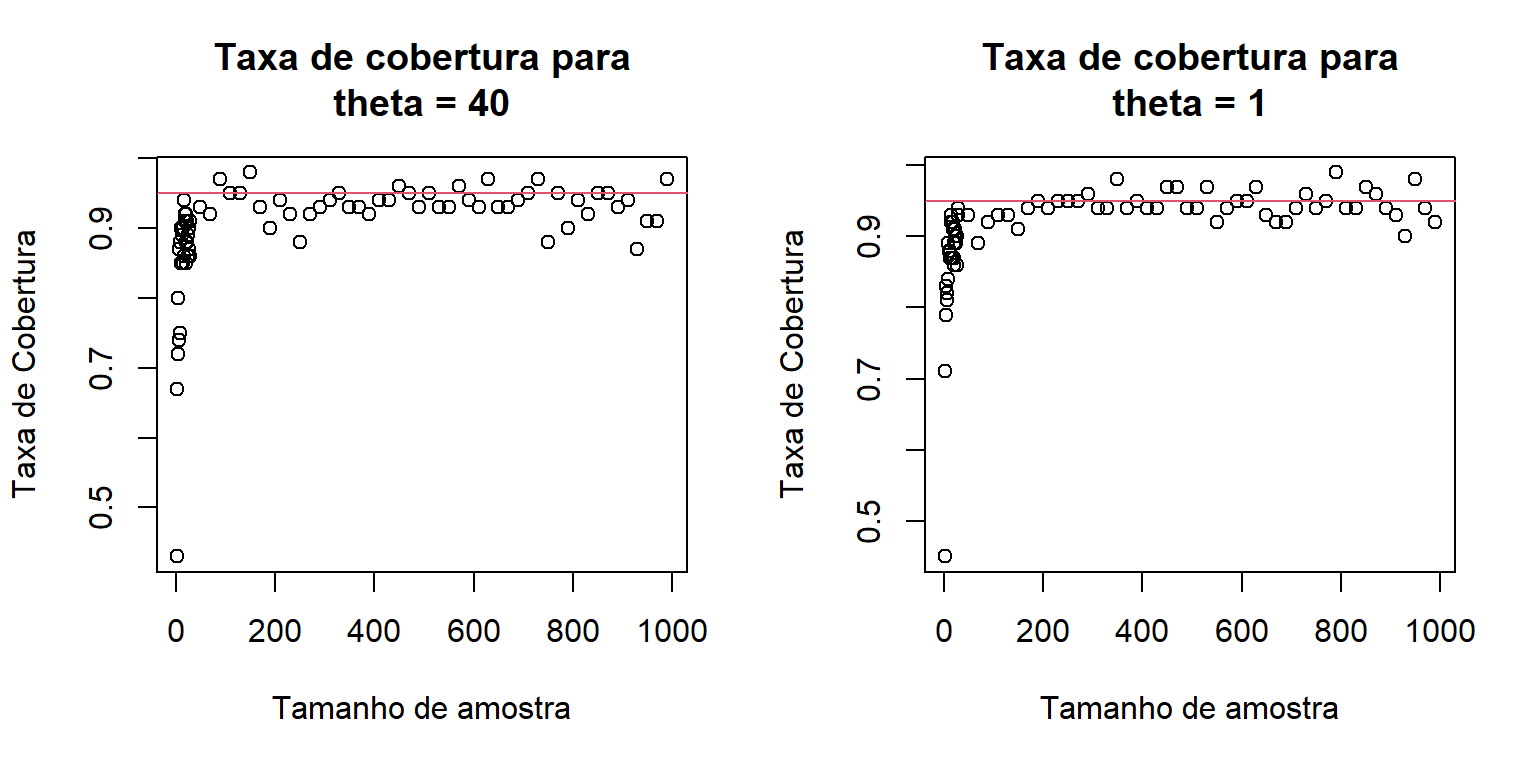
layout(1)As Figuras @ref(fig:viesboot) e @ref(fig:viesboot2) apresentam o viés da estimativa boostrap com e sem correção para o viés. Na Figura @ref(fig:viesboot2) percebe-se que há um viés de subestimativa de \(\theta\), portanto a correção é necessária para uma estimativa não viesada de \(\theta\).
vies_boot_C1 <- lapply(est_boot_C1, function(x) sapply(x, function(y) y - par_C1))
vies_medio_boot_C1 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_boot_C1[[y]][[x]])))


vies_boot_C2 <- lapply(est_boot_C2, function(x) sapply(x, function(y) y - par_C2))
vies_medio_boot_C2 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_boot_C2[[y]][[x]])))


par(mfrow = c(2, 2))

plot(n[1:29], vies_medio_boot_C1[1:29], type = 'l', col = 2, ylim= c(-40, 40),
     main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_boot_C1[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_boot_C1[1:29], type='l', col = 2)

plot(n, vies_medio_boot_C1, type = 'l', col = 2, ylim= c(-40, 40),
     main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_boot_C1[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_boot_C1, type='l', col = 2)
legend('topright', legend = c('Viés Médio', '0', 'Simulações'),
       lty = 1, lwd = 1, col = c('red', 'blue', 'lightgrey'),
       bg = 'transparent', bty = 'n')


plot(n[1:29], vies_medio_boot_C2[1:29], type = 'l', col = 2, ylim= c(-1.1, 1.1),
     main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_boot_C2[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_boot_C2[1:29], type='l', col = 2)

plot(n, vies_medio_boot_C2, type = 'l', col = 2, ylim= c(-1.1, 1.1),
     main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_boot_C2[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_boot_C2, type='l', col = 2)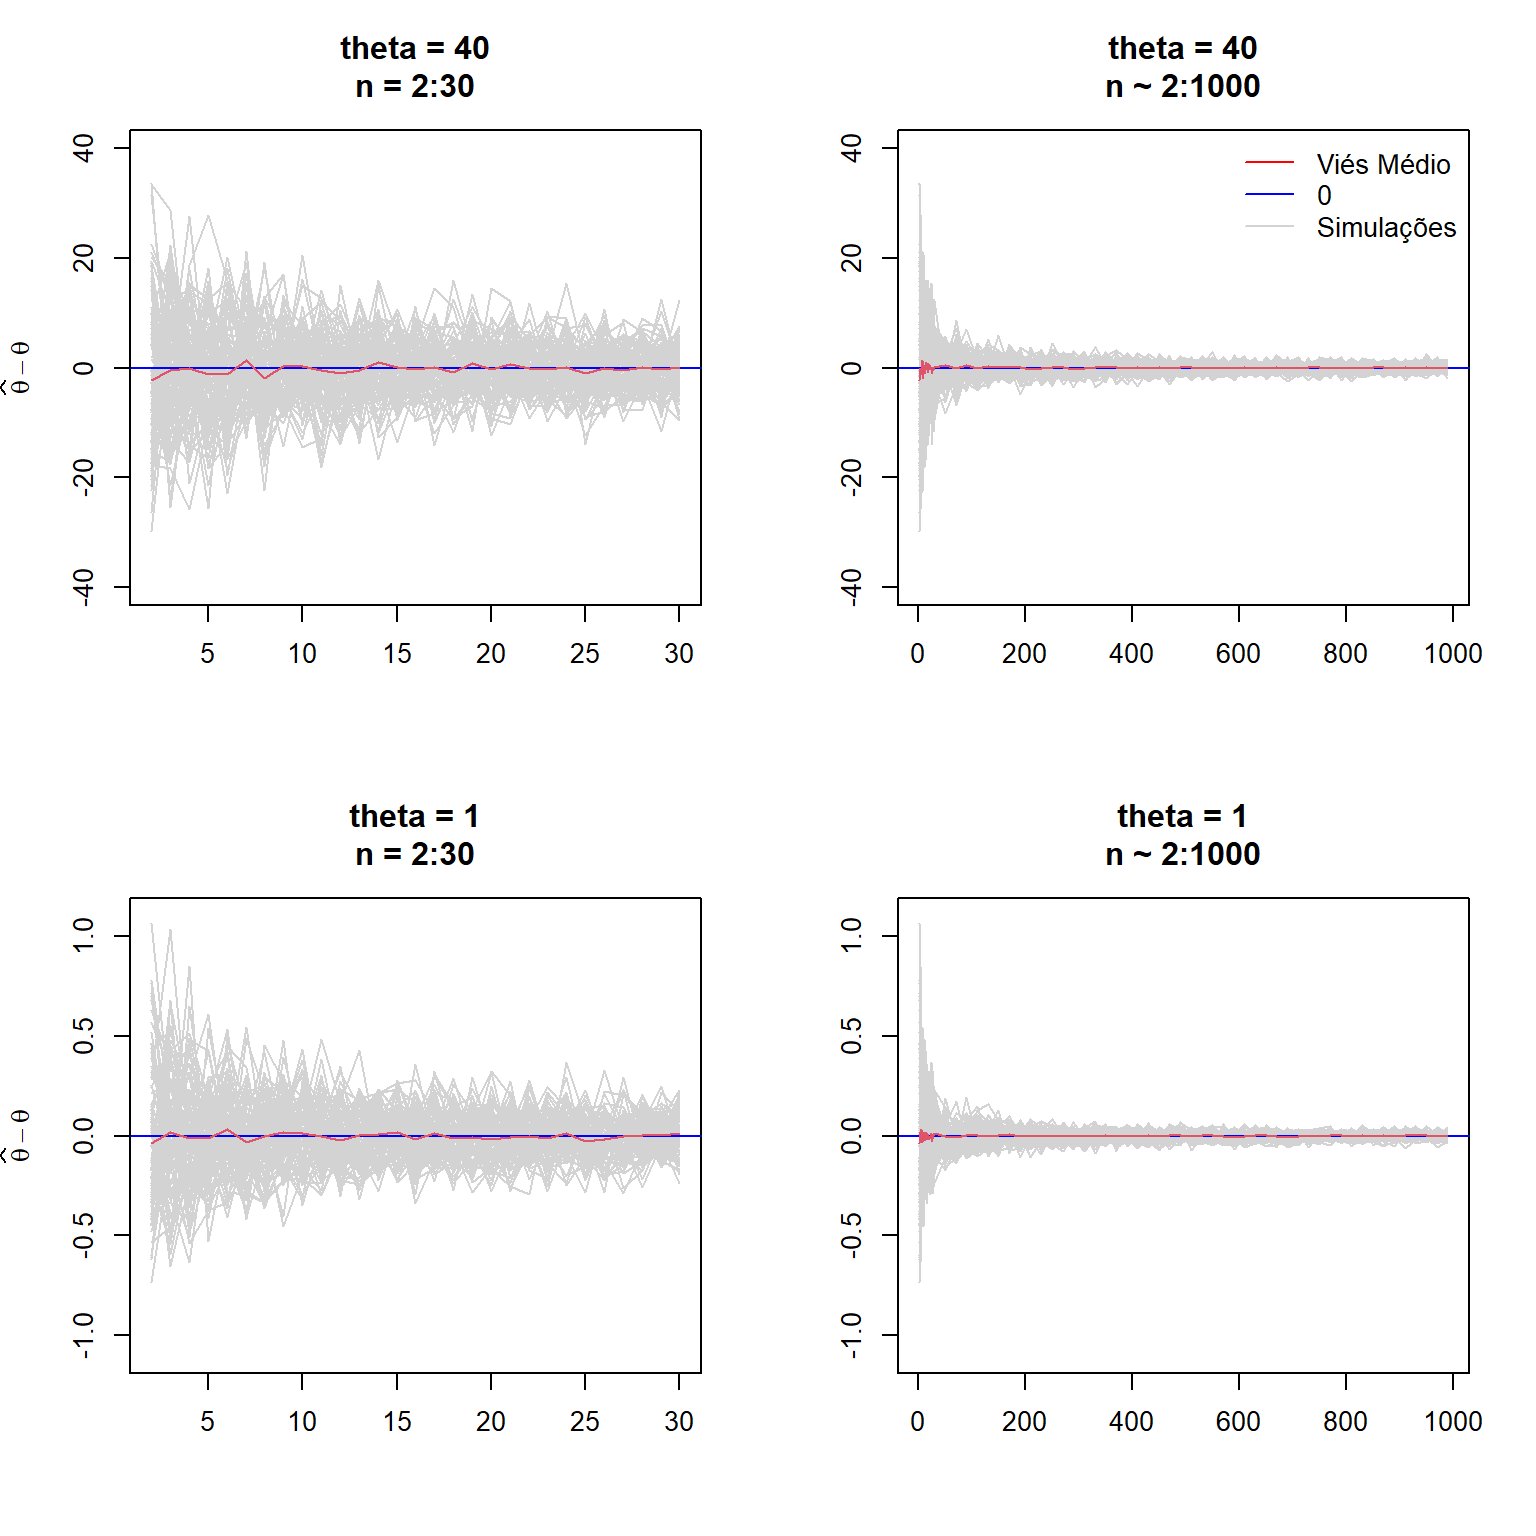
layout(1)# Estimativa pontual NÃO corrigida
est_boot_C1 <- lapply(1:N, function(x) {
mapply(function(amostra, thetas_boot) esttheta_boot(amostra, thetas_boot, f = esttheta, corr = FALSE),
amostra = C1[[x]], thetas_boot = thetas_boot_C1[[x]])
}
)
est_boot_C2 <- lapply(1:N, function(x) {
mapply(function(amostra, thetas_boot) esttheta_boot(amostra, thetas_boot, f = esttheta, corr = FALSE),
amostra = C2[[x]], thetas_boot = thetas_boot_C2[[x]])
}
)
vies_boot_C1 <- lapply(est_boot_C1, function(x) sapply(x, function(y) y - par_C1))
vies_medio_boot_C1 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_boot_C1[[y]][[x]])))
vies_boot_C2 <- lapply(est_boot_C2, function(x) sapply(x, function(y) y - par_C2))
vies_medio_boot_C2 <- sapply(1:length(n), function(x) mean(sapply(1:N, function(y) vies_boot_C2[[y]][[x]])))
par(mfrow = c(2, 2))
plot(n[1:29], vies_medio_boot_C1[1:29], type = 'l', col = 2, ylim= c(-40, 40),
main = 'theta = 40\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_boot_C1[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_boot_C1[1:29], type='l', col = 2)
plot(n, vies_medio_boot_C1, type = 'l', col = 2, ylim= c(-40, 40),
main = 'theta = 40\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_boot_C1[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_boot_C1, type='l', col = 2)
legend('topright', legend = c('Viés Médio', '0', 'Simulações'),
lty = 1, lwd = 1, col = c('red', 'blue', 'lightgrey'),
bg = 'transparent', bty = 'n')
plot(n[1:29], vies_medio_boot_C2[1:29], type = 'l', col = 2, ylim= c(-1.1, 1.1),
main = 'theta = 1\nn = 2:30', xlab = NA, ylab = expression(widehat(theta)-theta))
foo <- lapply(1:N, function(x) lines(n[1:29], vies_boot_C2[[x]][1:29], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n[1:29], vies_medio_boot_C2[1:29], type='l', col = 2)
plot(n, vies_medio_boot_C2, type = 'l', col = 2, ylim= c(-1.1, 1.1),
main = 'theta = 1\nn ~ 2:1000', xlab = NA, ylab = NA)
foo <- lapply(1:N, function(x) lines(n, vies_boot_C2[[x]], col='lightgrey'))
abline(h=0, col = 'blue')
lines(n, vies_medio_boot_C2, type='l', col = 2)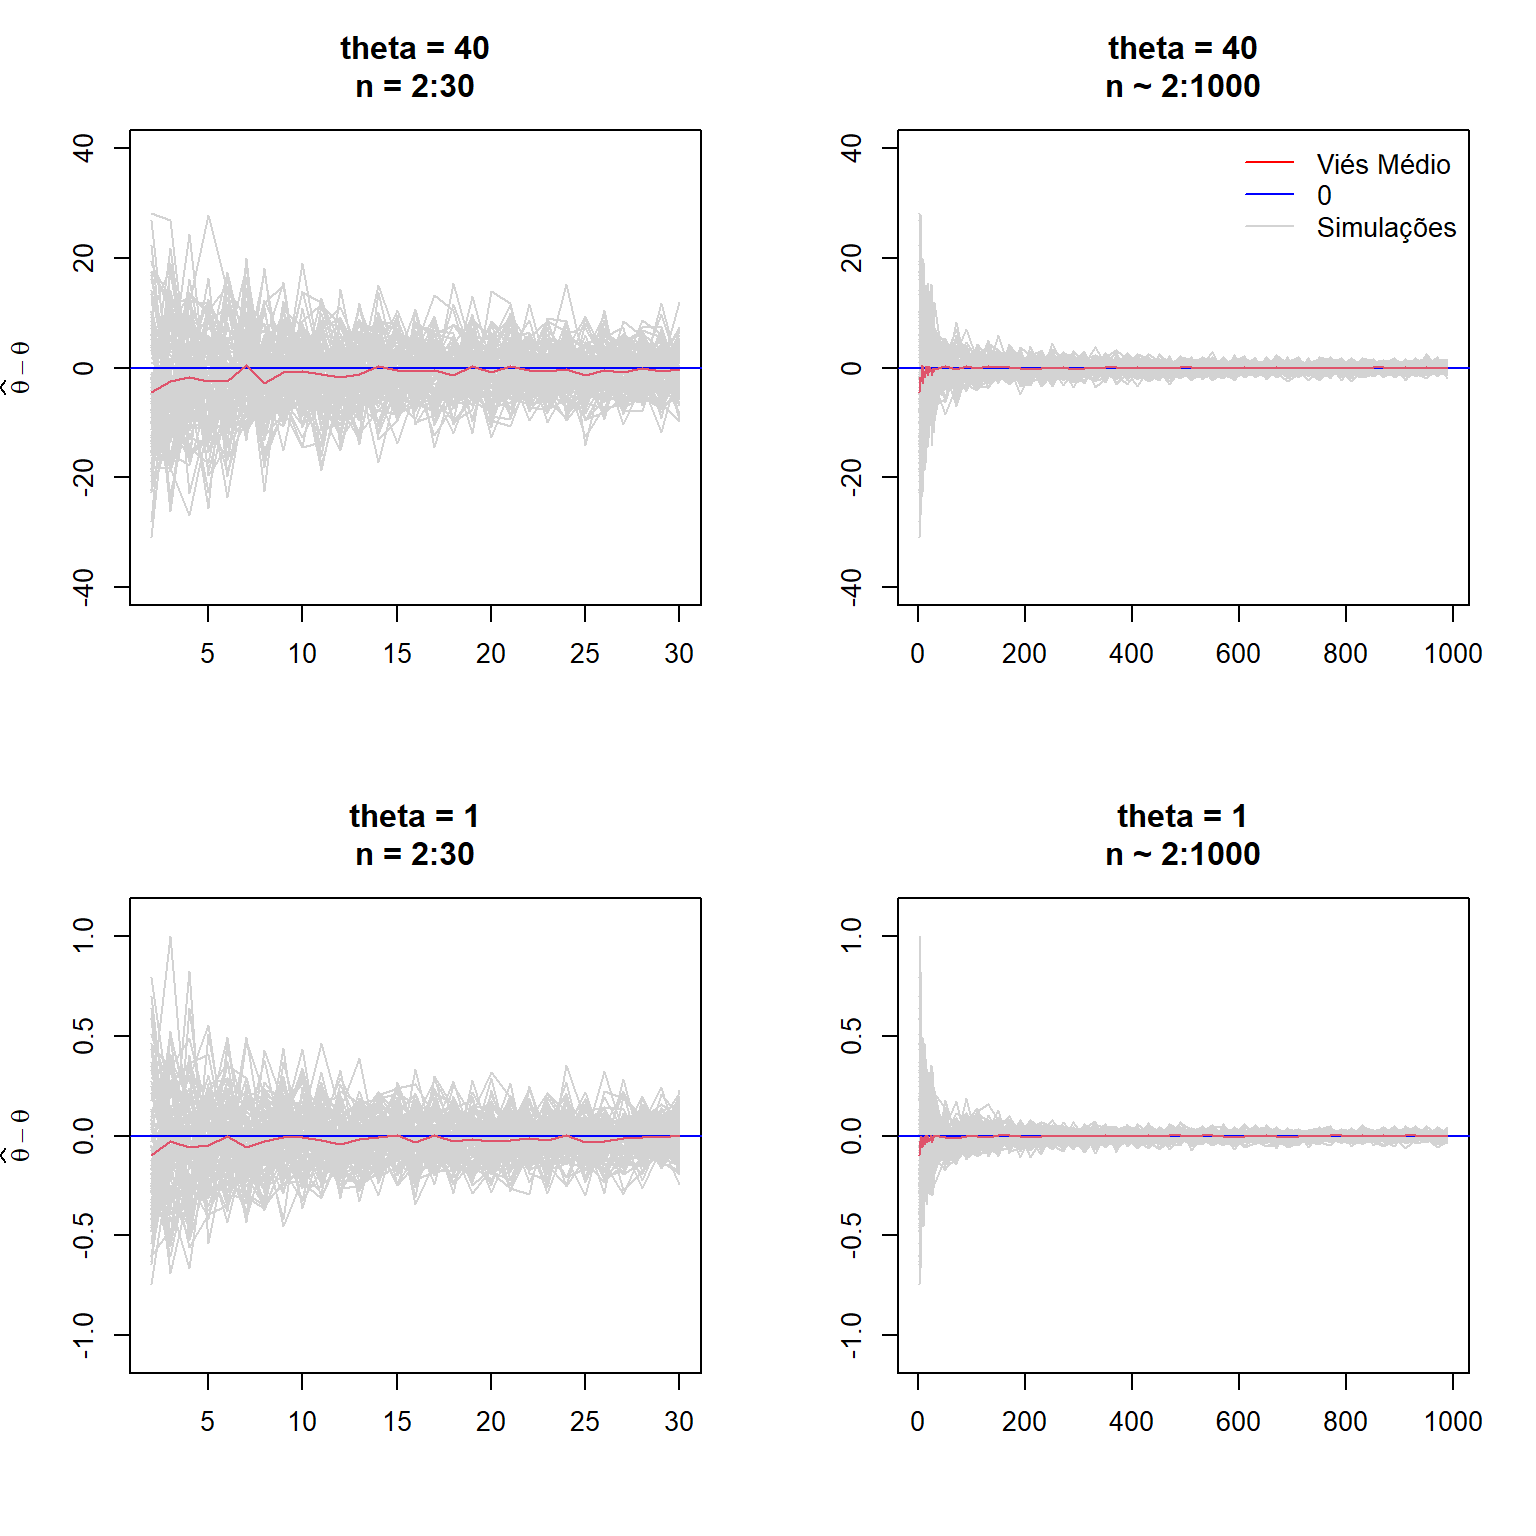
layout(1)


# save.image('./imagem.RData')