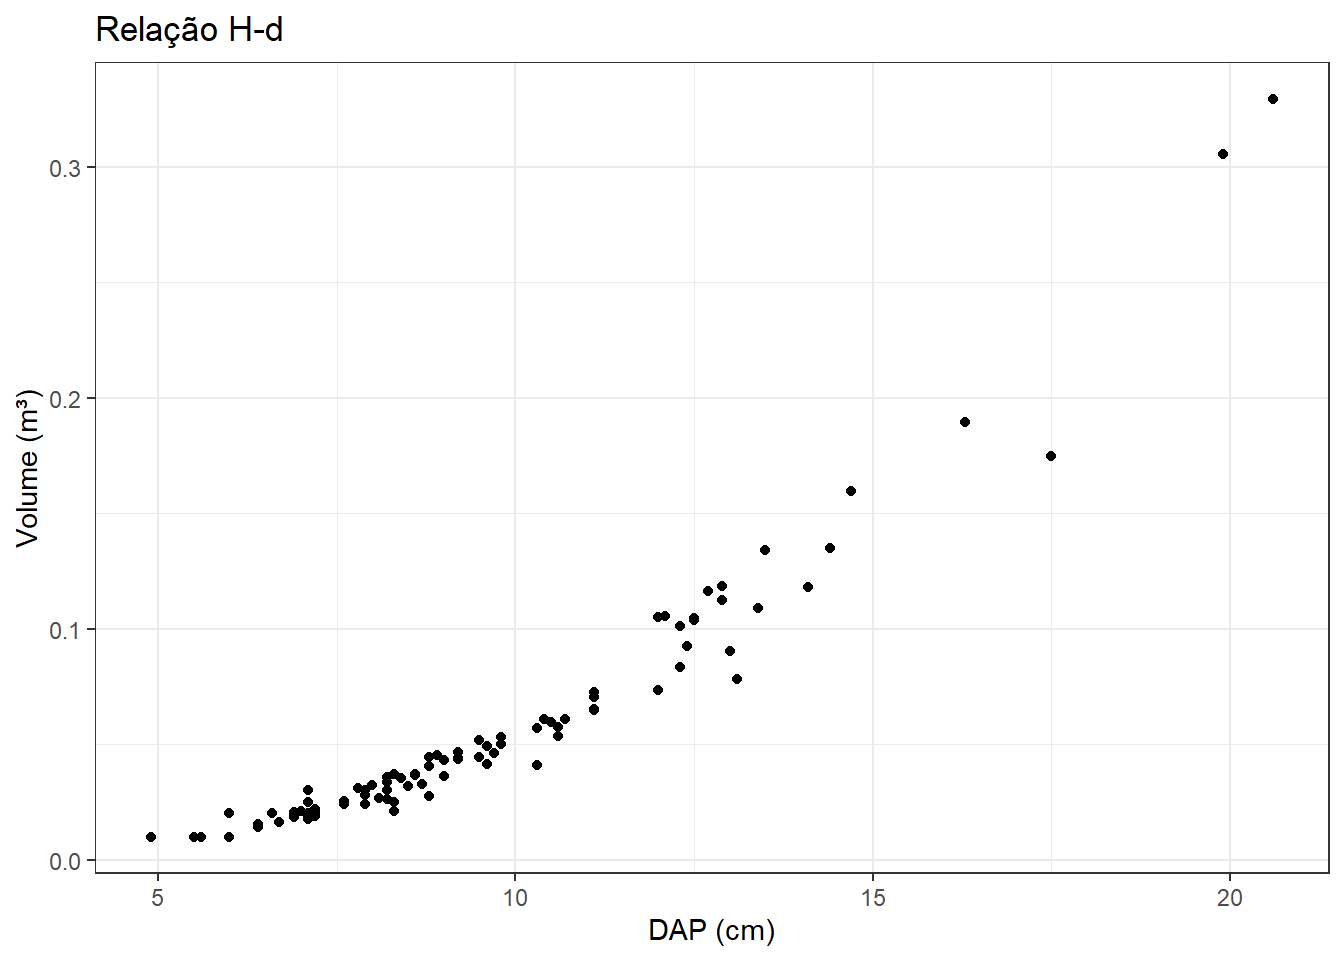
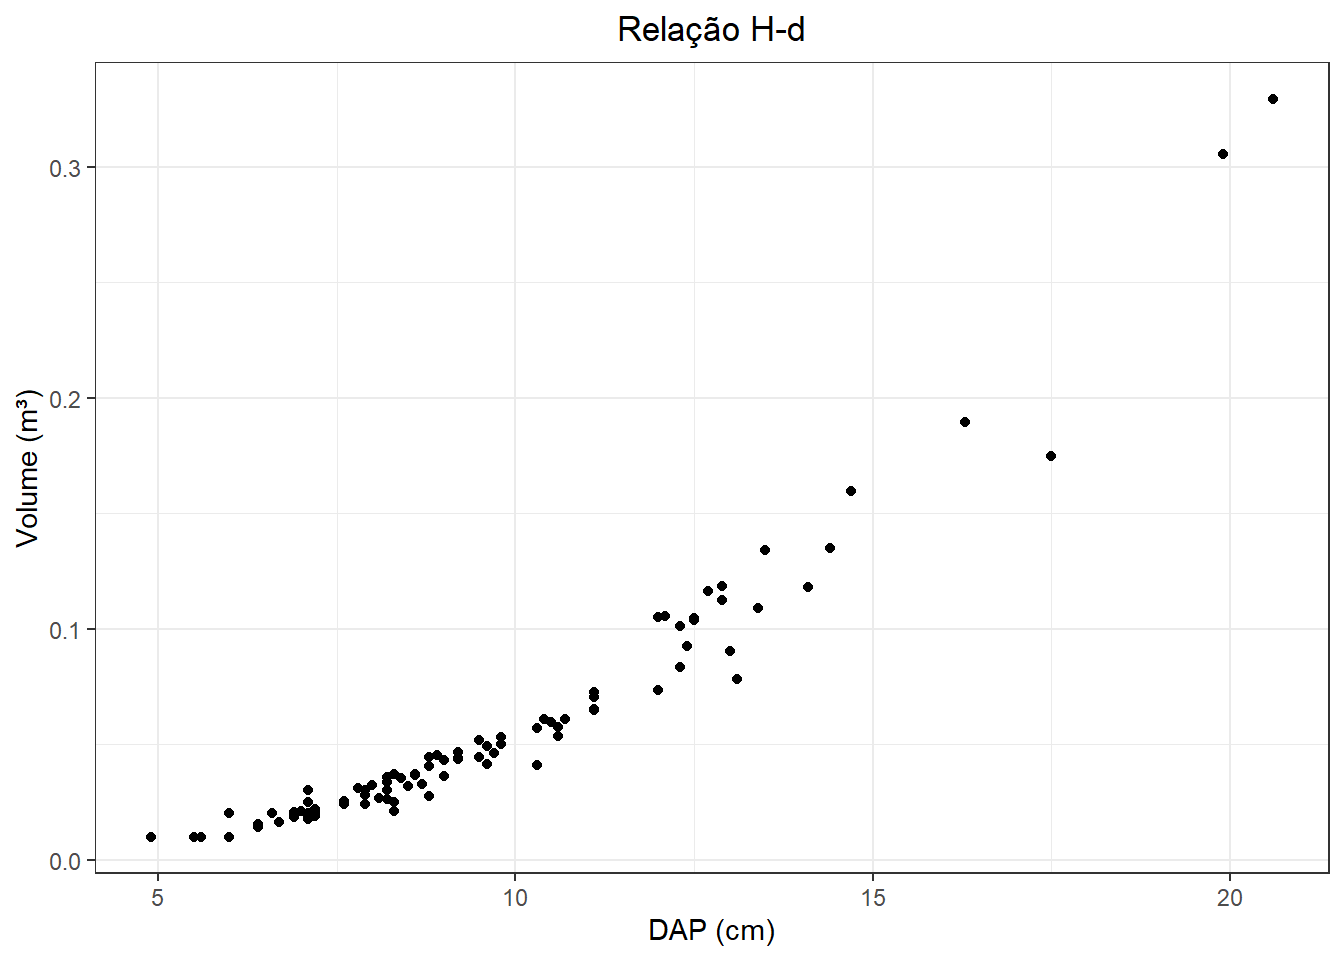
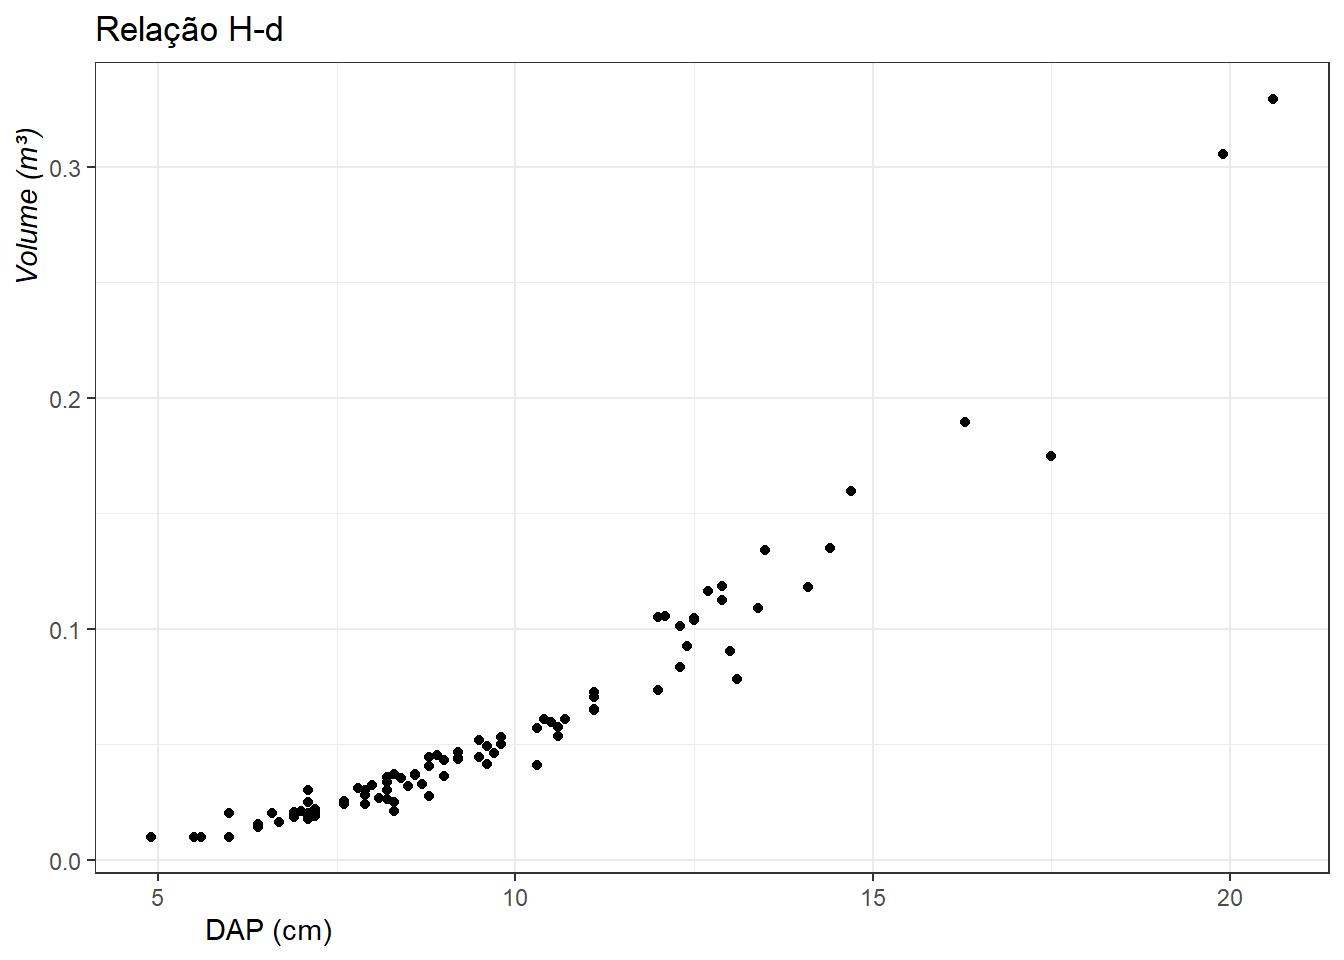
library(ggplot2)library(ggcorrplot)library(ggthemes)library(gridExtra)library(MASS)#library(ggalt)# Para instalar os pacotes, use install.packages('ggplot2'), e # da mesma forma com os outros.dados.brutos <-read.csv2("data/dados.csv",header =TRUE,sep =";",dec =",")str(dados.brutos)
Nem todo gráfico precisa conter todas essas partes. Em geral, ggplot() define os dados e os mapeamentos estéticos; geom_...() define a geometria que será desenhada; scale_...() controla como os valores dos dados são traduzidos para propriedades visuais; coord_...() controla o sistema de coordenadas; facet_...() divide o gráfico em painéis; e theme() controla elementos não relacionados diretamente aos dados, como fonte, fundo, linhas de grade e posição da legenda.
Uma distinção fundamental é entre mapear uma estética e fixar uma estética. Quando a estética varia de acordo com uma variável, ela é colocada dentro de aes(). Quando se deseja um valor fixo para todos os elementos, o argumento fica fora de aes().
RELAÇÃO ENTRE VARIÁVEIS
Criando a base para os gráficos futuros
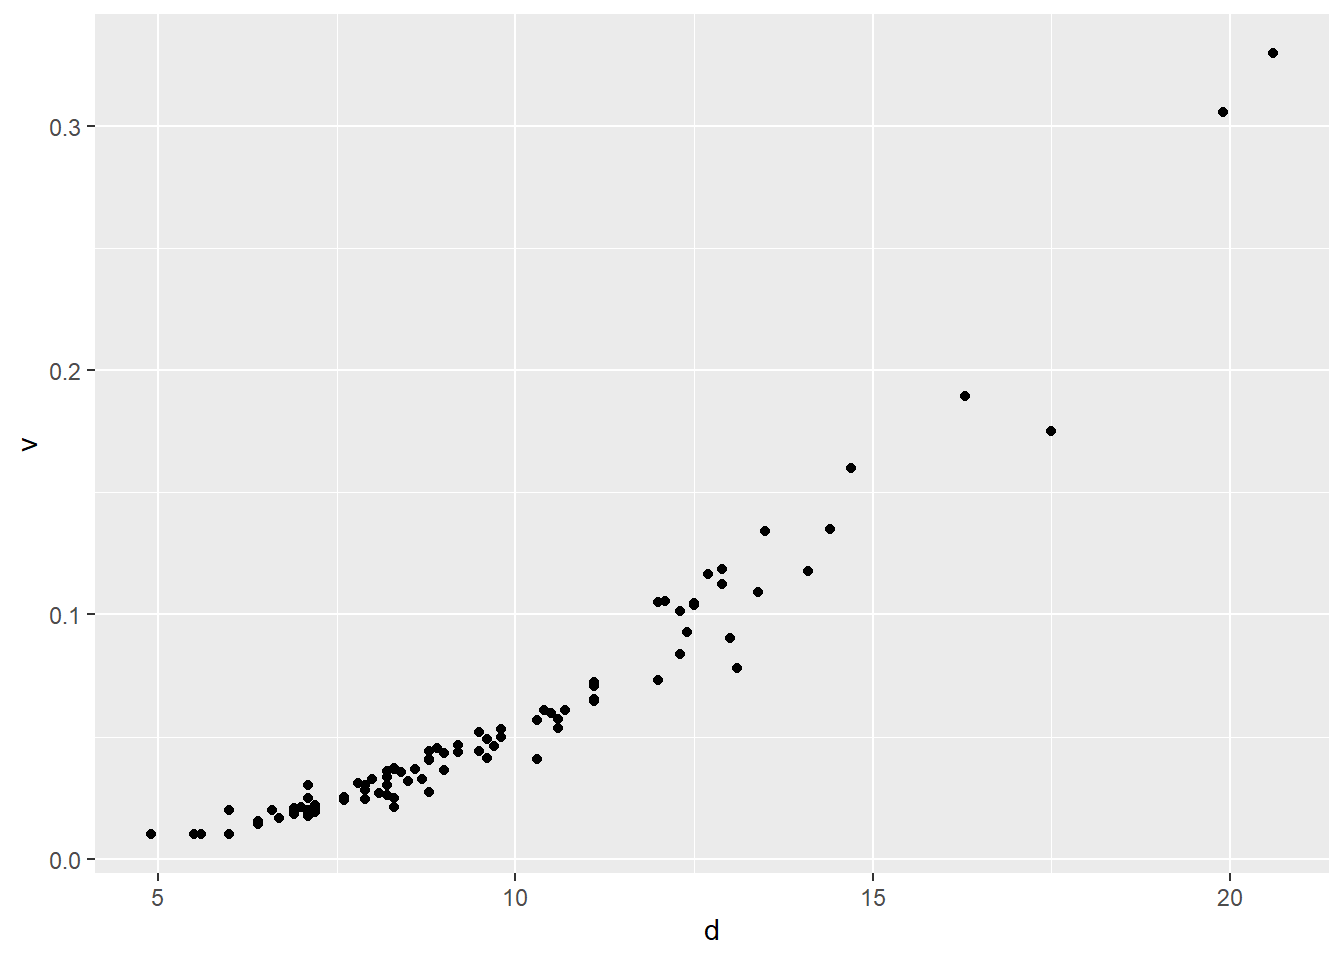
g.base <-ggplot(dados, aes(x = d, y = v)) +labs(x ="DAP (cm)", y ="Volume (m³)")
Dispersão entre variáveis
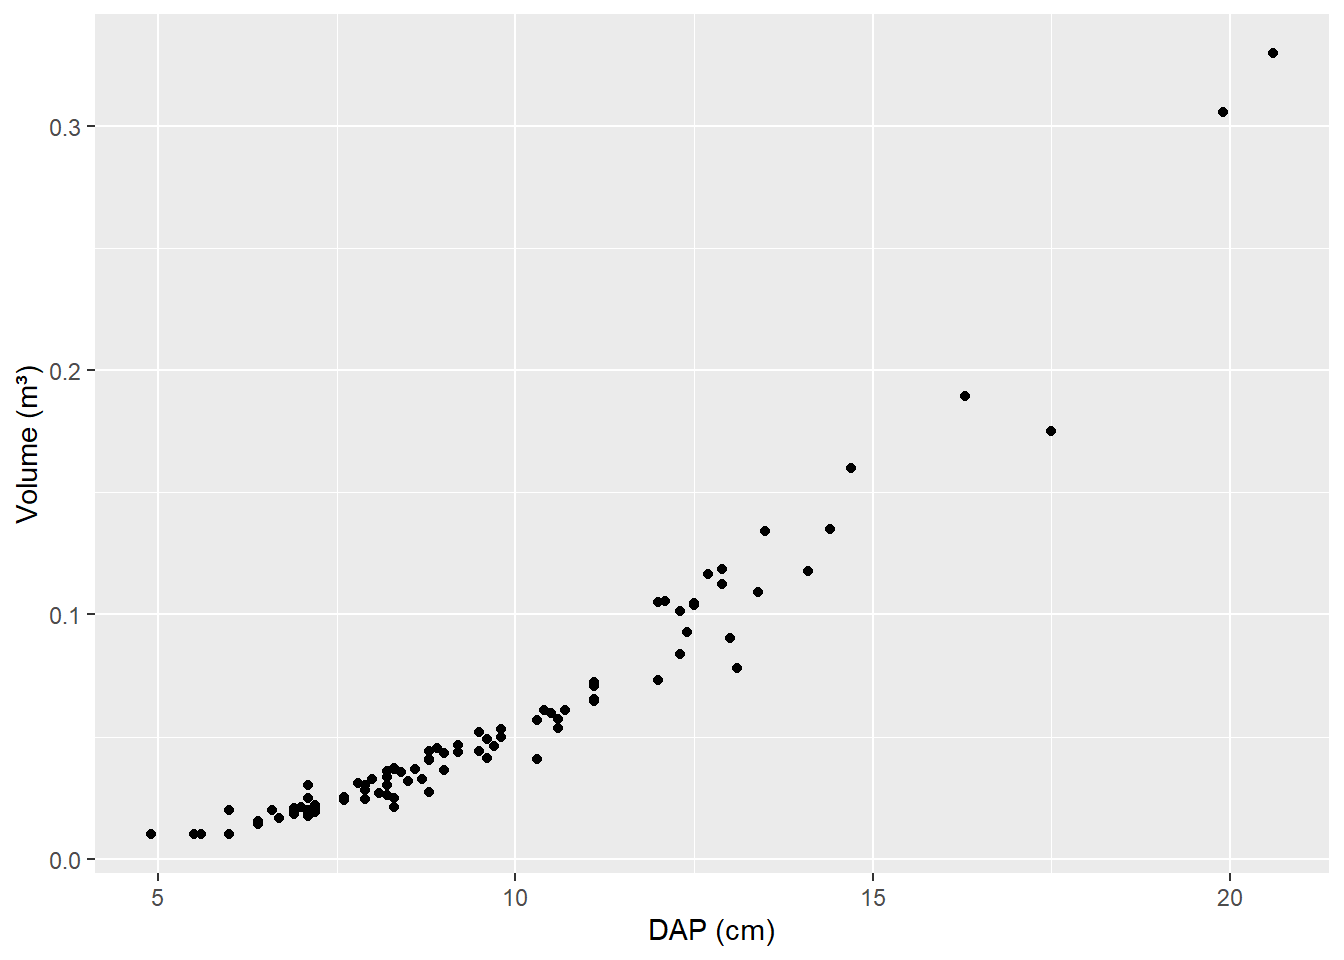
Disposição mais simples
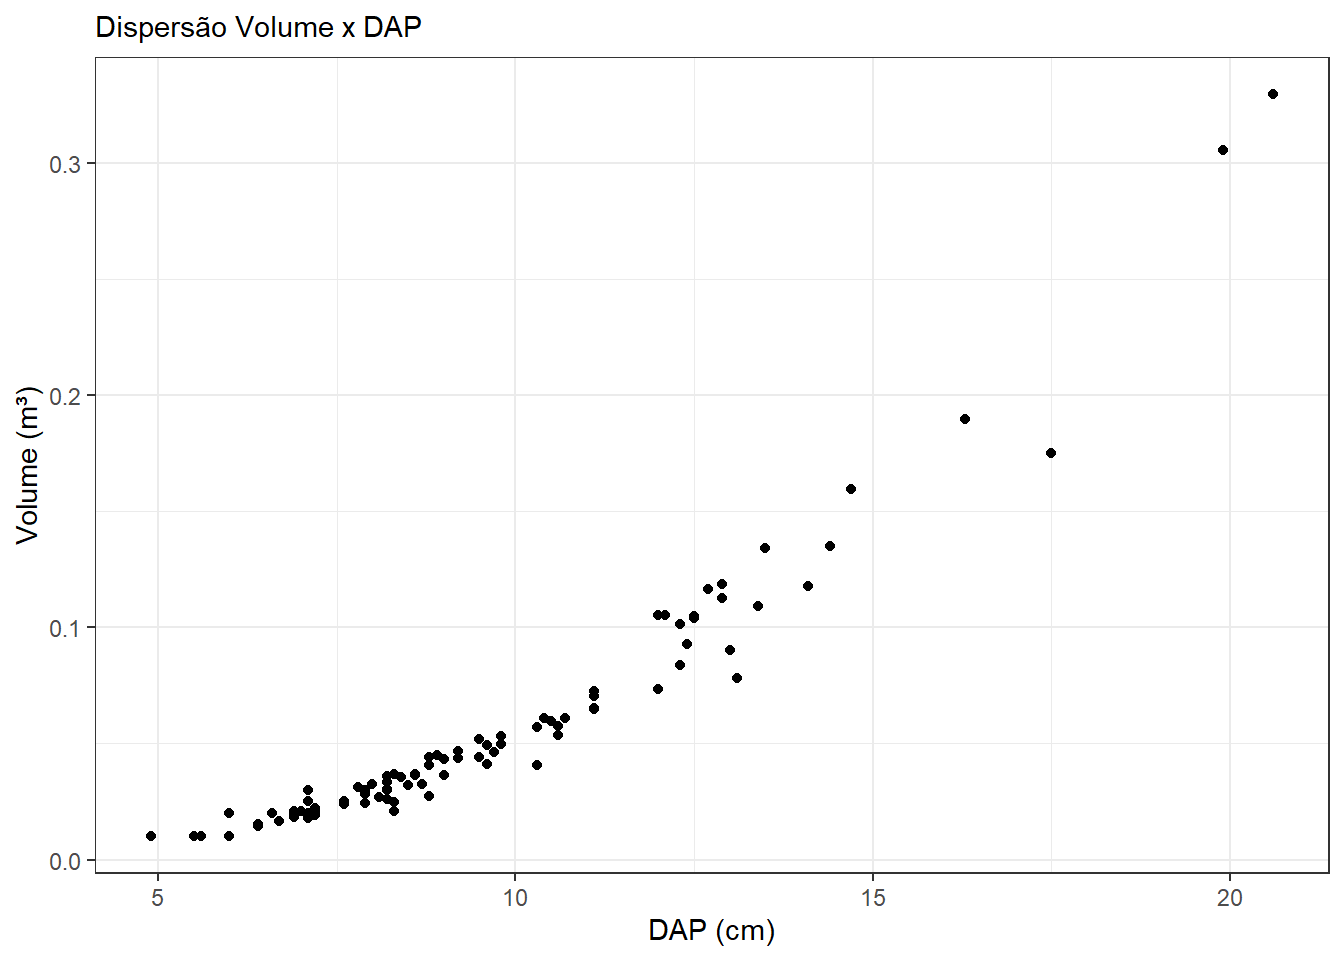
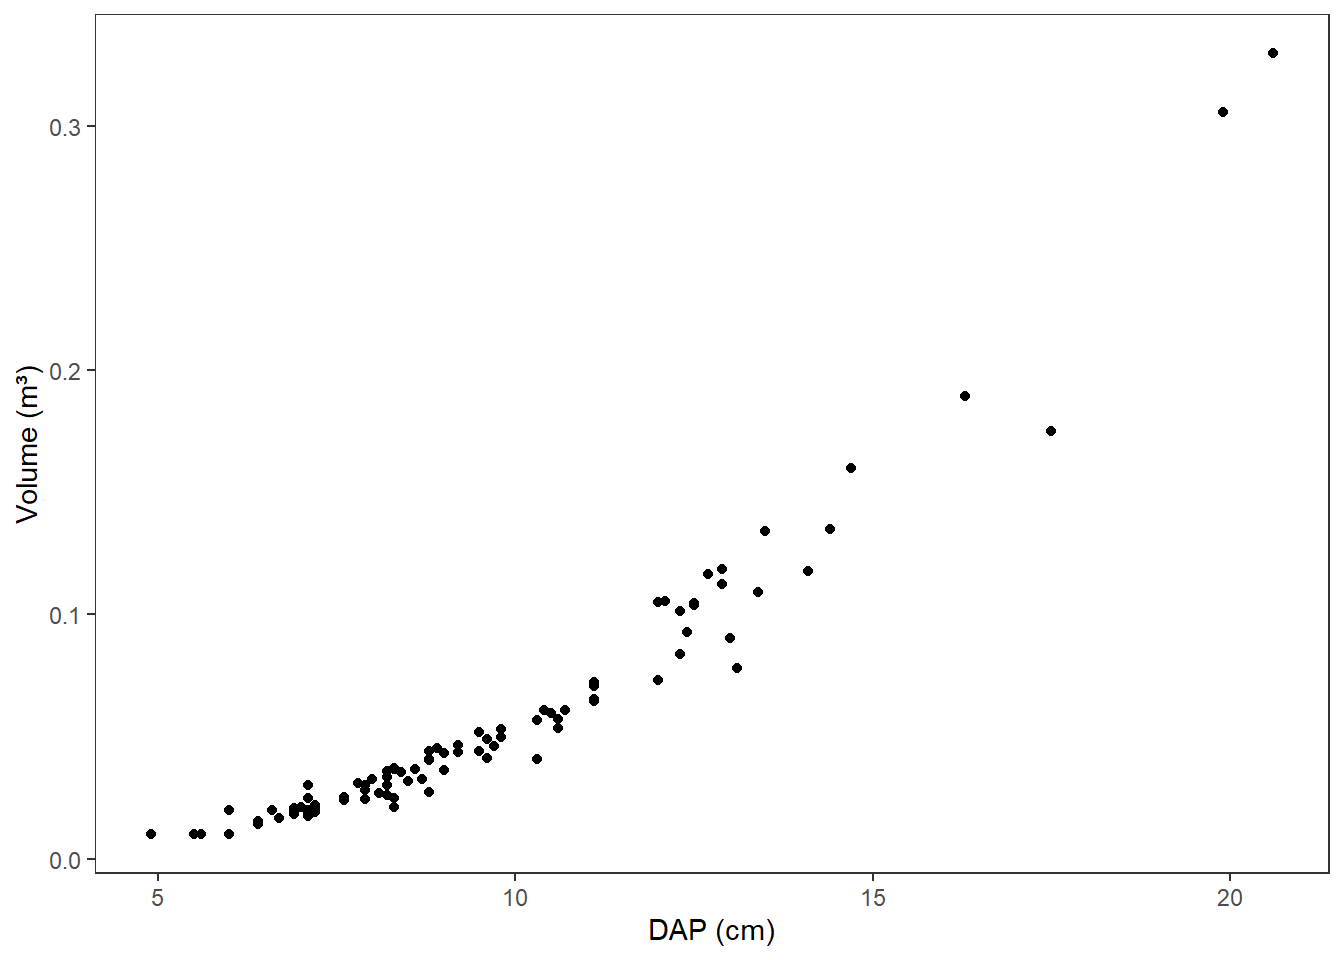
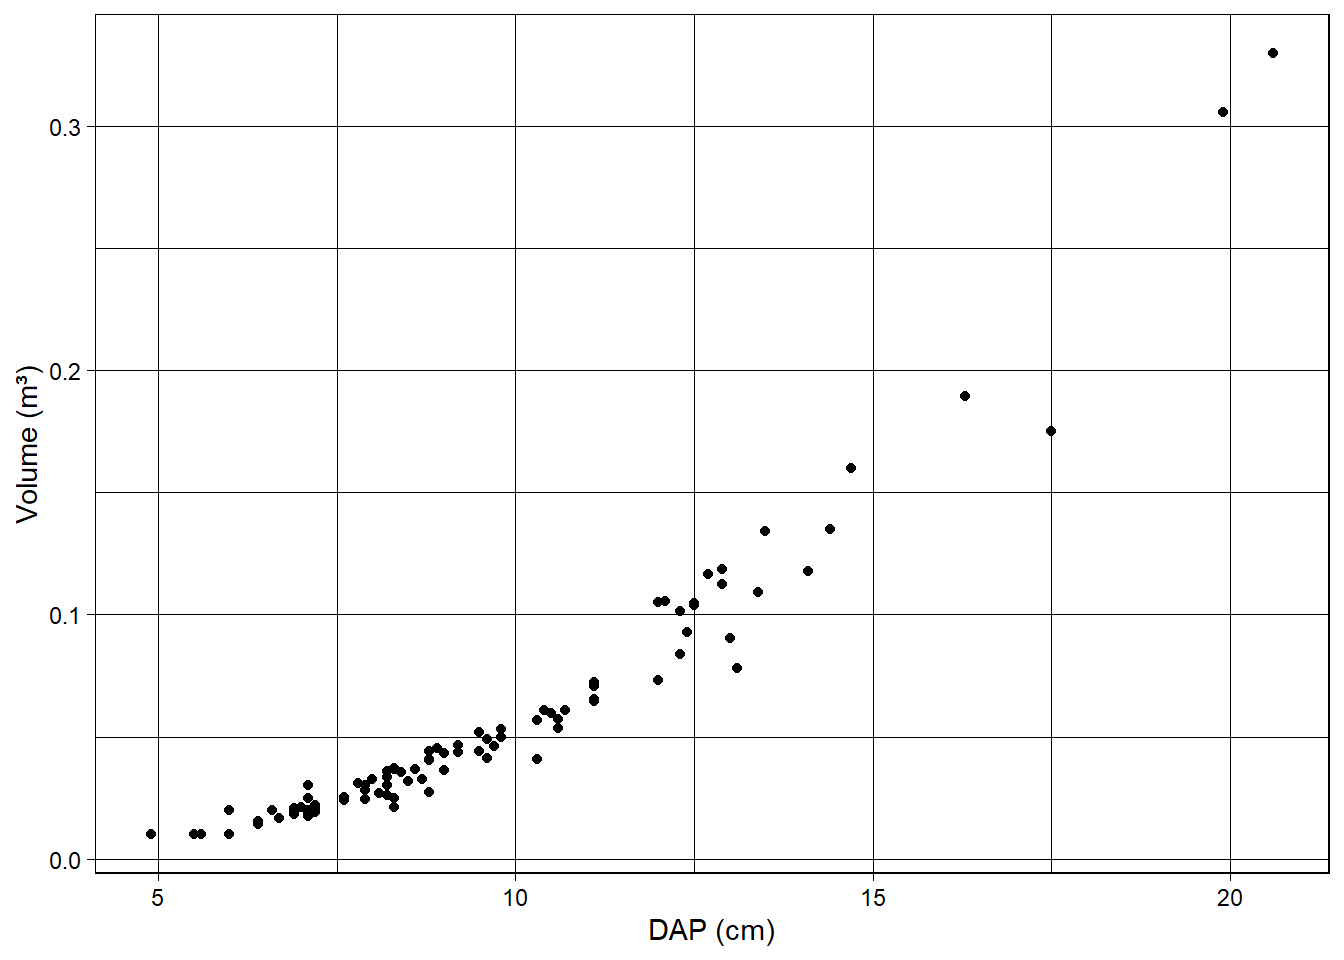
g.base +#*geom_point() +#Puxa x e y do argumento aes() inserido no gráfico baselabs(subtitle ="Dispersão Volume x DAP") #Adiciona mais argumentos à função labs()
#* Notar a possibilidade de adicionar mais comandos ao gráfico criado anteriormente
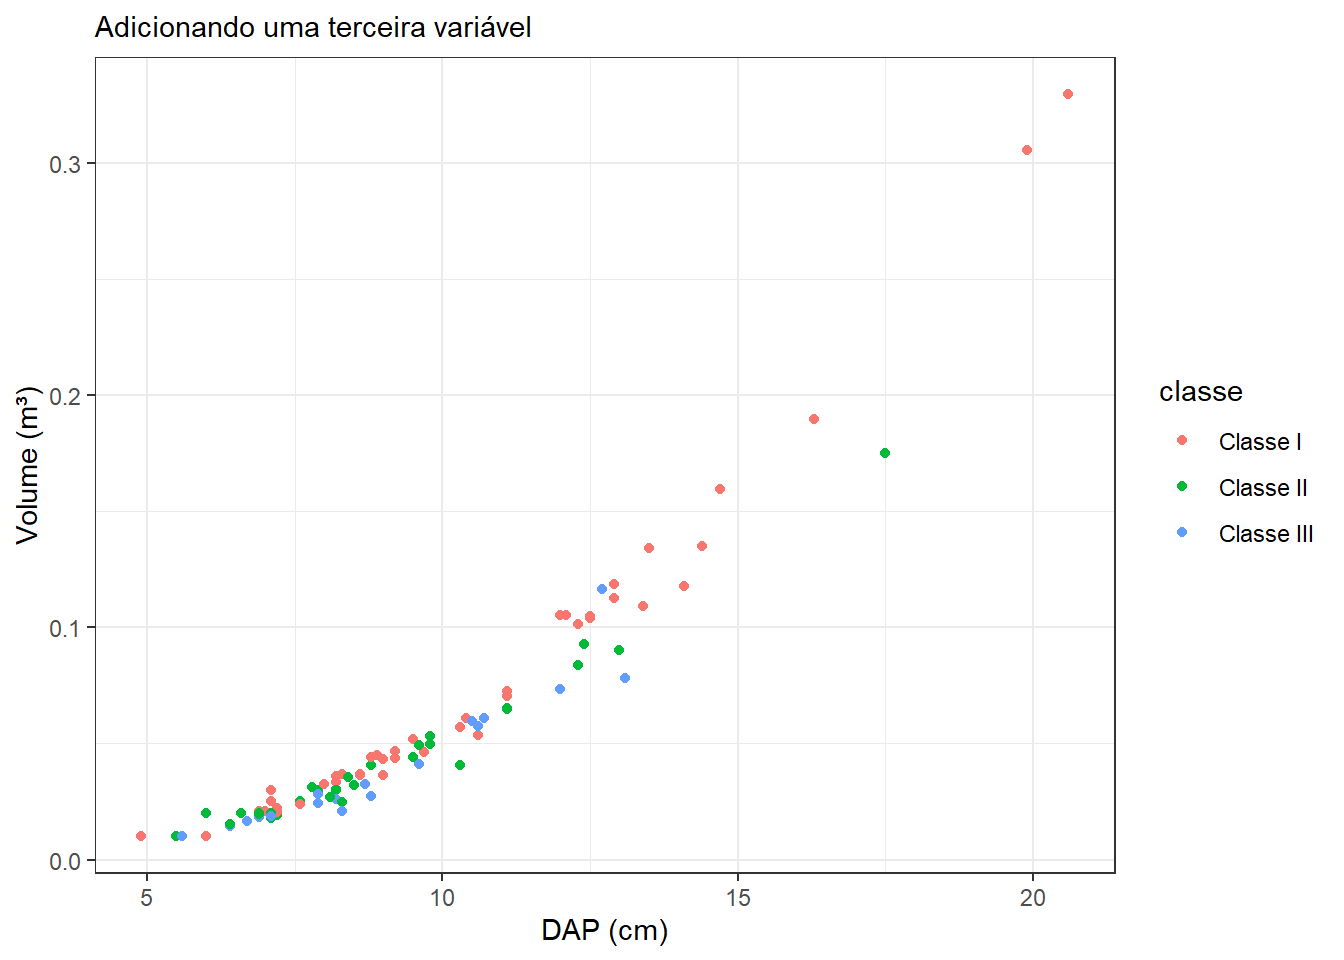
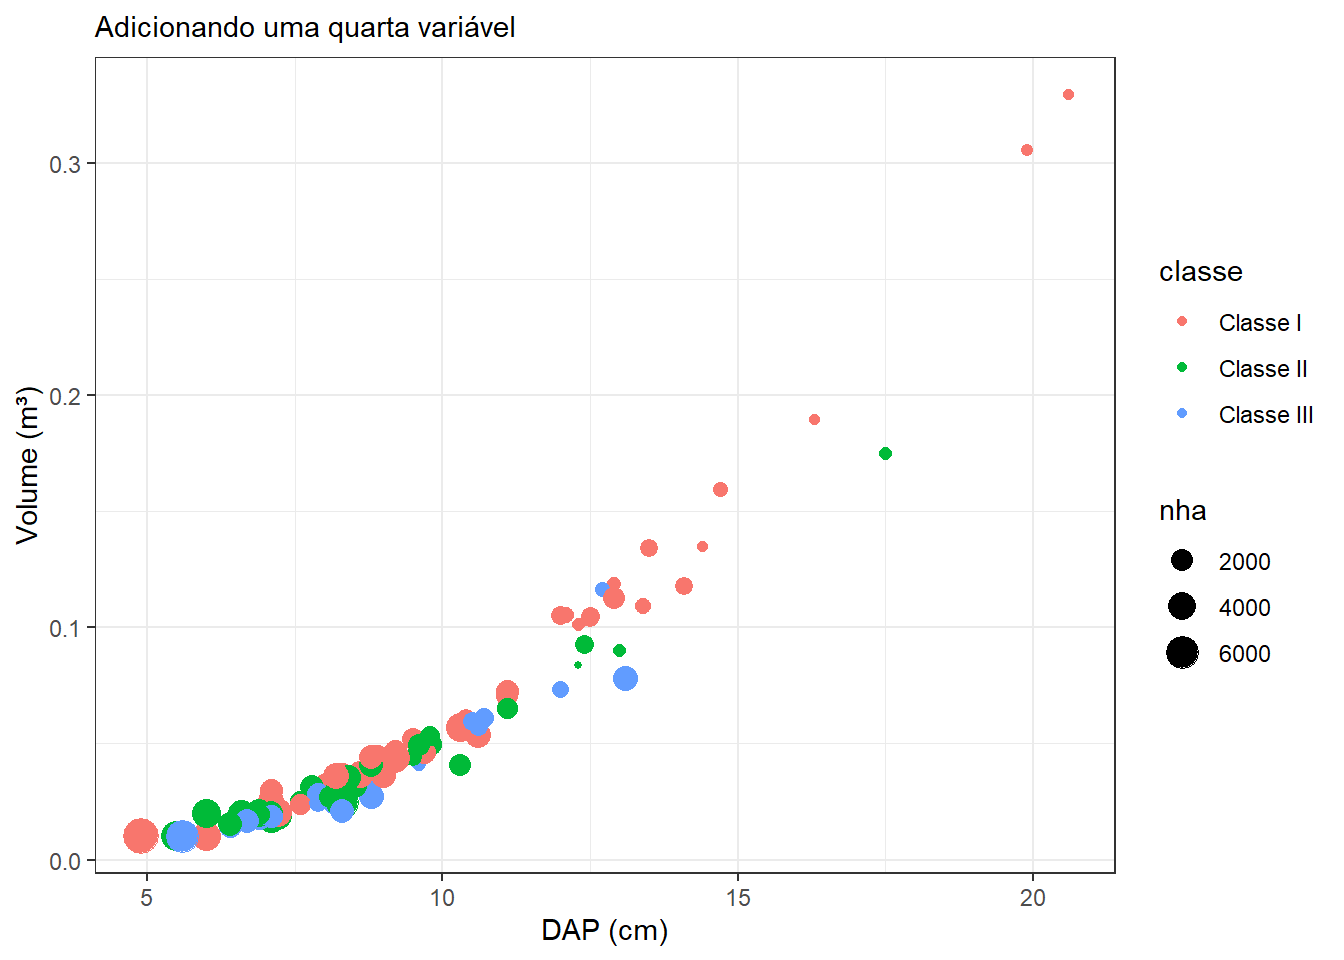
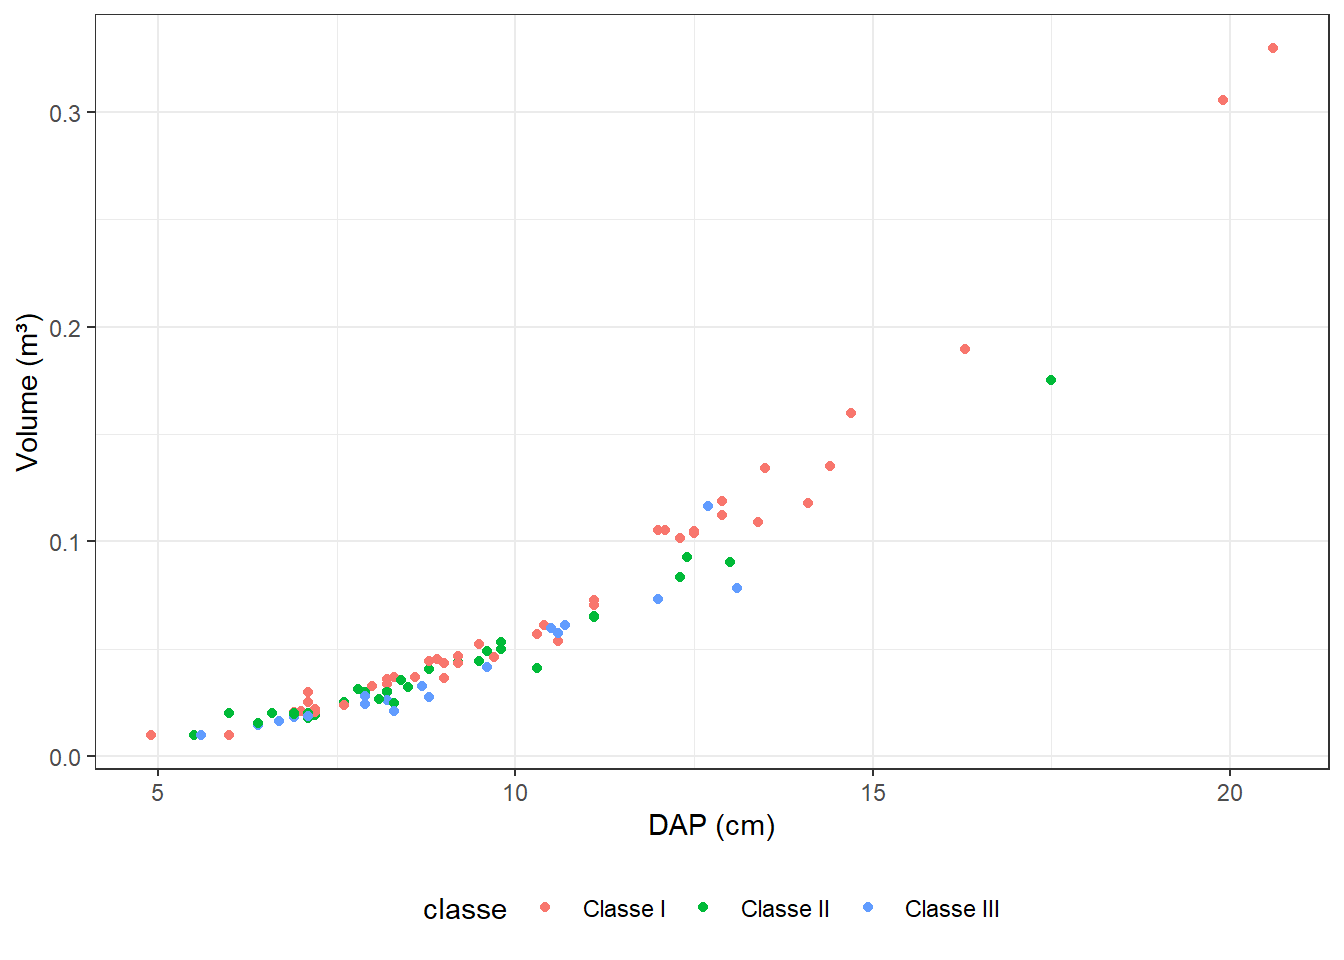
Adicionando uma terceira variável
g.base +geom_point(aes(color = classe)) +labs(subtitle ="Adicionando uma terceira variável")
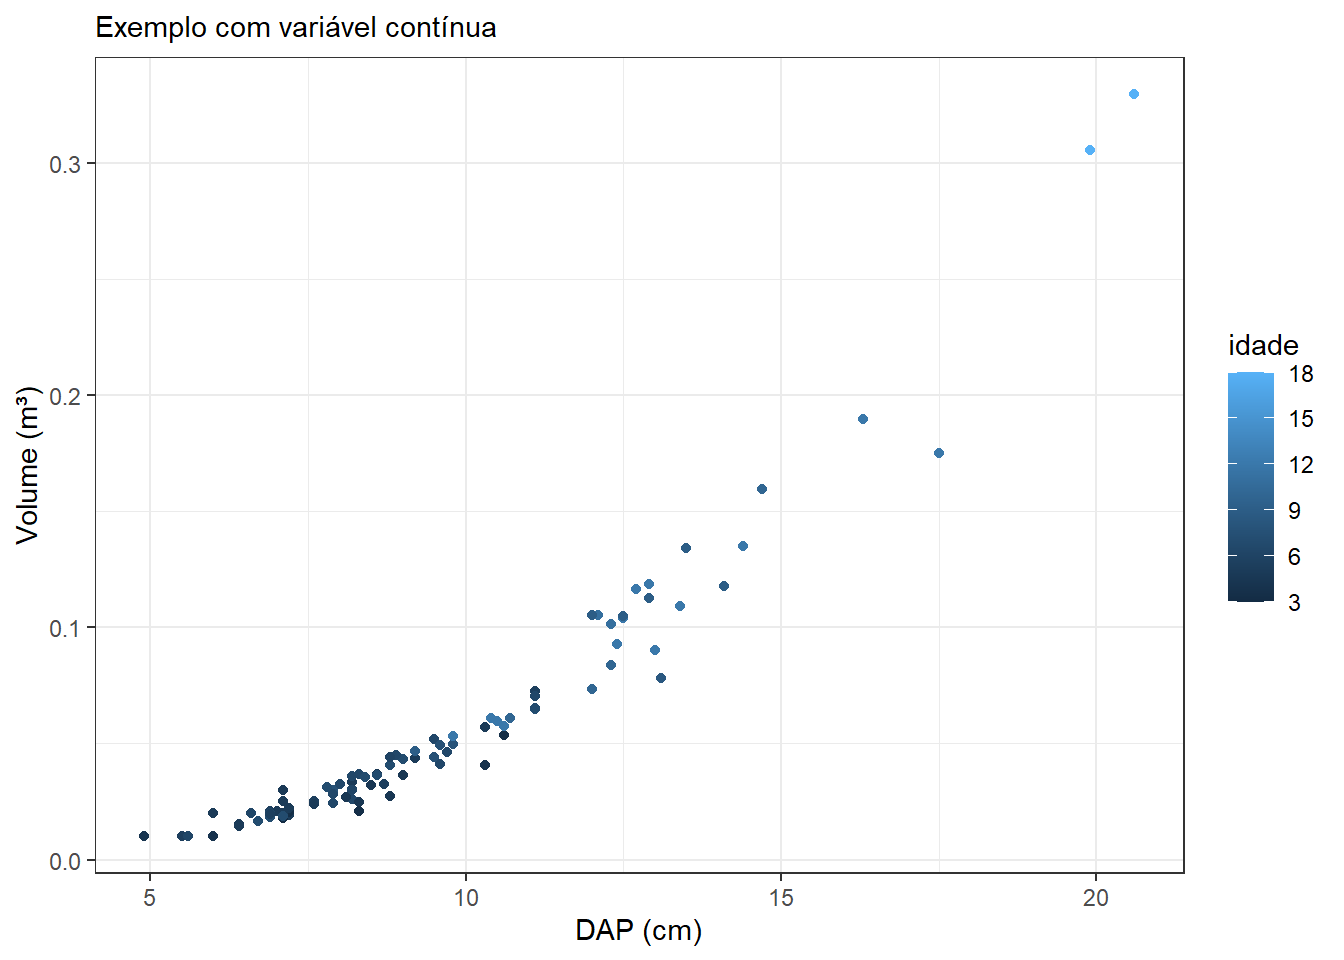
g.base +geom_point(aes(color = idade)) +labs(subtitle ="Exemplo com variável contínua")
#* a variável idade pode ser transformada em categorias por meio de factor(idade)
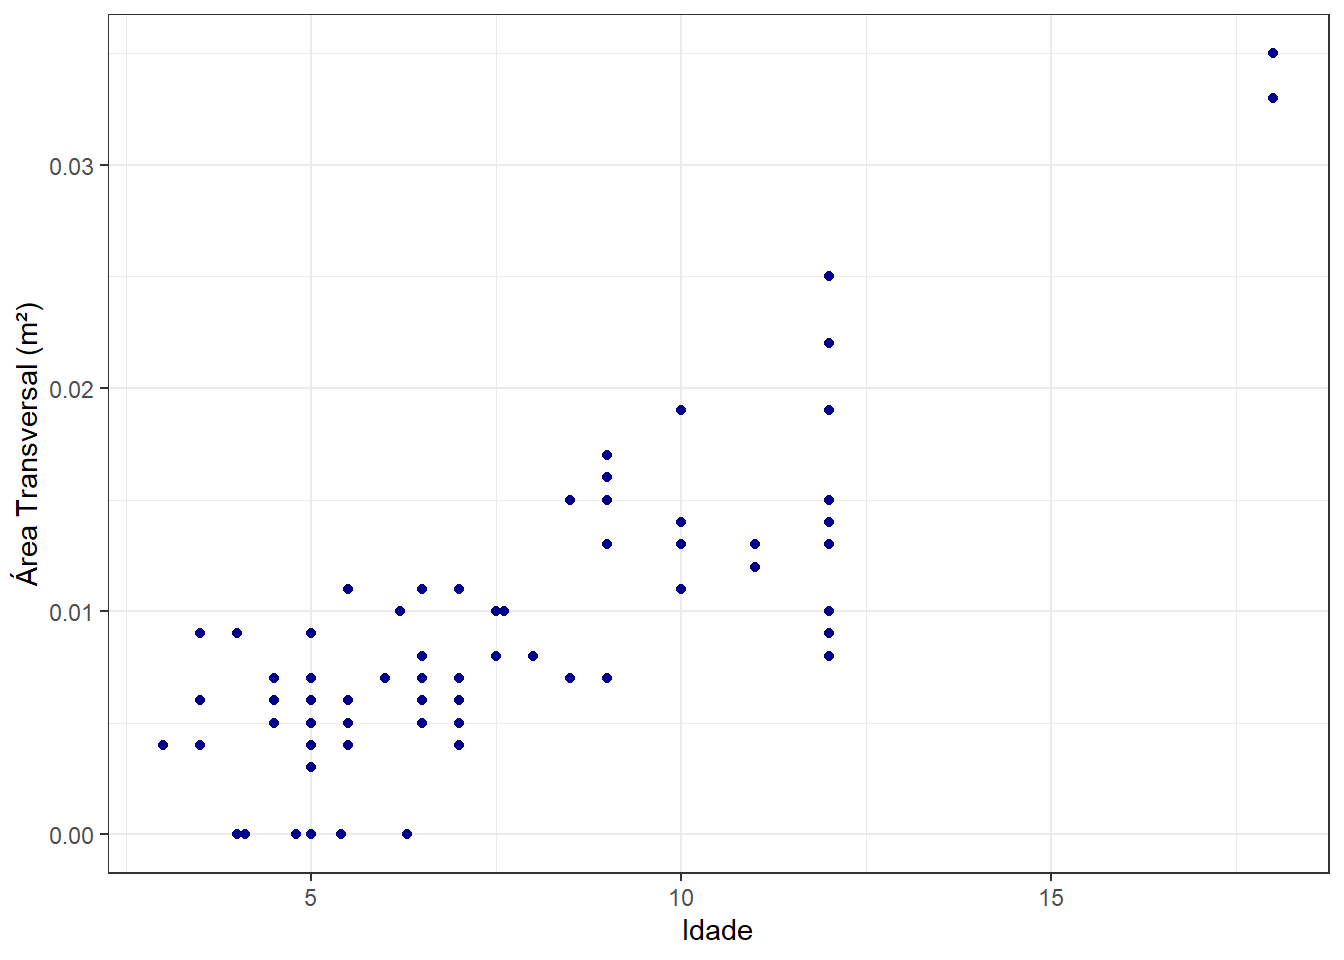
Quando há muita sobreposição de pontos
g.base <-ggplot(dados, aes(x = idade, y = g)) +labs(x ="Idade", y ="Área Transversal (m²)")#Vários pontos estão agrupados na mesma posiçãog.base +geom_point(color ="darkblue")
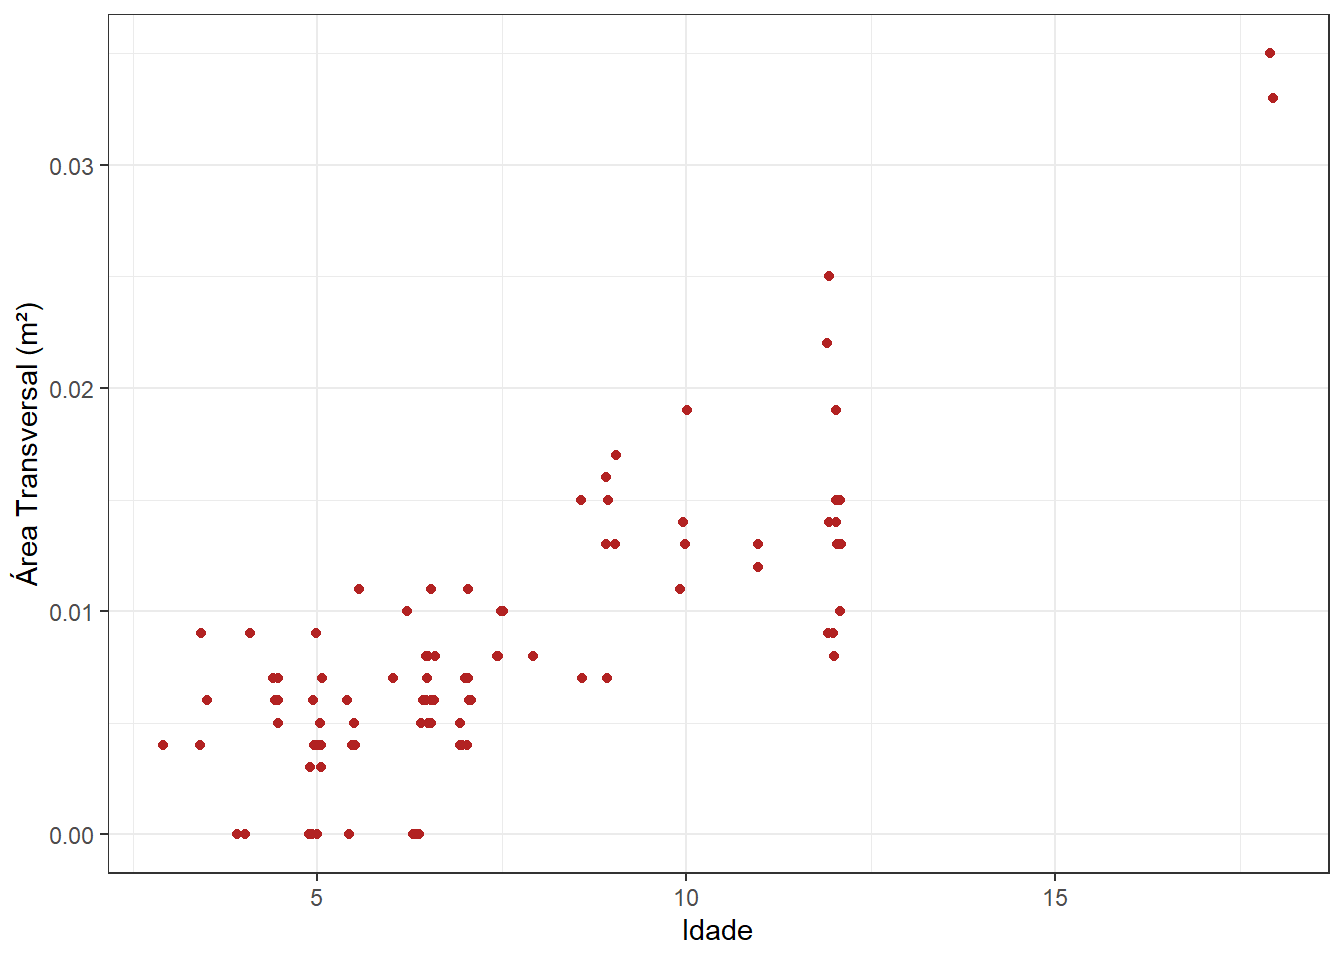
# geom_jitter() desloca levemente pontos sobrepostos.# width controla o deslocamento horizontal; height = 0 evita alterar visualmente os valores de Y.g.base +geom_jitter(width =0.1, height =0, color ="firebrick")
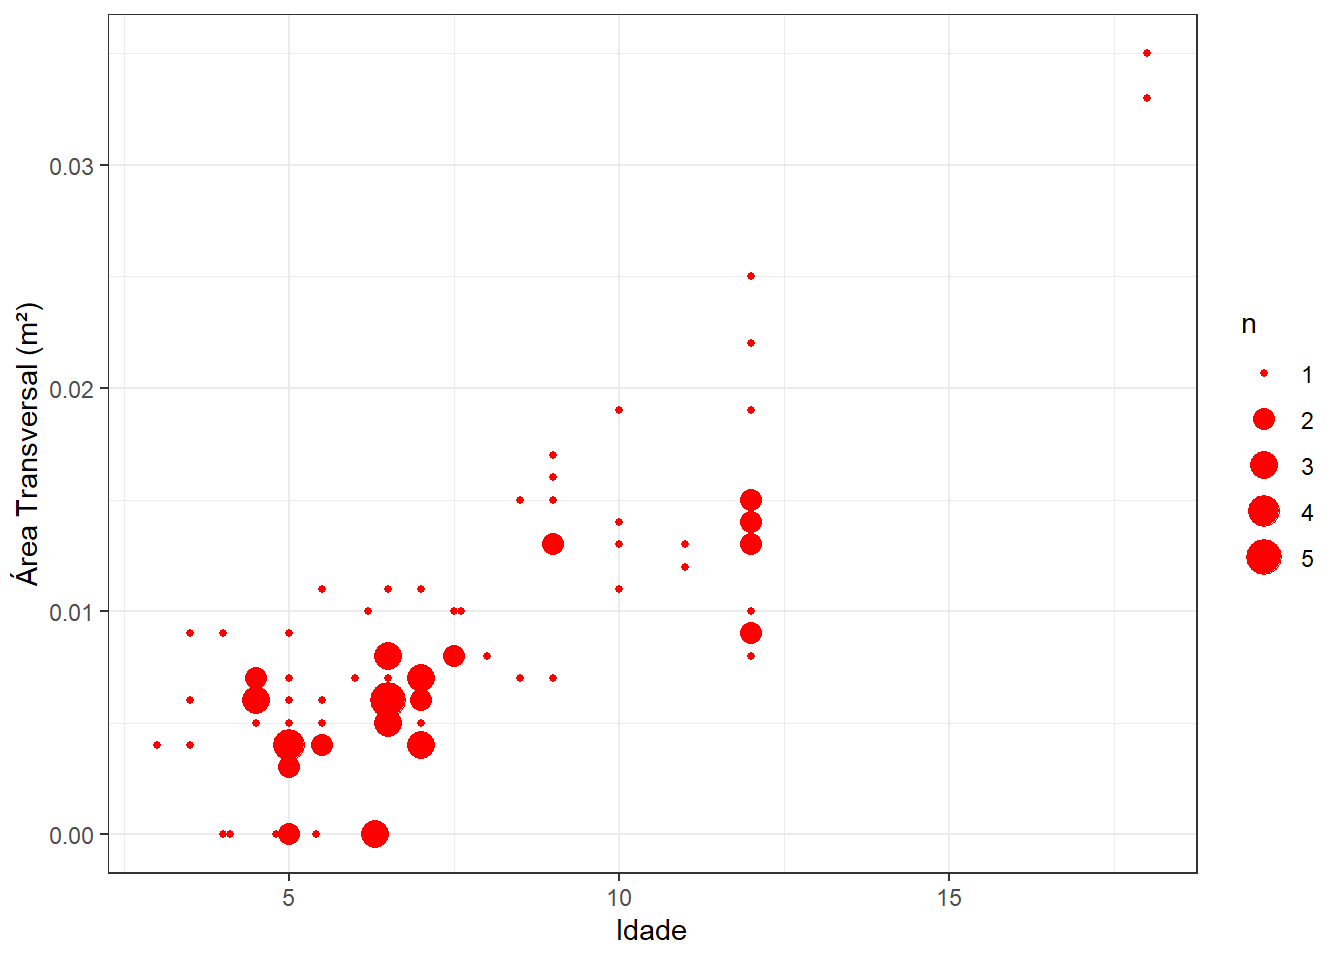
# geom_count() conta observações que ocupam a mesma posição e representa essa frequência pela área dos pontos.g.base +geom_count(color ="red")
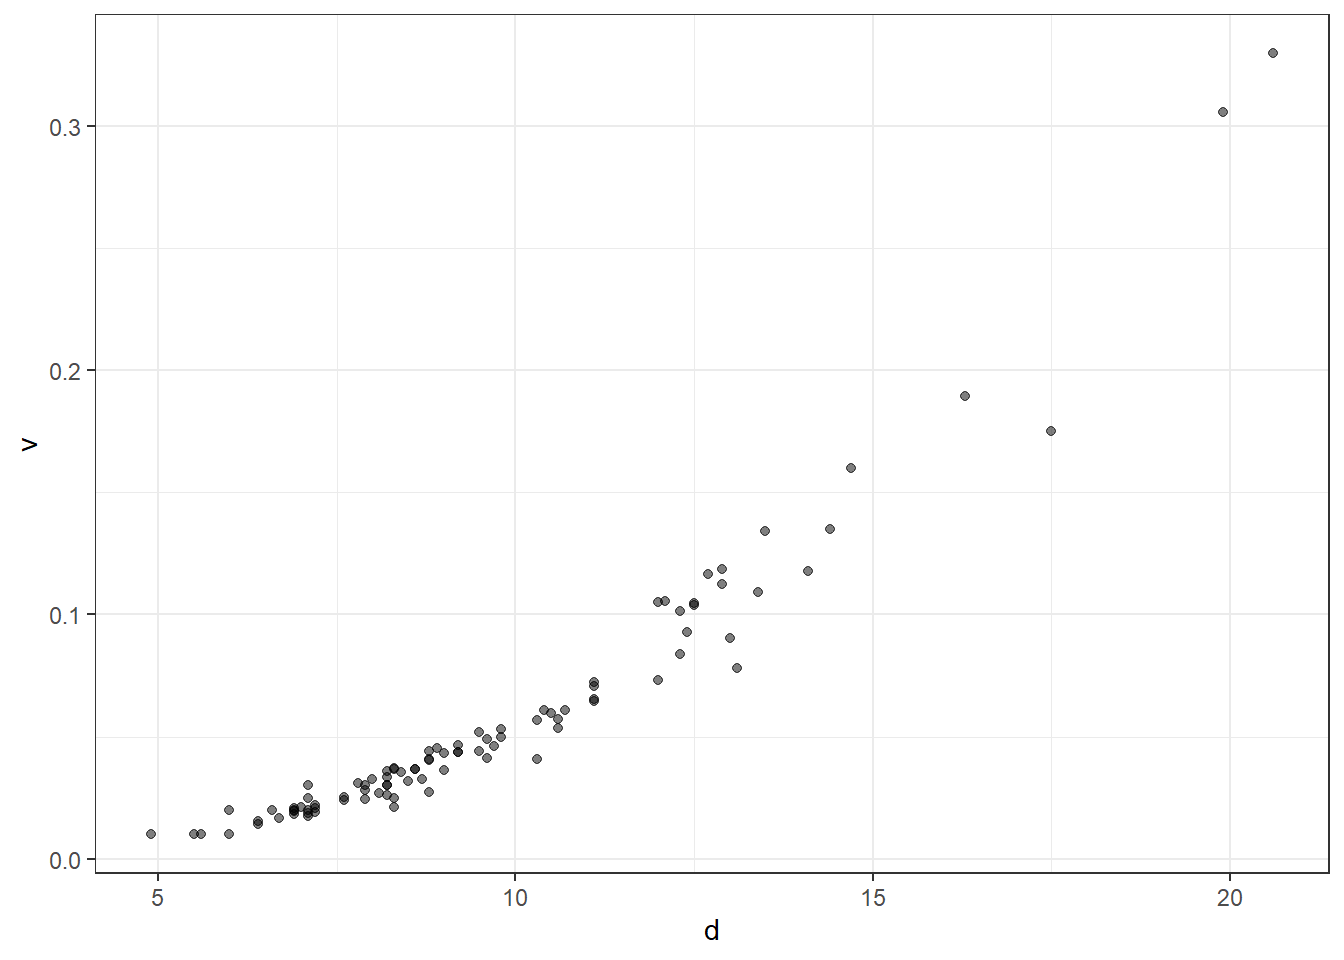
#Notar que, ao contrário dos gráficos anteriores, o argumento "color" foi inserido fora da função "aes()". Isso ocorre pois antes as cores iriam variar de acordo com uma variável, e variáveis devem ser mapeadas dentro da função "aes()". Como agora foi usada uma cor pré-definida, o argumento "color" fica fora da função "aes()". Essa lógica se aplica para todas as demais estéticas mapeáveis (color, fill, shape, size, alpha, linewidth, ...)#Outra opção é atribuir uma transparência aos pontos, criando a sensação de densidade de pontos. A transparência é definida pelo argumento "alpha"ggplot(dados, aes(x = d, y = v)) +geom_point(alpha =0.5)
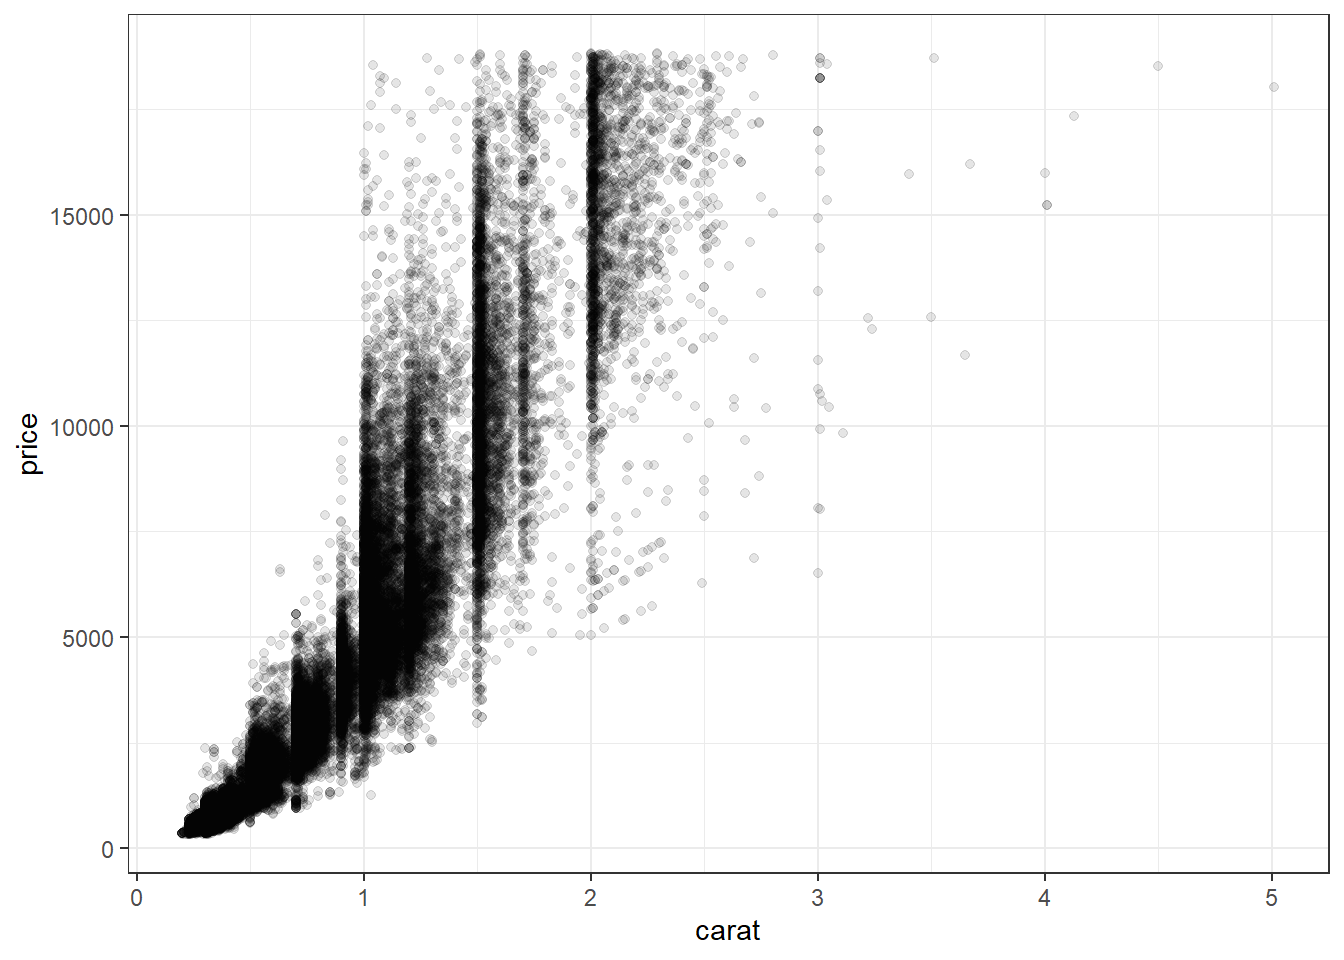
#Outro exemplo com transparência com o banco de dados "diamonds".###Pode demorar###ggplot(diamonds, aes(x = carat, y = price)) +geom_point(alpha =0.1)
Correlograma
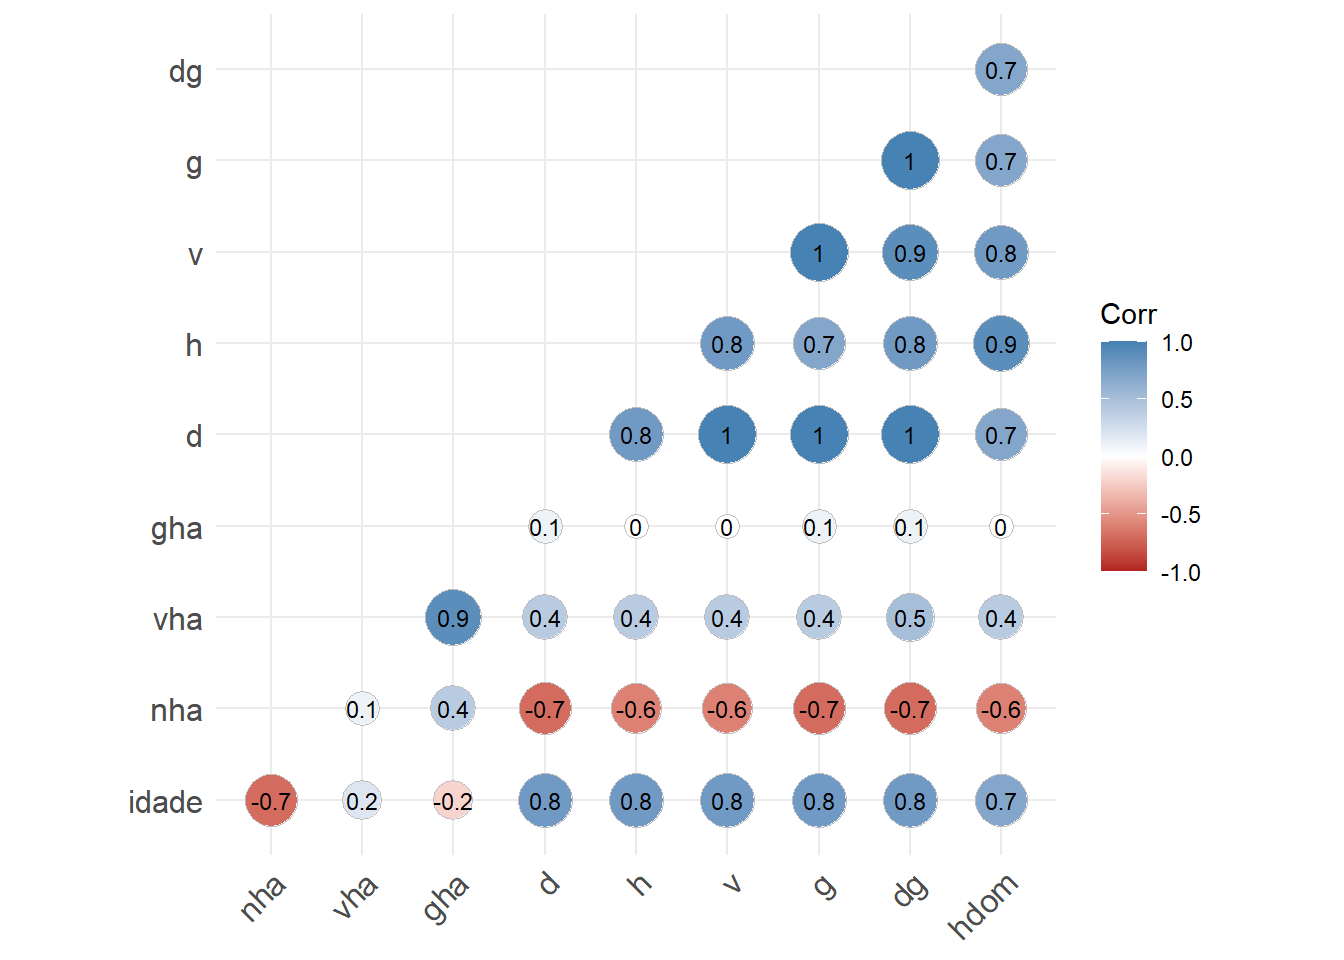
Outra forma de apresentar a relação entre variáveis é por meio de um correlograma.
Nesse caso, será utilizado o pacote ggcorrplot, que possibilita a criação de correlogramas no ggplot2.
#install.packages("ggcorrplot")#library(ggcorrplot)# Selecionando as variáveis numéricas de interessevars.cor <-c("idade", "nha", "vha", "gha", "d", "h", "v", "g", "dg", "hdom")# Calculando a correlação. O argumento pairwise.complete.obs usa,# em cada par de variáveis, as observações disponíveis para aquele par.correl <-cor(dados[, vars.cor], use ="pairwise.complete.obs")# Arredondando para 1 casa decimalcorrel <-round(correl, 1) #Criando o correlograma#______________________________________________________________ggcorrplot(corr = correl, #Informando a matriz de correlação calculada acimamethod ="circle", #Forma da visualizaçãotype ="lower", #Mostrar apenas a parte inferior da matrizlab =TRUE,lab_size =3, #Inserir os valores da correlação e o tamanho da fontecolors =c("firebrick","white","steelblue"))#Cores. -1, 0 e 1
Warning: `aes_string()` was deprecated in ggplot2 3.0.0.
ℹ Please use tidy evaluation idioms with `aes()`.
ℹ See also `vignette("ggplot2-in-packages")` for more information.
ℹ The deprecated feature was likely used in the ggcorrplot package.
  Please report the issue at <https://github.com/kassambara/ggcorrplot/issues>.
#Nesse caso, a escala criada é um tanto redundante, uma vez que os números indicam claramente a ordem das cores no sinal da correlação.
DISTRIBUIÇÃO
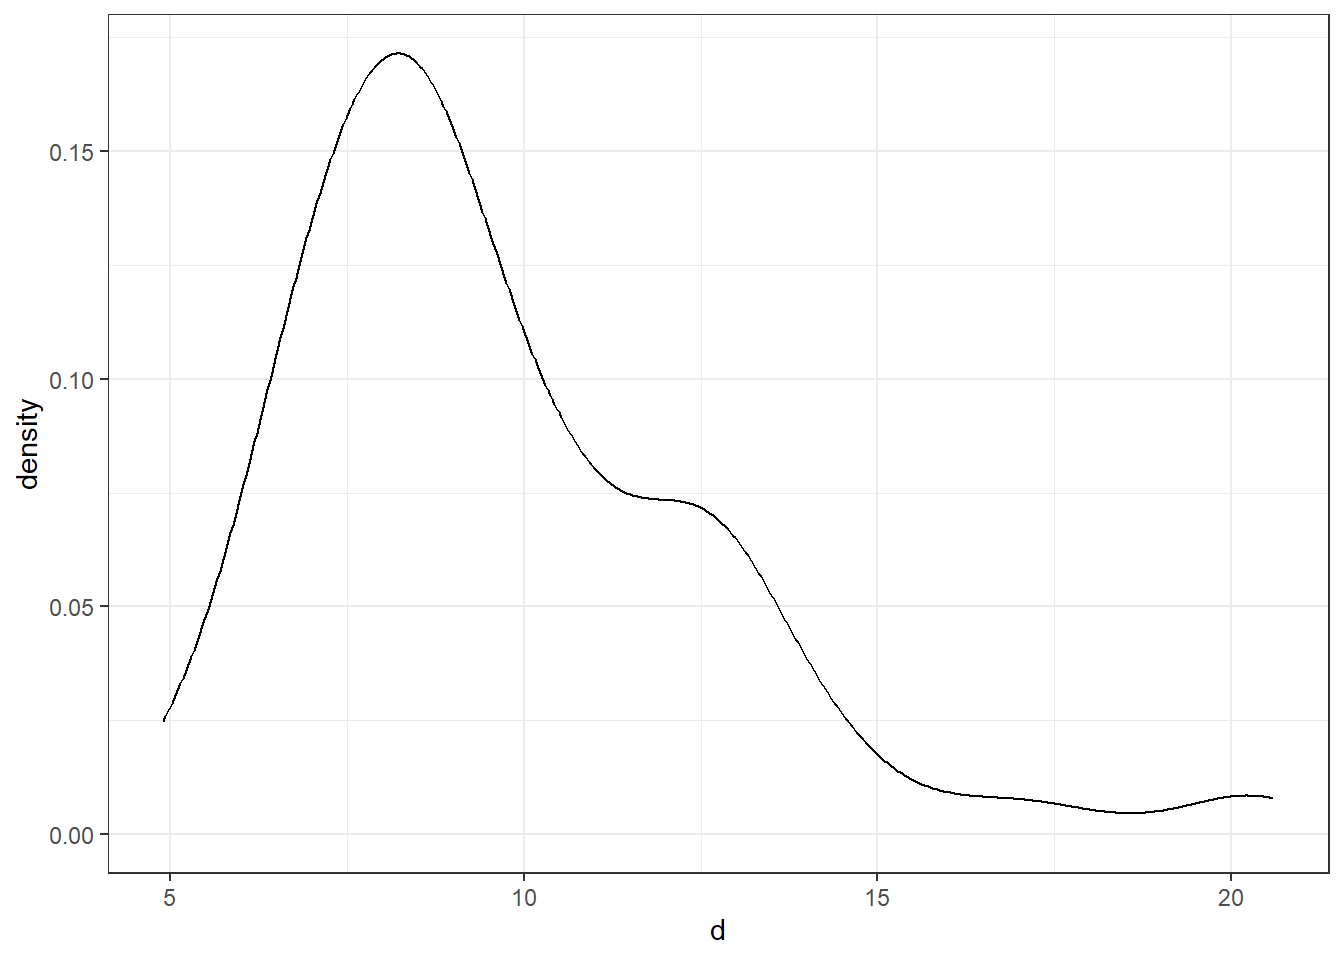
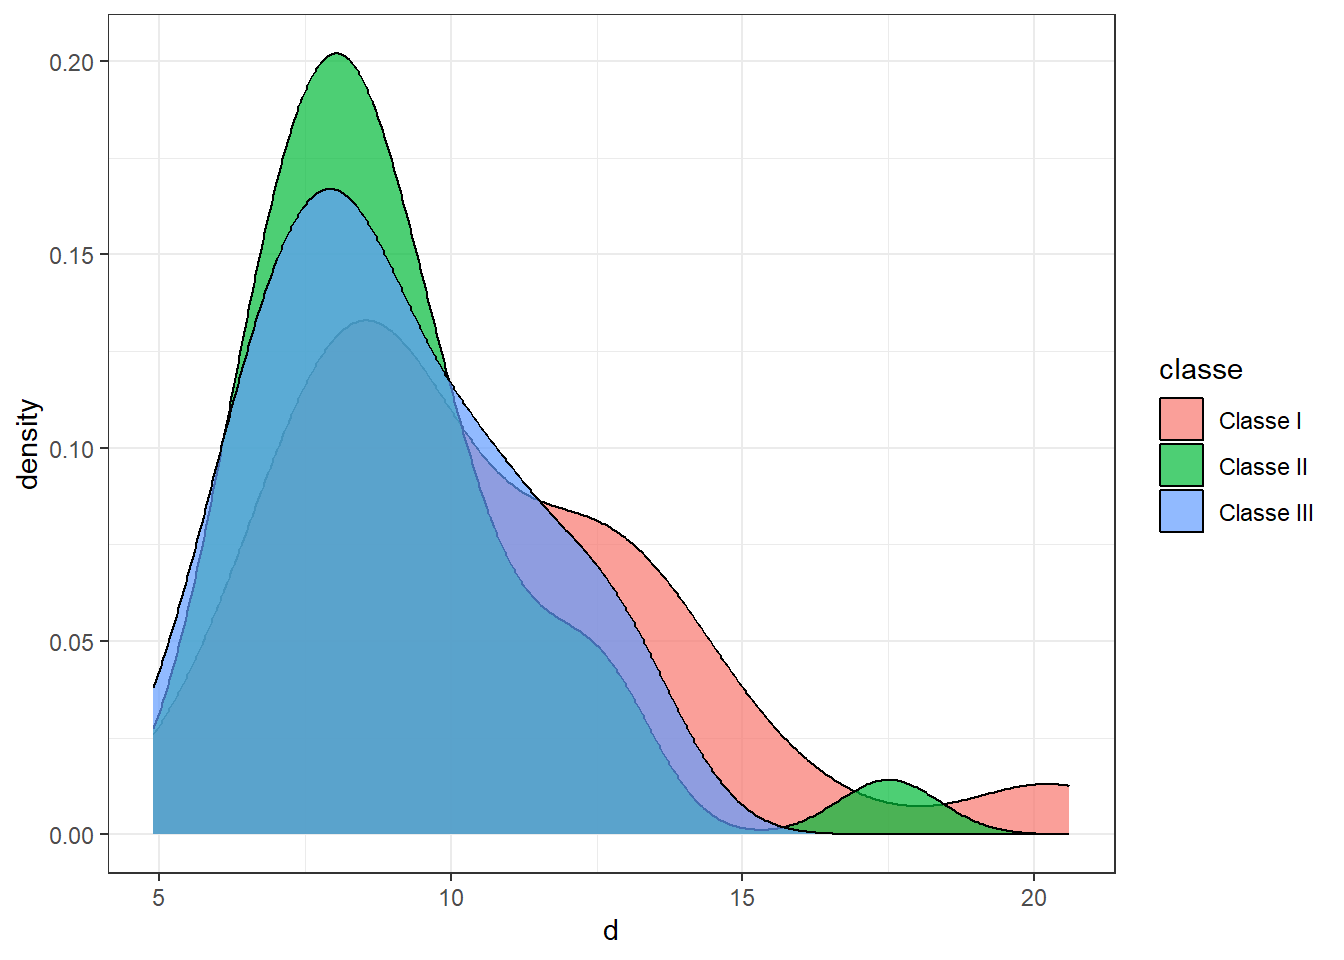
#Gráfico Baseg.base <-ggplot(dados, aes(x = d))
Histogramas
Apenas uma variável
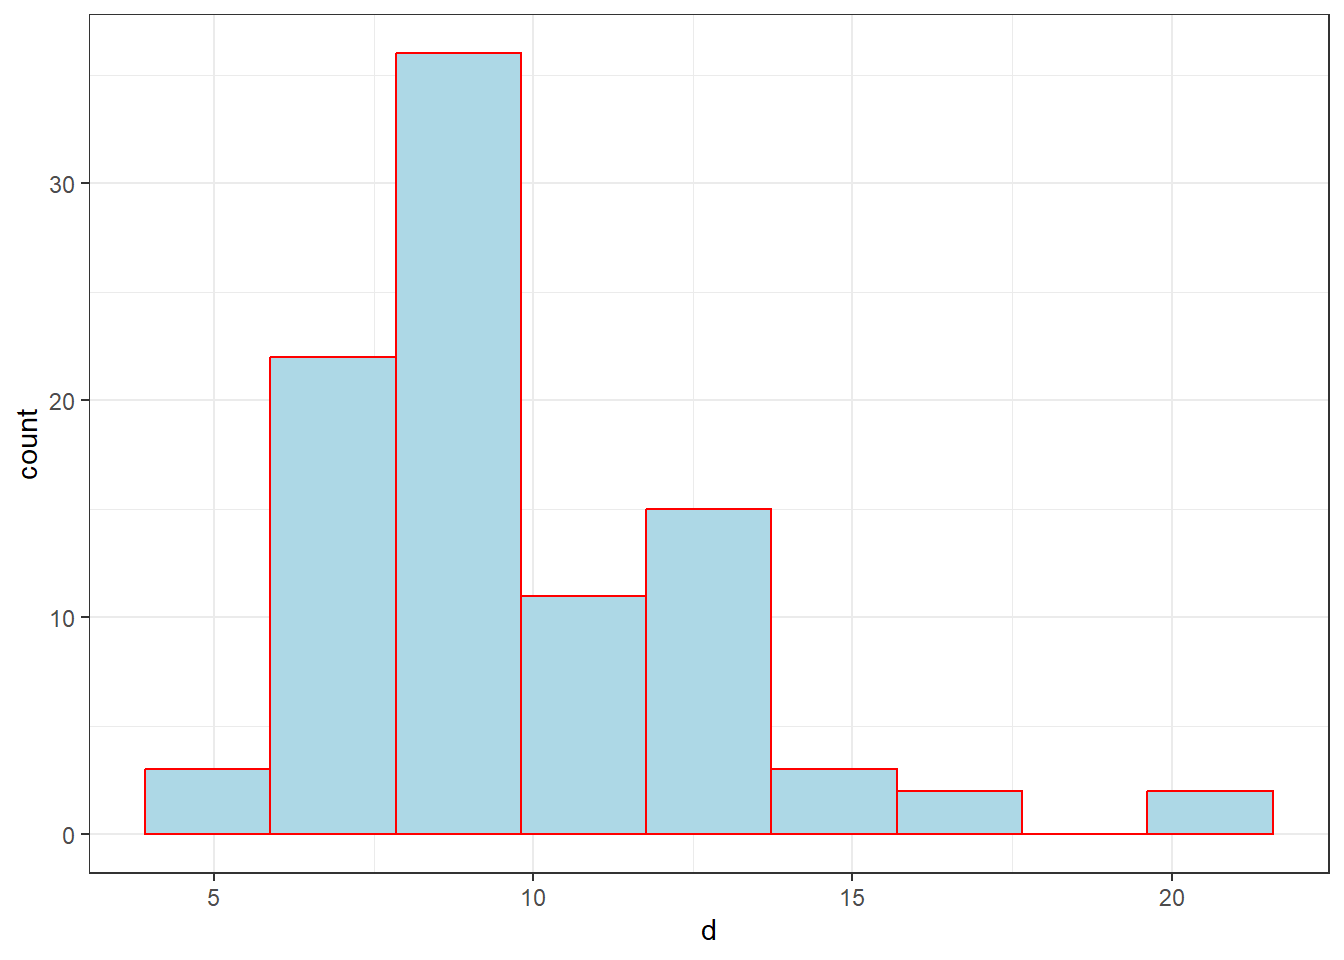
g.base +geom_histogram(bins =9, fill ="lightblue", color ="red") # fill != color
#bin é o número de barras ou classes. Outra opção seria utilizar "binwidth", que especifica a amplitude da barra ou classe#Notar que no ggplot o argumento "color" se refere a linhas, contornos e traços; enquanto o argumento "fill" se refere ao preenchimento de objetos. Normalmente, pontos também não possuem o parâmetro "fill", pois, bem, são apenas pontos; com exceção dos formatos (shape) 21-25, que possuem preenchimento.
Incluindo outra variável
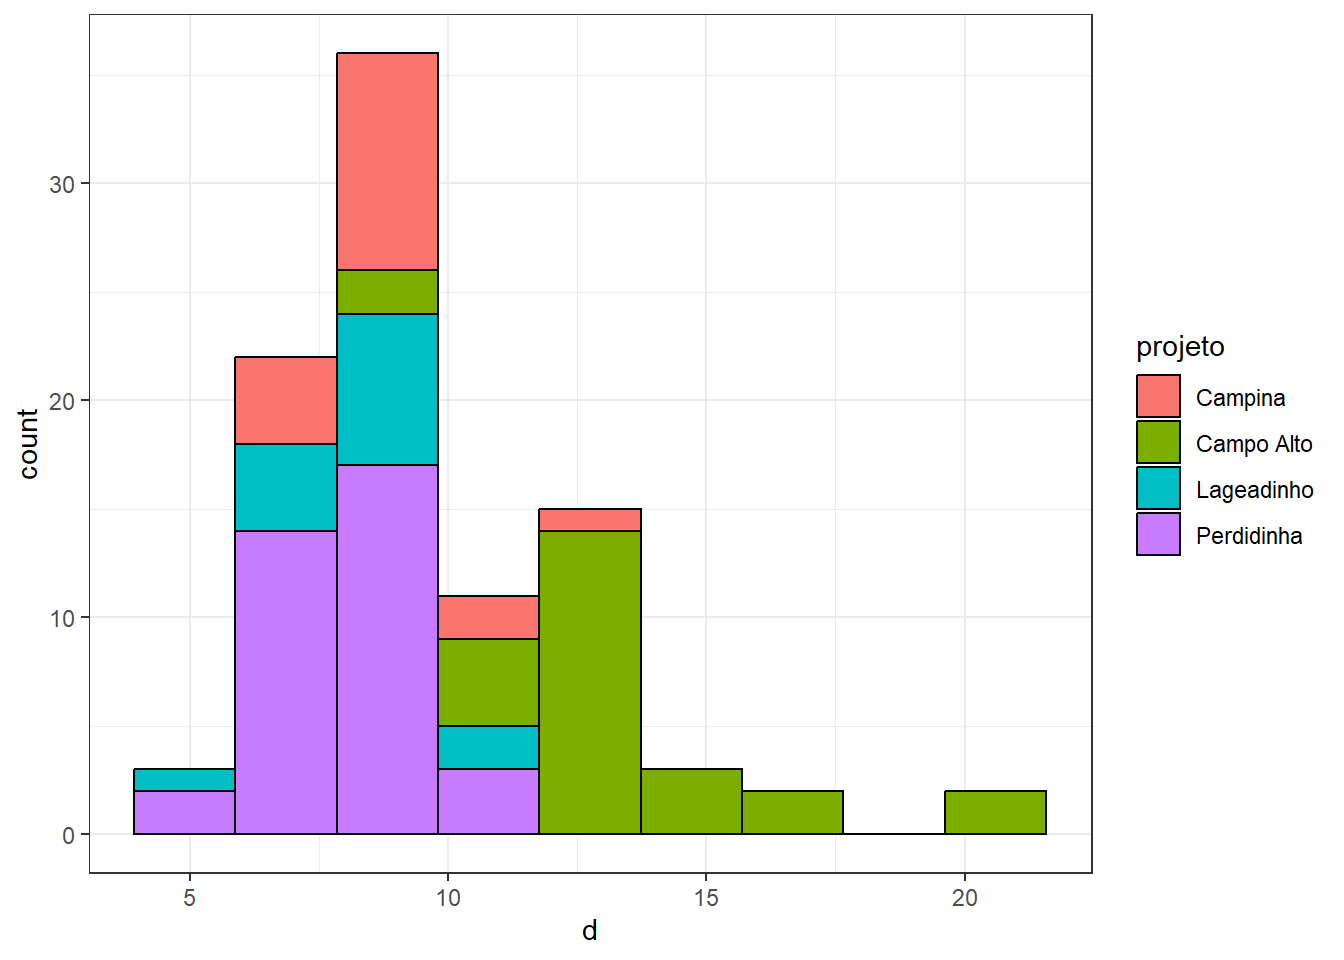
g.base +geom_histogram(aes(fill = projeto), bins =9, color ="black")
Gráfico de barras para variáveis categóricas
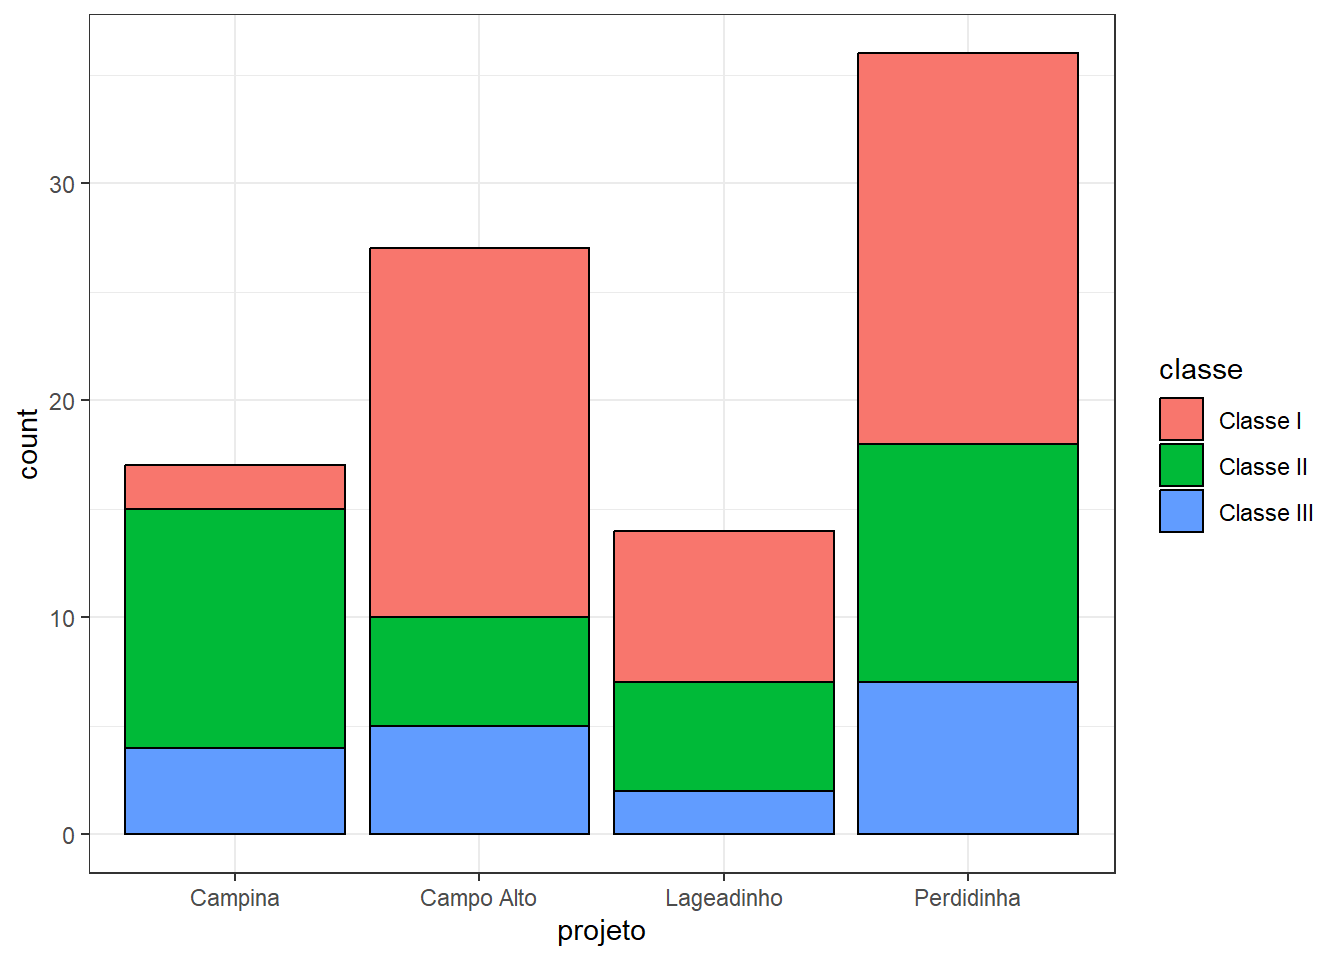
Histogramas são usados para variáveis contínuas, dividindo seus valores em classes ou bins. Para variáveis categóricas, a geometria apropriada é geom_bar(), que conta automaticamente o número de observações em cada categoria.
ggplot(dados) +geom_bar(aes(x = projeto, fill = classe),color ="black")
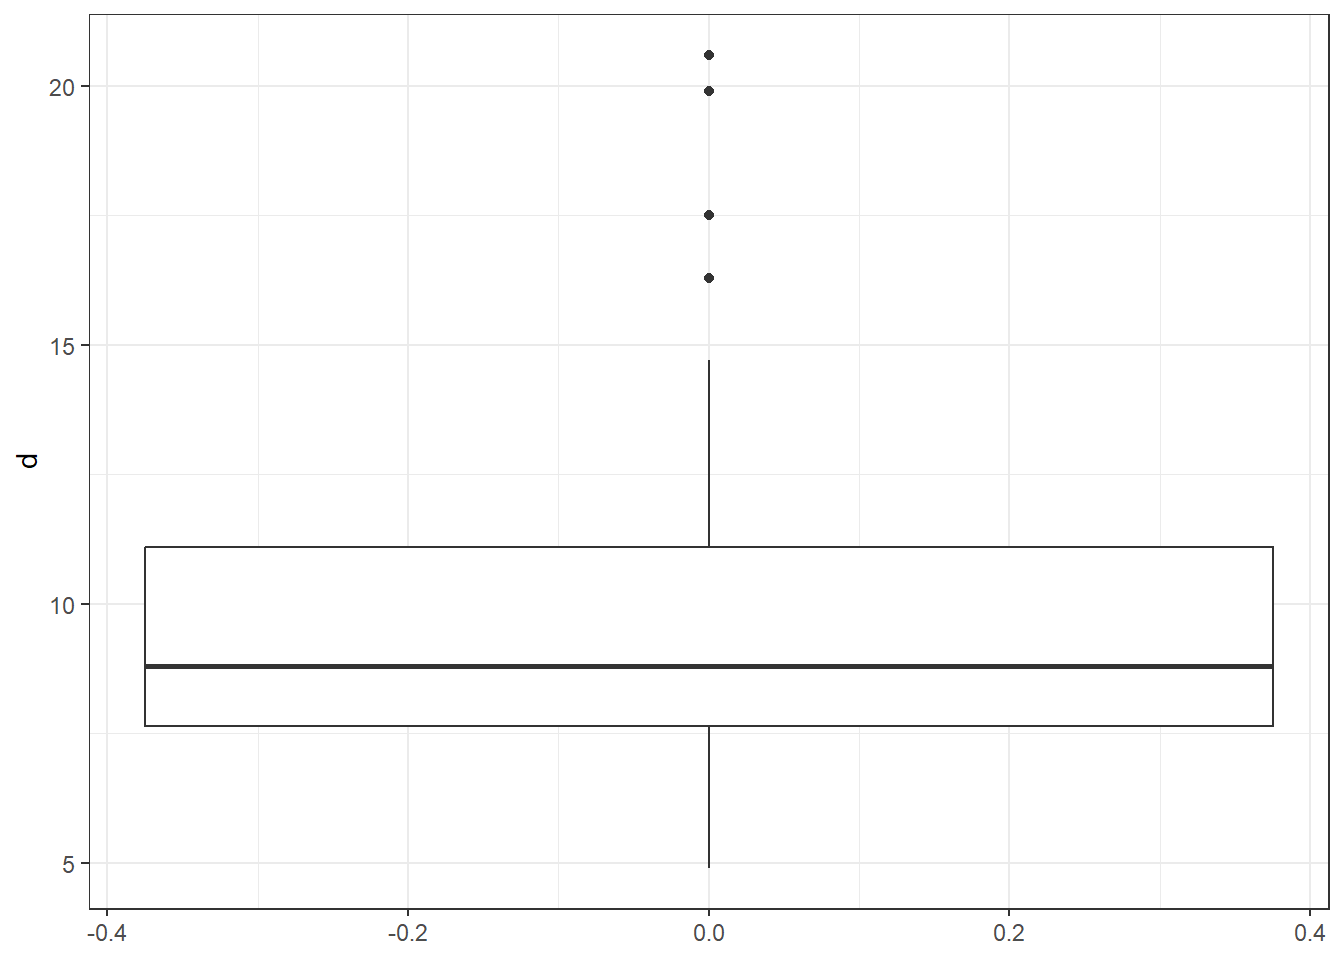
Para comparar distribuições entre grupos, é comum utilizar uma variável categórica em um eixo e uma variável contínua no outro. Entretanto, geom_boxplot() também pode construir um único boxplot utilizando apenas a variável contínua. O exemplo abaixo utiliza o diâmetro no eixo Y.
Forma mais simples
ggplot(dados) +geom_boxplot(aes(y = d))
Adicionando uma variável categórica
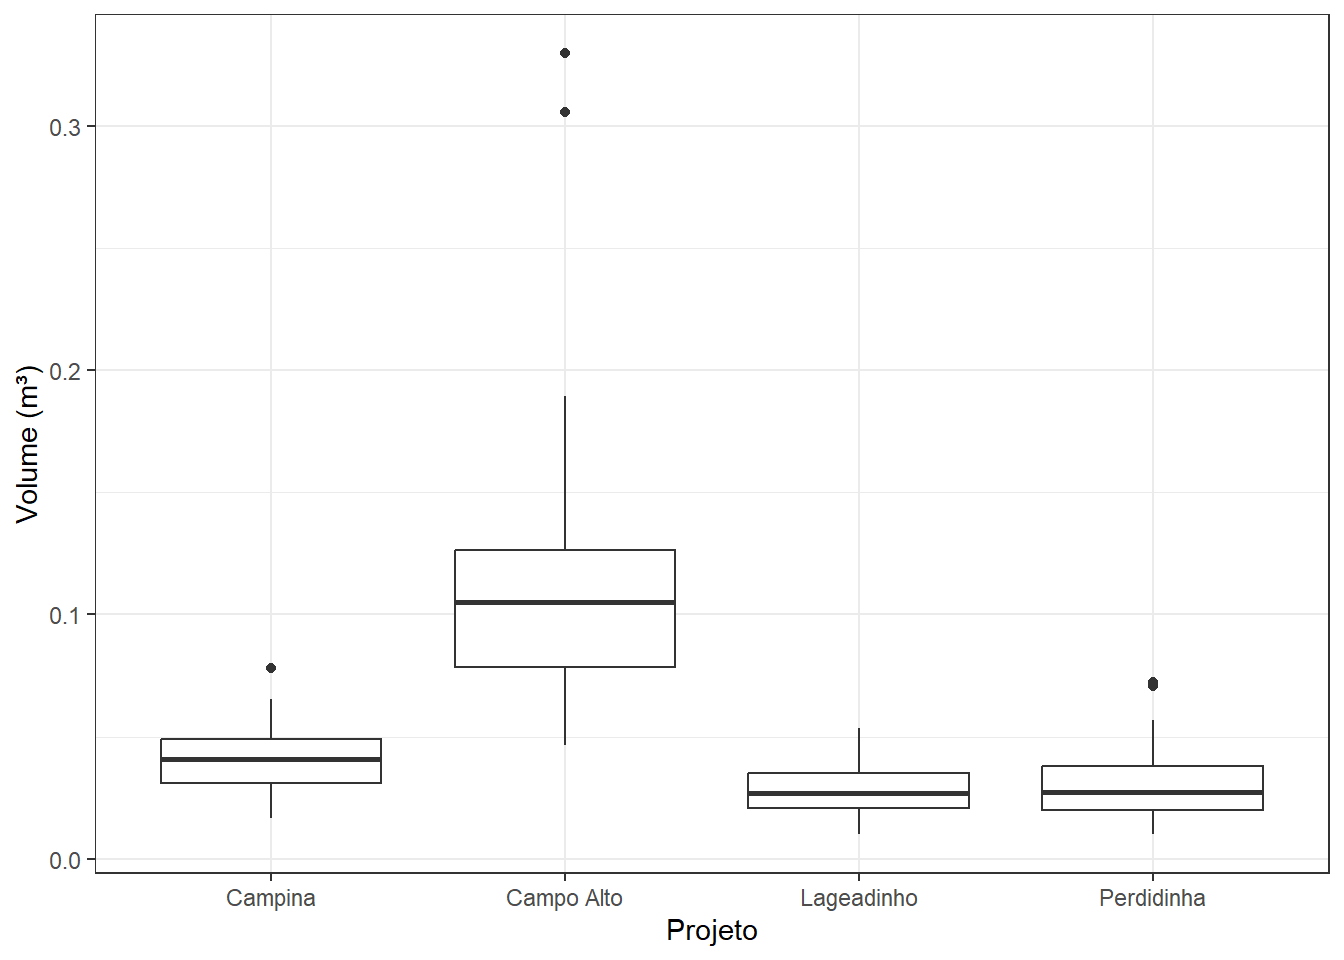
ggplot(dados) +geom_boxplot(aes(x = projeto, y = v)) +labs(x ="Projeto" , y ="Volume (m³)")
Espessura variável
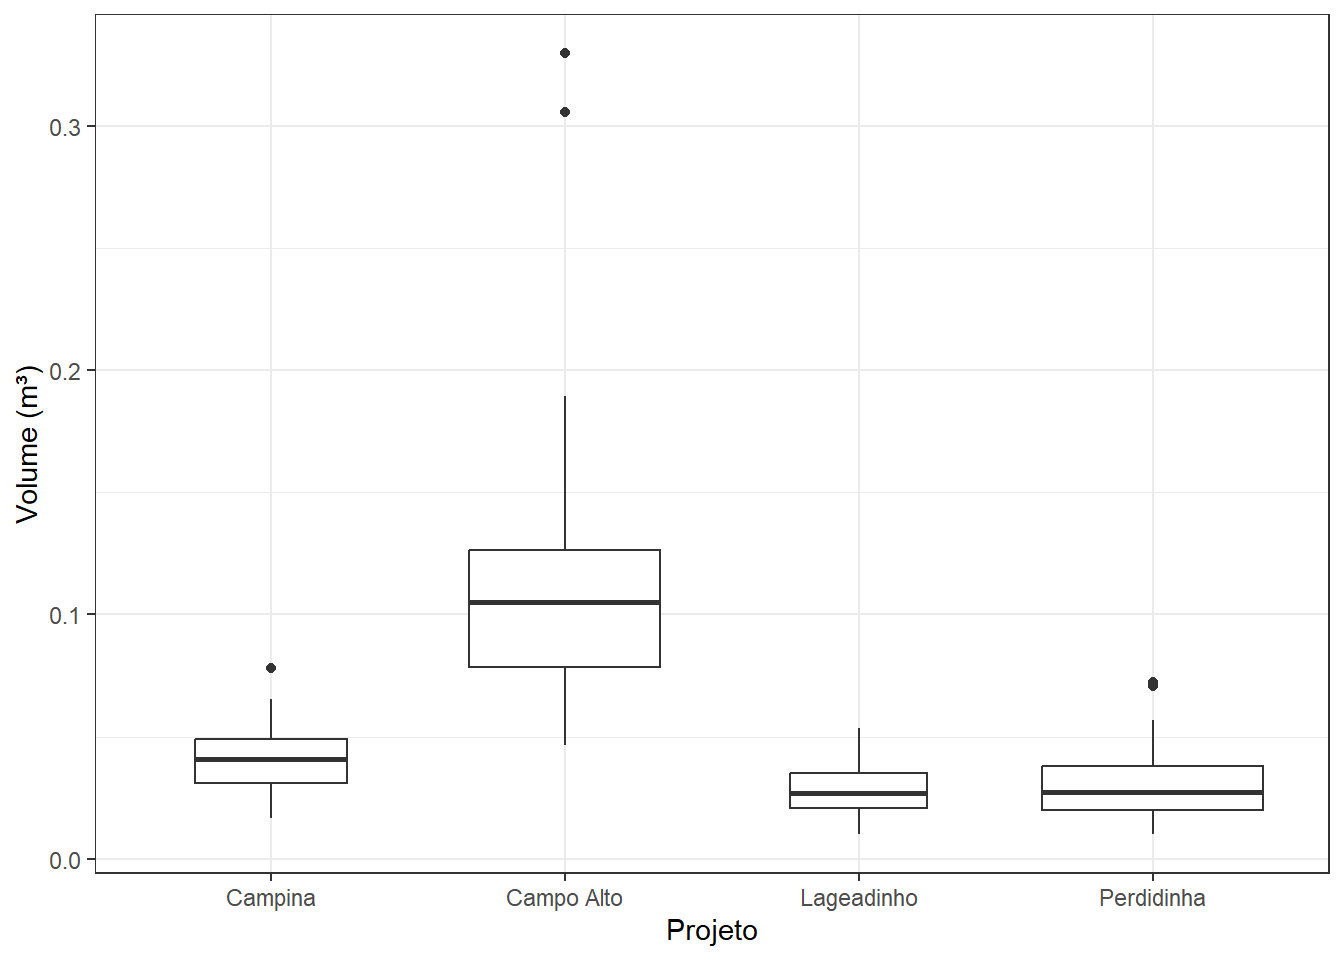
ggplot(dados) +geom_boxplot(aes(x = projeto, y = v), varwidth =TRUE) +labs(x ="Projeto", y ="Volume (m³)")
#O argumento varwidth torna as caixas com espessura proporcional ao número de observações por classe. Mais especificamente, proporcional à raiz quadrada do número de observações.
Tufte Boxplot
usando o pacote ggthemes.
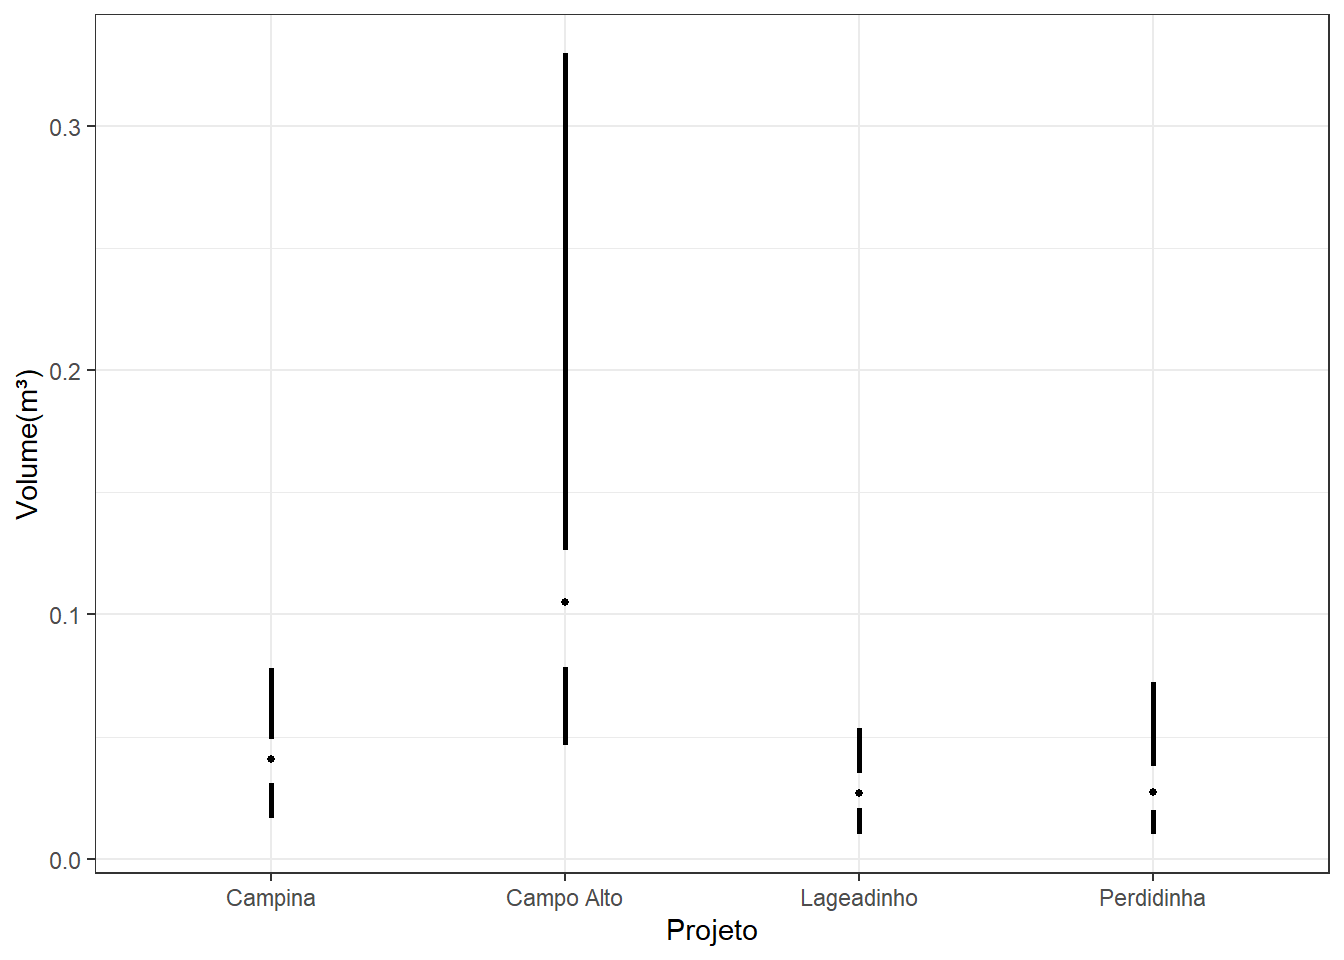
#install.packages("ggthemes")#library(ggthemes)ggplot(dados) +geom_tufteboxplot(aes(x = projeto, y = v, group = projeto), size =1) +labs(x ="Projeto", y ="Volume(m³)")
Warning: The following aesthetics were dropped during statistical transformation: y.
ℹ This can happen when ggplot fails to infer the correct grouping structure in
  the data.
ℹ Did you forget to specify a `group` aesthetic or to convert a numerical
  variable into a factor?
Warning: Using the `size` aesthetic in this geom was deprecated in ggplot2 3.4.0.
ℹ Please use `linewidth` in the `default_aes` field and elsewhere instead.
Warning: Using the `size` aesthetic with geom_segment was deprecated in ggplot2 3.4.0.
ℹ Please use the `linewidth` aesthetic instead.
Desde a versão 3.4.0, o pacote ggplot2 alterou o argumento para espessura de linhas de size para linewidth, para diferenciar do size que se refere ao tamanho de pontos de geom_point(). Entretanto, a função ggthemes::geom_tufteboxplot() não foi atualizada e mantém a sintaxe de size. Até 30/08/2026 a função ainda funciona.
RANKING
Normalmente, uma variável categórica é comparada a uma variável numérica.
Às vezes é interessante apresentar as melhores ou piores classes avaliadas, comparando-as graficamente.
Como exemplo será calculado o volume por hectare médio de cada classe de sítio
  Classe I  Classe II Classe III
 106.09795   80.20125   77.40722
#Como o ggplot recebe a classe de dados data frame, será criado um data.frame para o gráfico.df.ranking <-data.frame(classe =names(vha.classe), vha = vha.classe)df.ranking
               classe       vha
Classe I     Classe I 106.09795
Classe II   Classe II  80.20125
Classe III Classe III  77.40722
Barras
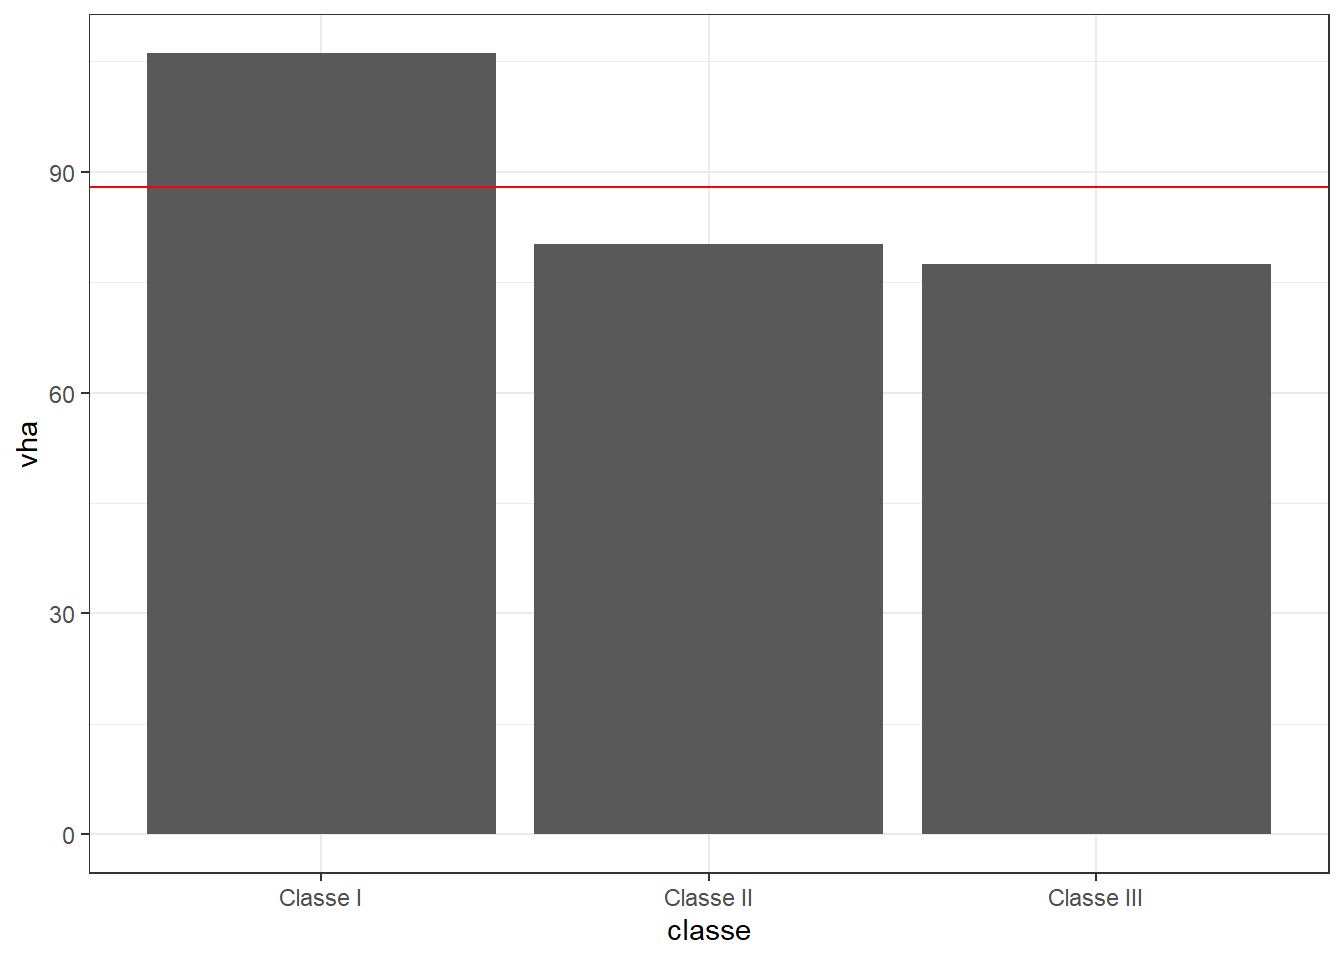
Quando os valores de Y já estão calculados no data frame, como ocorre com vha, a geometria mais direta é geom_col(). Diferentemente de geom_bar(), que usa stat_count() por padrão para contar observações, geom_col() utiliza os valores de Y exatamente como foram fornecidos.
ggplot(df.ranking) +geom_col(aes(x = classe, y = vha)) +geom_hline(yintercept =mean(df.ranking$vha), color ="red")
# Também foi inserida uma linha horizontal, cujo intercepto no eixo Y é a média# dos volumes calculados acima. Isso mostra que pequenos cálculos podem ser# realizados diretamente nos argumentos das camadas do ggplot.
O exemplo acima exemplifica uma situação comum na confecção de gráficos, que é a manipulação e adequação dos dados, para que então possam ser inseridos no ggplot. É imprescindível que o usuário tenha em mente que, para que sejam plotados os valores desejados, esses valores precisam antes ser calculados e arranjados de uma maneira adequada para inclusão no ggplot, tal como no exemplo acima.
Barras coloridas
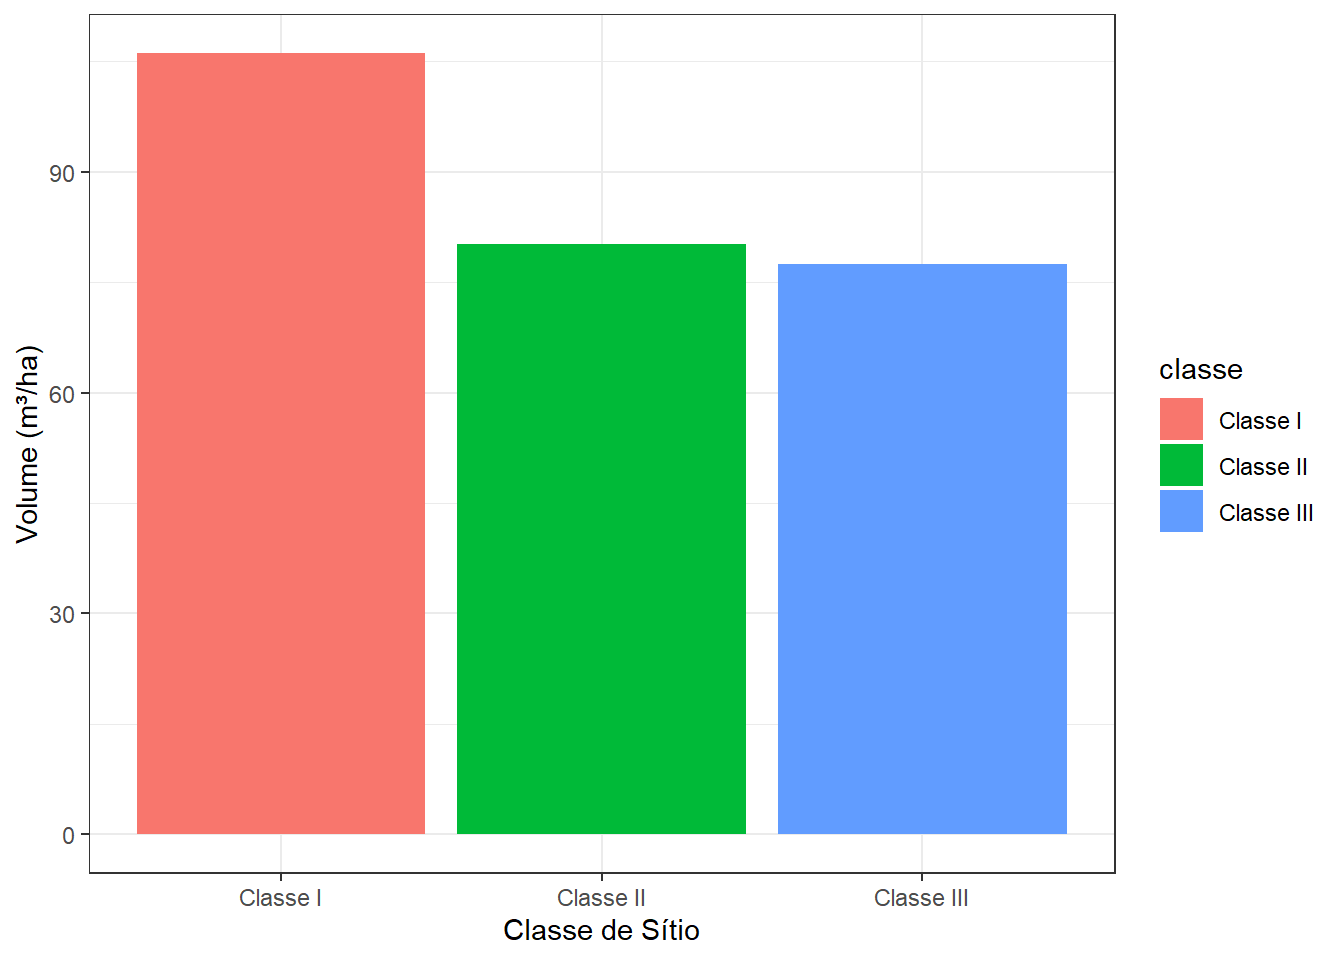
ggplot(df.ranking) +geom_col(aes(x = classe, y = vha, fill = classe)) +labs(x ="Classe de Sítio", y ="Volume (m³/ha)")
Barras ordenadas
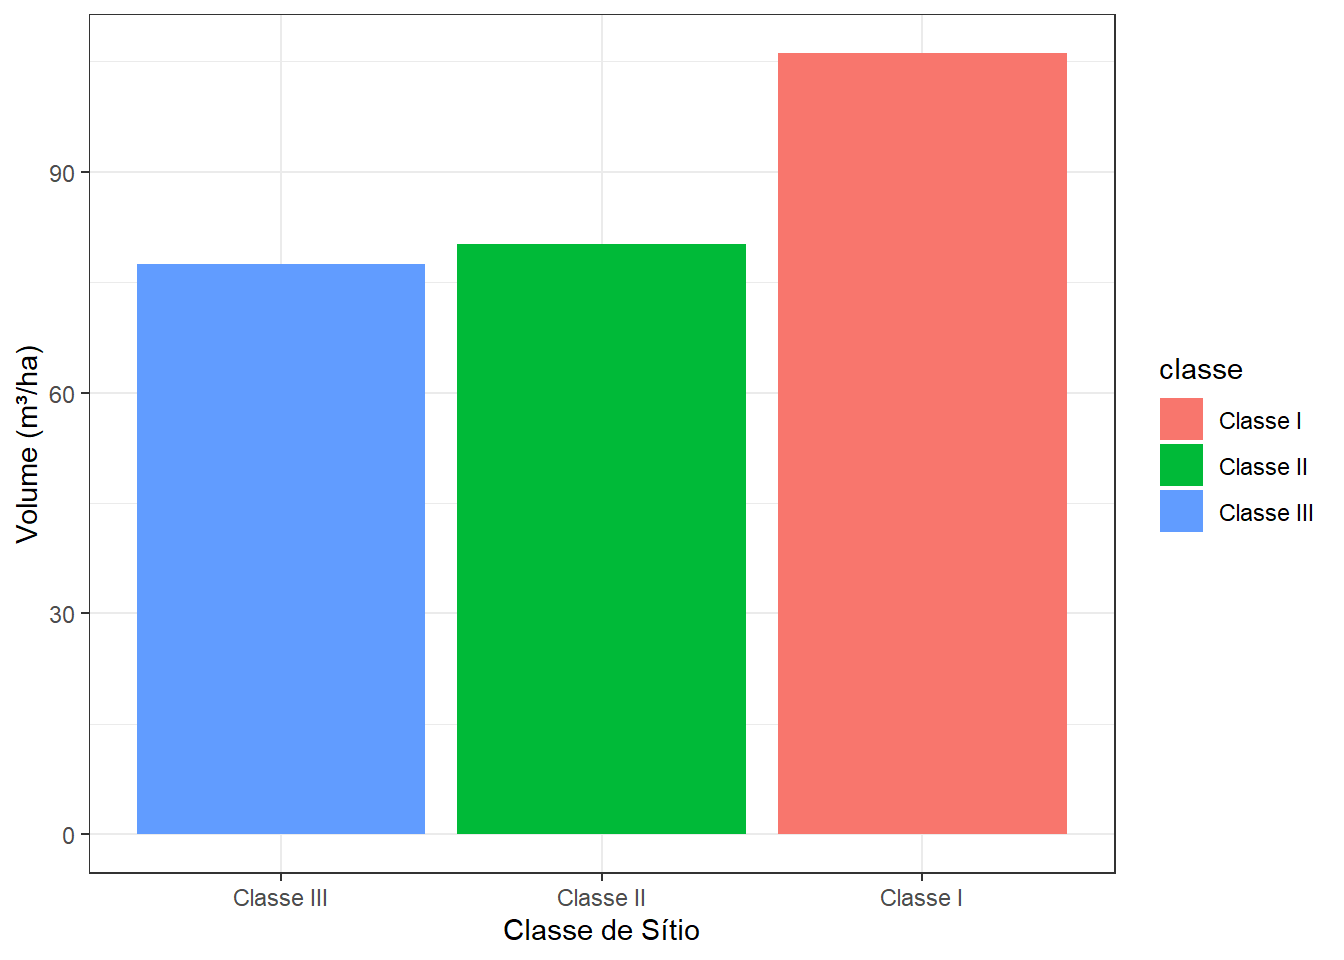
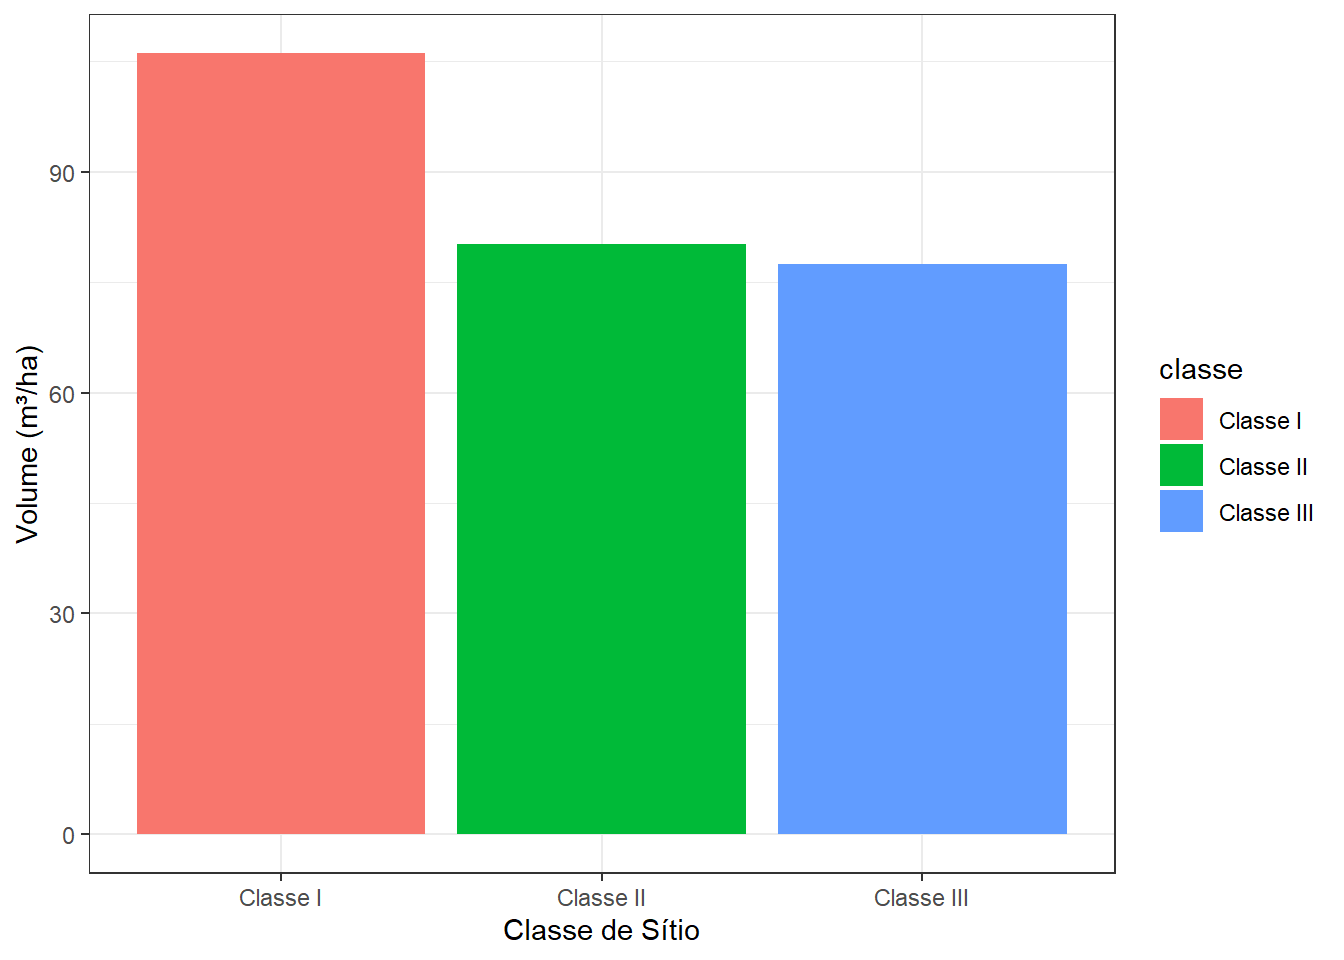
Para alterar a ordem visual das categorias no eixo, não é necessário ordenar previamente as linhas do data frame. O que controla a ordem do eixo discreto é a ordem dos níveis do fator. Uma forma prática é utilizar reorder() diretamente no mapeamento estético.
# A variável classe ainda pode estar armazenada como character:str(df.ranking)
# Ordem crescente de vhaggplot(df.ranking) +geom_col(aes(x =reorder(classe, vha), y = vha, fill = classe)) +labs(x ="Classe de Sítio", y ="Volume (m³/ha)")
# Para ordem decrescente, basta inverter o critério:ggplot(df.ranking) +geom_col(aes(x =reorder(classe, -vha), y = vha, fill = classe)) +labs(x ="Classe de Sítio", y ="Volume (m³/ha)")
Outra possibilidade é transformar explicitamente a variável em fator e informar a ordem desejada no argumento levels. Essa abordagem é útil quando se deseja reutilizar a mesma ordem em vários gráficos.
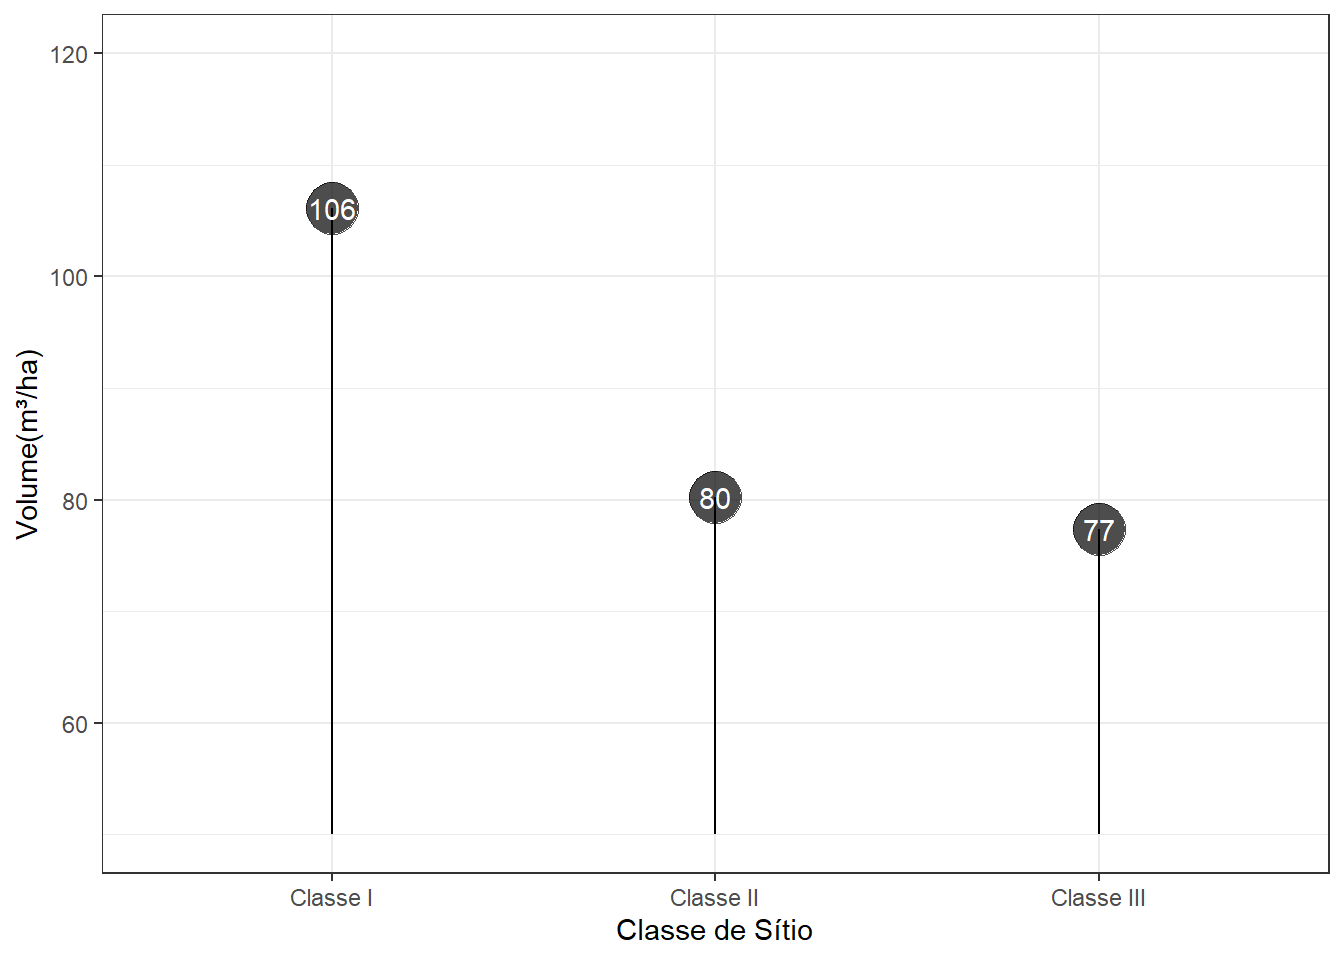
Gráfico de Pirulito
ggplot(df.ranking) +geom_point(aes(x = classe, y = vha), size =9, alpha =0.7) +geom_segment(aes(x = classe, xend = classe, y =50, yend = vha)) +geom_text(aes(x = classe, y = vha, label =round(vha,0)), color ="white") +labs(x ="Classe de Sítio", y ="Volume(m³/ha)") +ylim(50,120)
#geom_segment cria segmentos de reta do ponto (x,y) até o ponto (xend,yend). No exemplo acima, os segmentos de reta, no eixo x, vão de classe até classe, ou seja, não se deslocam no eixo x. E como são 3 classes, são criados três segmentos de reta. Para as posições no eixo Y, foi indicado para os segmentos de reta iniciarem na posição 50, e ir até vha. Como são três valores de vha, são criados três segmentos que vão até seu respectivo valor.#geom_text insere textos no gráfico. A posição é definida por x e y dentro de aes(), e o texto a ser inserido fica contido em label (rótulo). Como se pode perceber, são fornecidos três valores de x (3 classes), 3 de y (3 valores de vha) e 3 rótulos (3 valores de vha).#Por fim, foi definido um limite para o eixo Y de 50-120. Caso contrário, o gráfico define como valor máximo o maior valor de Y plotado (104 nesse caso), e a terceira coluna ficaria tocando o teto do gráfico.
ESCALAS
Escalas controlam como os valores dos dados são traduzidos para propriedades visuais. Isso vale para os eixos X e Y e também para estéticas como color, fill, size, shape, linewidth e linetype.
Escala e legenda não são sinônimos. A escala realiza o mapeamento entre os dados e a estética; quando necessário, esse mapeamento é apresentado por meio de um guia, como um eixo, uma legenda ou uma barra de cores.
As funções de escala geralmente seguem a estrutura scale_estética_tipo(). Por exemplo: scale_color_continuous(), scale_color_discrete(), scale_color_brewer(), scale_color_gradient() e scale_color_manual(). Uma paleta também pode ser classificada como sequencial, qualitativa ou divergente; no caso de gradientes divergentes, por exemplo, uma função bastante utilizada é scale_color_gradient2().
Color
Talvez a escala mais frequentemente utilizada, a escala de cores é utilizada com o grupo de funções scale_color_, e pode receber variáveis numéricas ou categóricas.
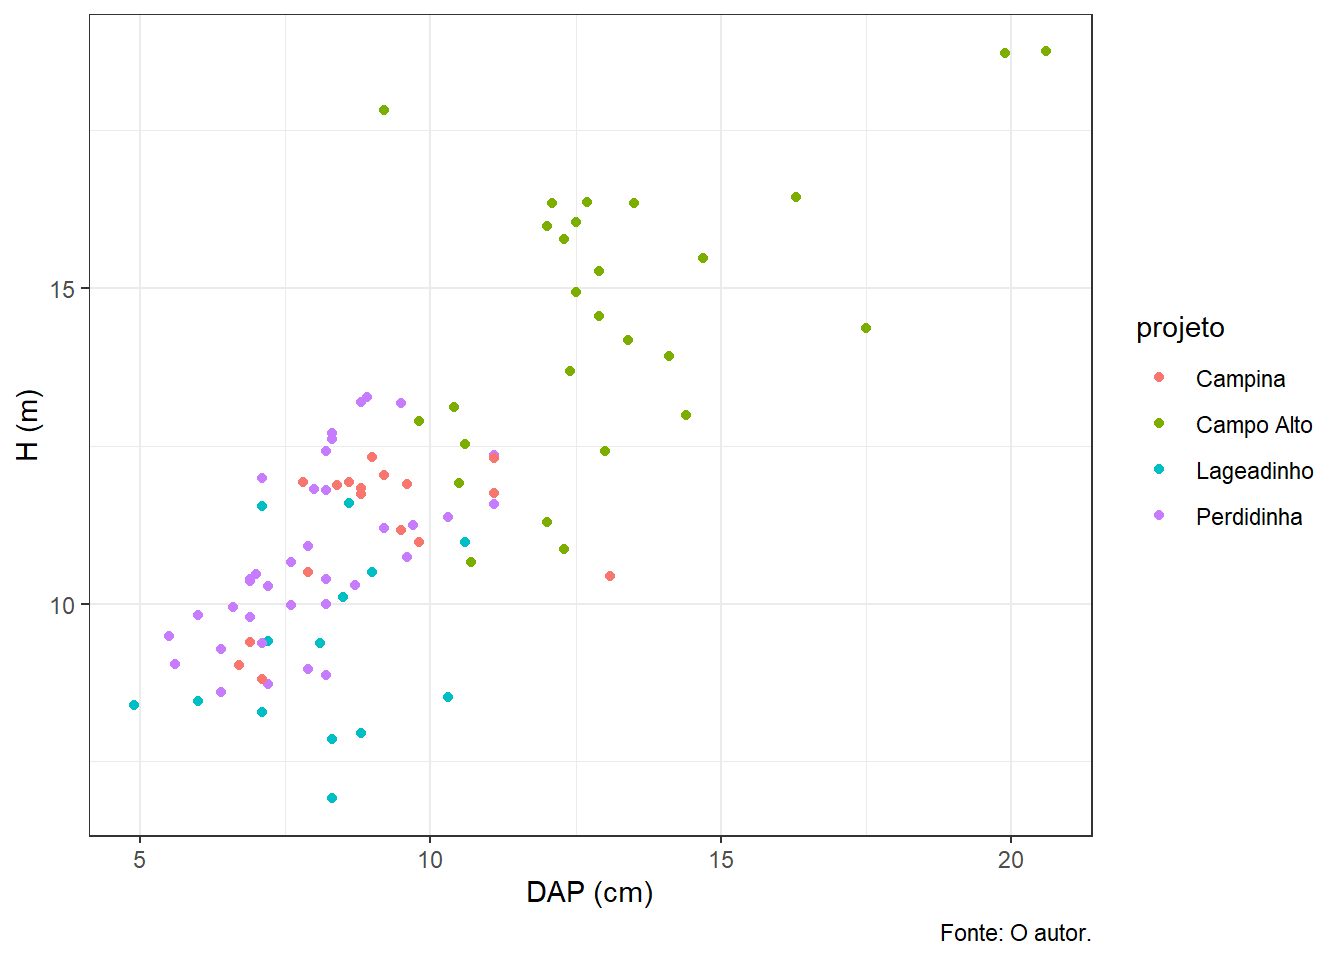
g.base <-ggplot(dados, aes(d,h)) +labs(x ="DAP (cm)", y ="H (m)",caption ="Fonte: O autor.")
scale_color_brewer()
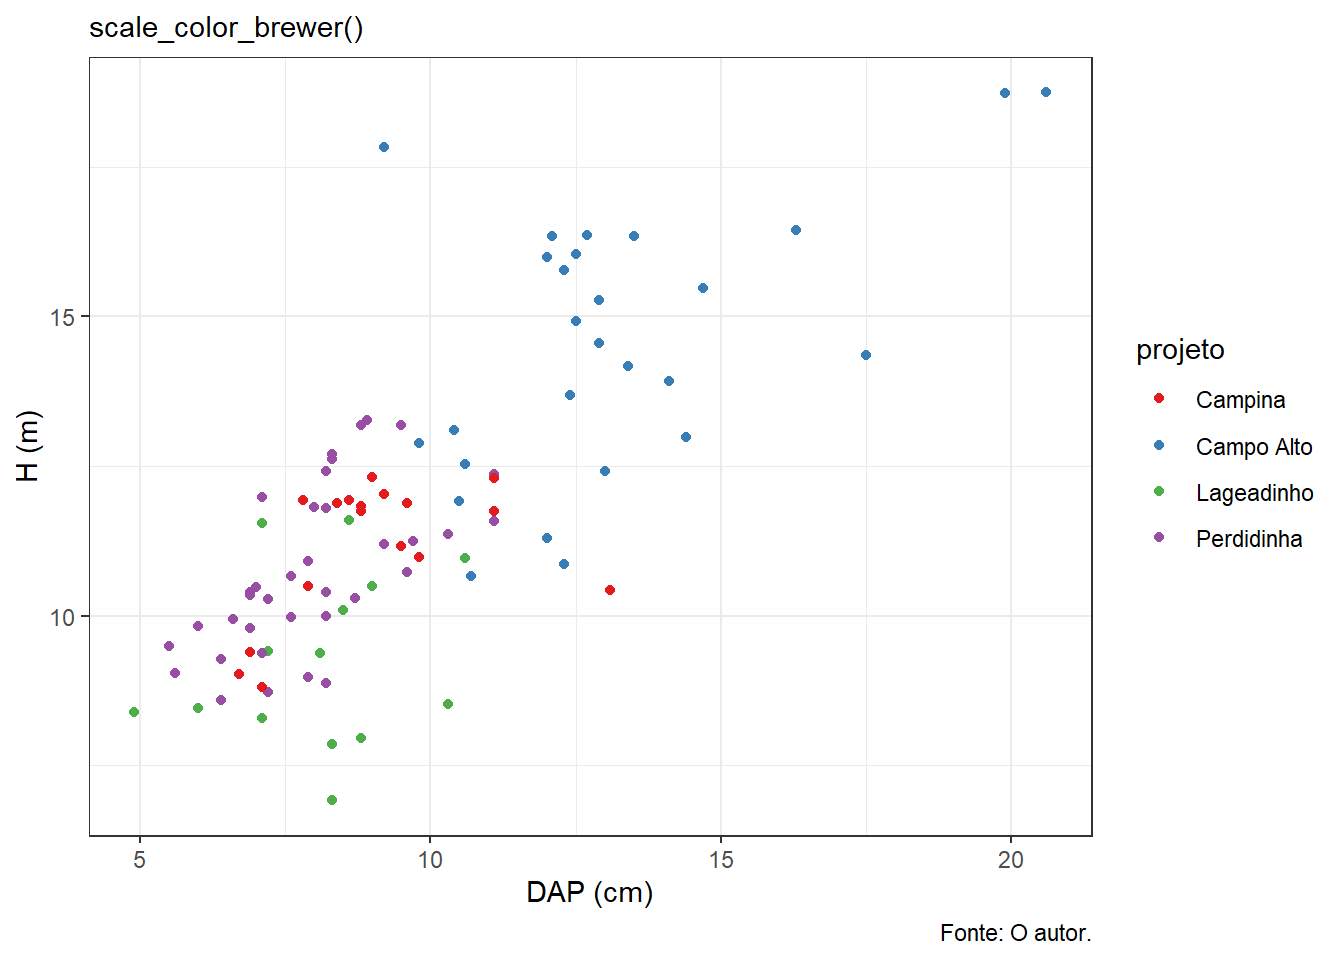
A primeira função apresentada é a scale_color_brewer(). As funções terminadas em brewer usam paletas de cores pré-definidas, e isso é extremamente útil para escolher de forma rápida as cores das classes. Existem paletas específicas para mostrar realces entre classes, escalas sequenciais, escalas para dados qualitativos, etc. É possível conferir cada paleta de cores no site colorbrewer.org.
scale_color_brewer() é destinada a escalas discretas. Portanto, uma variável numérica só deve ser convertida em fator quando a intenção for tratá-la como categórica. Quando a variável deve permanecer contínua, mas se deseja utilizar uma paleta ColorBrewer, pode-se usar scale_color_distiller().
g.base +geom_point(aes(color = projeto))
#Note que, ao utilizar uma variável para compor as cores do gráfico, uma escala de cores é automaticamente criada#Utilizando scale_color_brewer()g.base +geom_point(aes(color = projeto)) +labs(subtitle ="scale_color_brewer()") +scale_color_brewer(palette ="Set1") #Tente também "Dark2", "Spectral" e "Paired".
#"palette" define a paleta de cores utilizada.
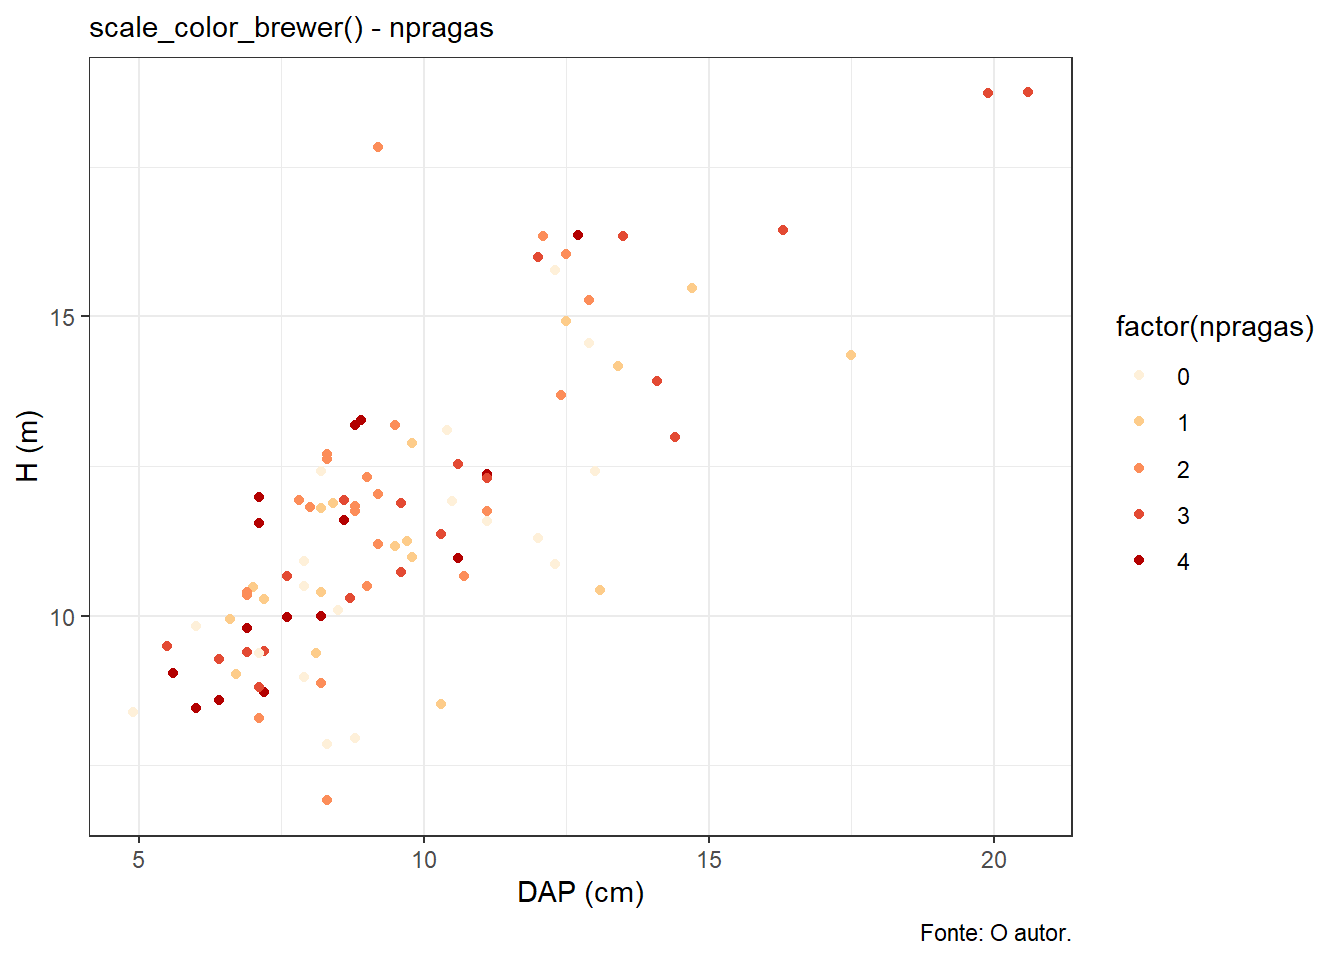
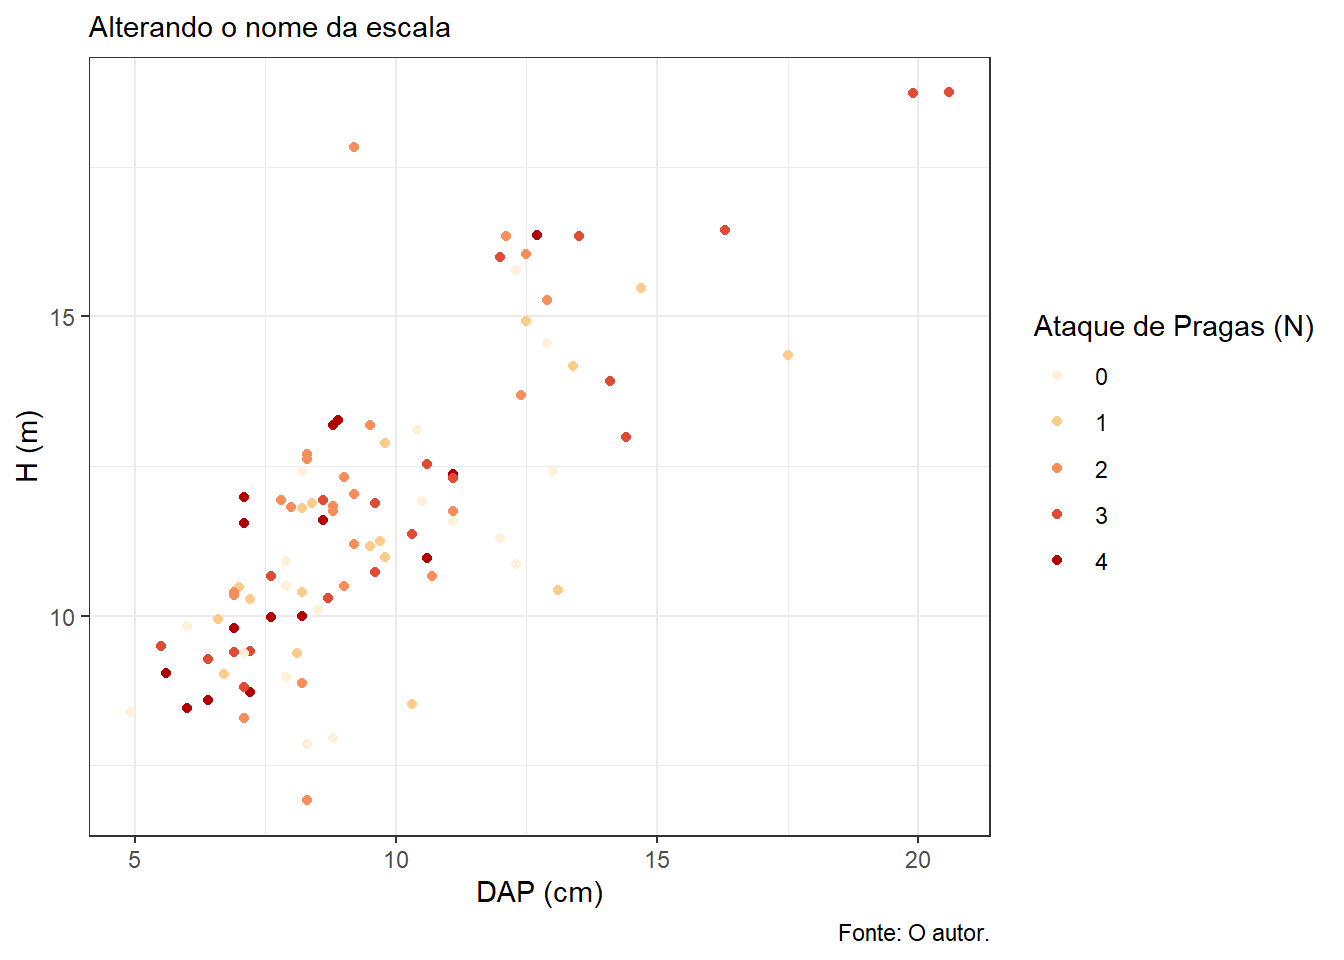
Outro exemplo utiliza o número de ataques de pragas (npragas). Aqui, a variável numérica é propositalmente convertida em categorias com factor(), pois o objetivo é atribuir uma cor discreta a cada contagem.
#Perceba que o nome da legenda é, por padrão, a variável mapeada. Dificilmente uma variável estará escrita corretamente no banco de dados (e.g. "projeto" com p minúsculo, "npragas", "classe" com c minúsculo, etc.). O nome da escala é alterado com o argumento "name".#____________________________________________________g.base +geom_point(aes(color =factor(npragas))) +labs(subtitle ="Alterando o nome da escala") +scale_color_brewer(palette ="OrRd", name ="Ataque de Pragas (N)")
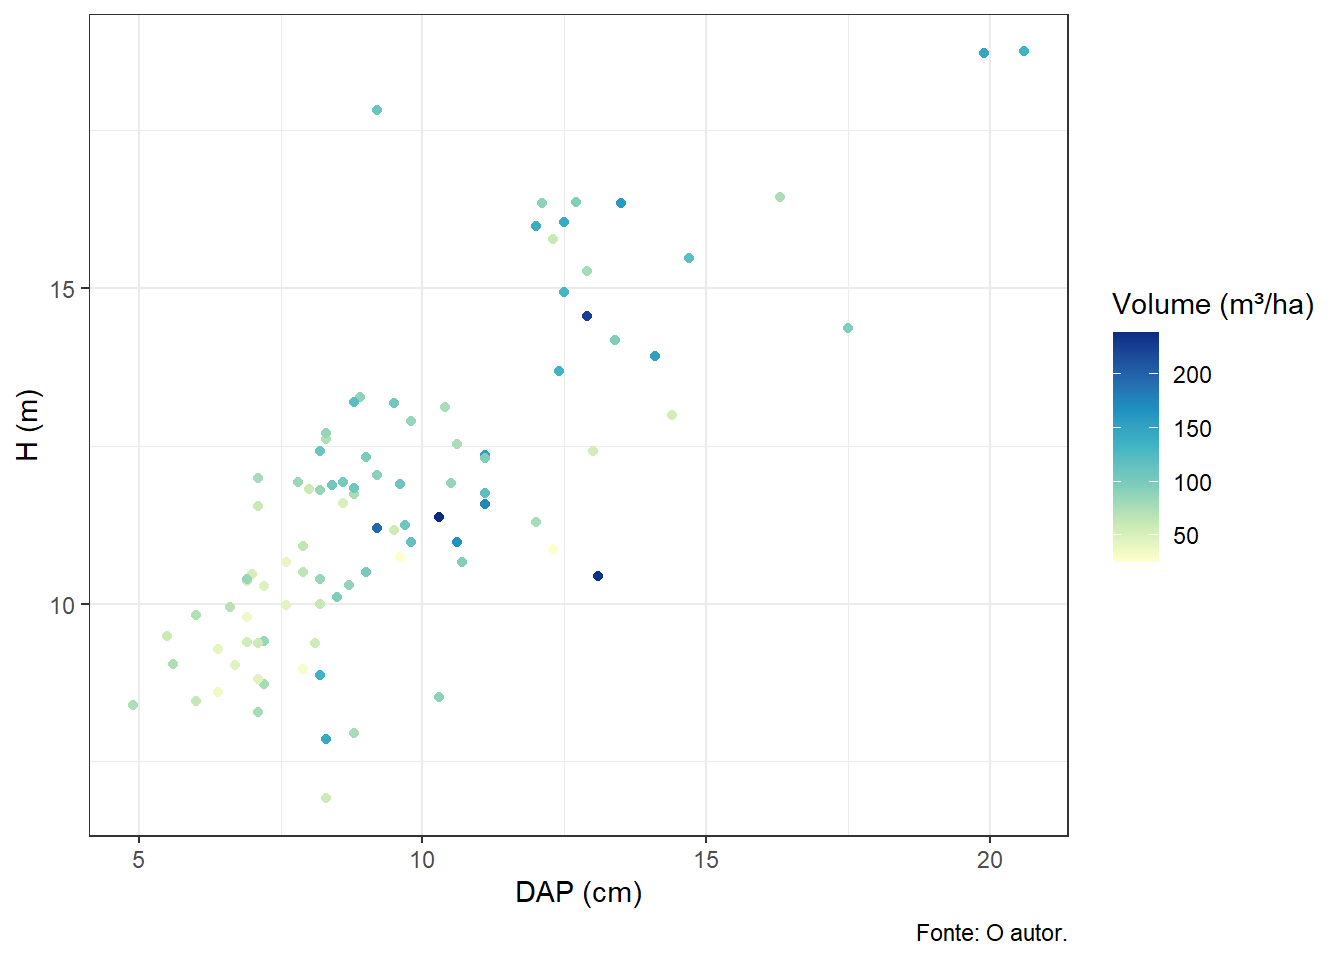
Caso uma variável numérica deva permanecer contínua, uma alternativa com paletas ColorBrewer é:
g.base +geom_point(aes(color = vha)) +scale_color_distiller(palette ="YlGnBu", direction =1,name ="Volume (m³/ha)")
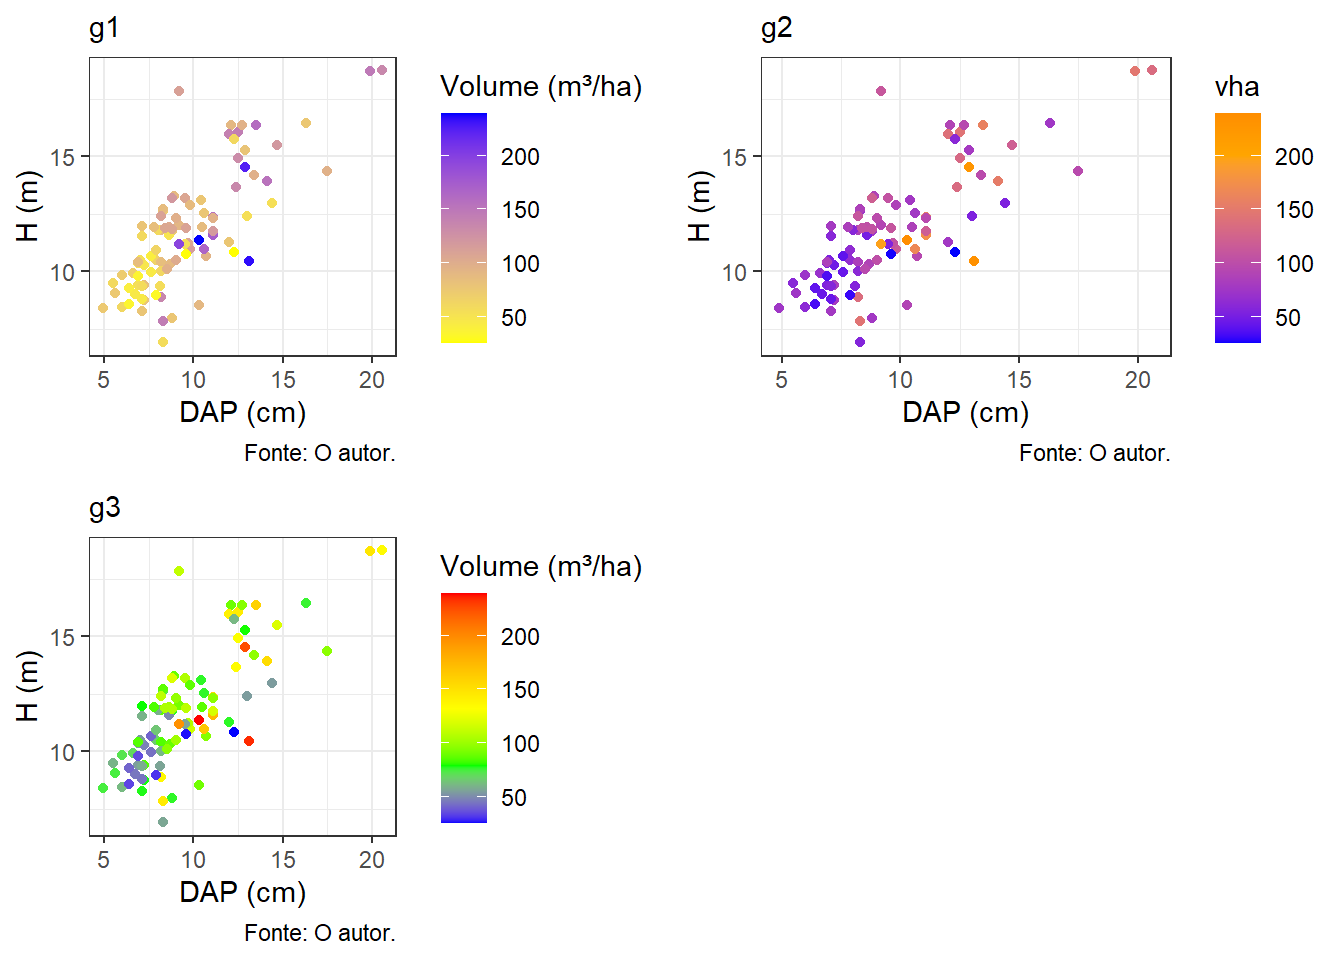
#_gradient() cria uma escala gradiente com base na cor inferior e superior informada#_gradient2() cria uma escala gradiente divergente, especificando uma cor inferior, uma cor no meio da amplitude, e uma cor superior. É também preciso especificar o ponto médio da escala, caso contrário, é definido zero como padrão.#_gradientn() cria uma escala gradiente com base nas n cores informadas.
scale_color_manual()
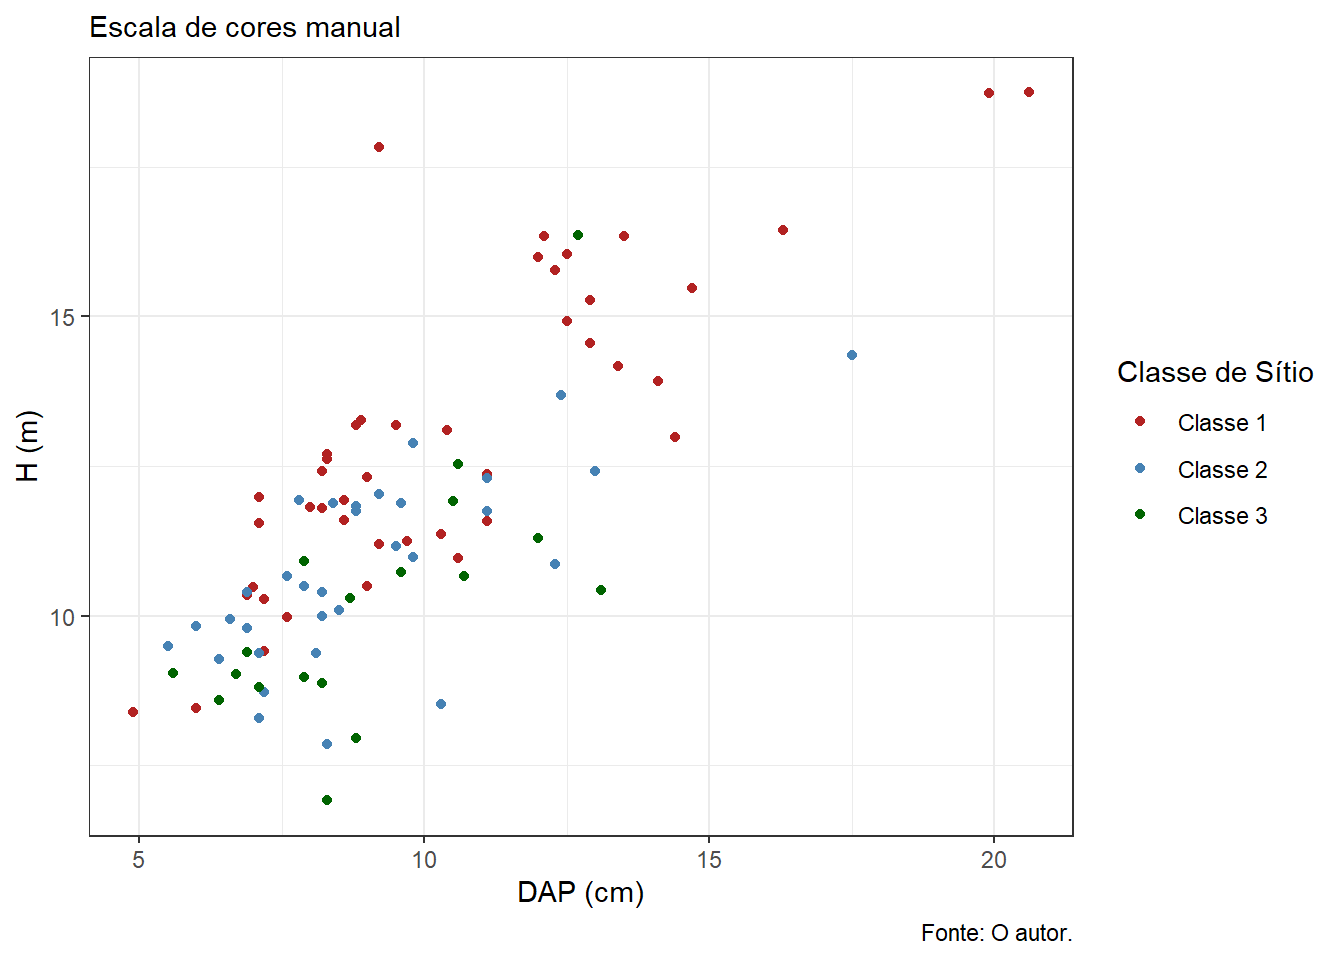
Quando se deseja controle total sobre as cores, é possível informá-las manualmente com as funções _manual().
# values define as cores utilizadas. Em escalas manuais, vetores nomeados são# úteis porque associam explicitamente cada categoria à sua cor.# breaks define quais categorias aparecem e em qual ordem; labels definem# os textos que serão mostrados no guia. Ao informar labels, é recomendável# controlar também breaks para evitar desencontros entre categoria e rótulo.
Tudo manual
Mas, e se não existir uma variável para informar a estética dentro de aes(), como criar a legenda?
Isso é comum quando se está trabalhando com diferentes bancos de dados, por exemplo, um data frame para cada projeto.
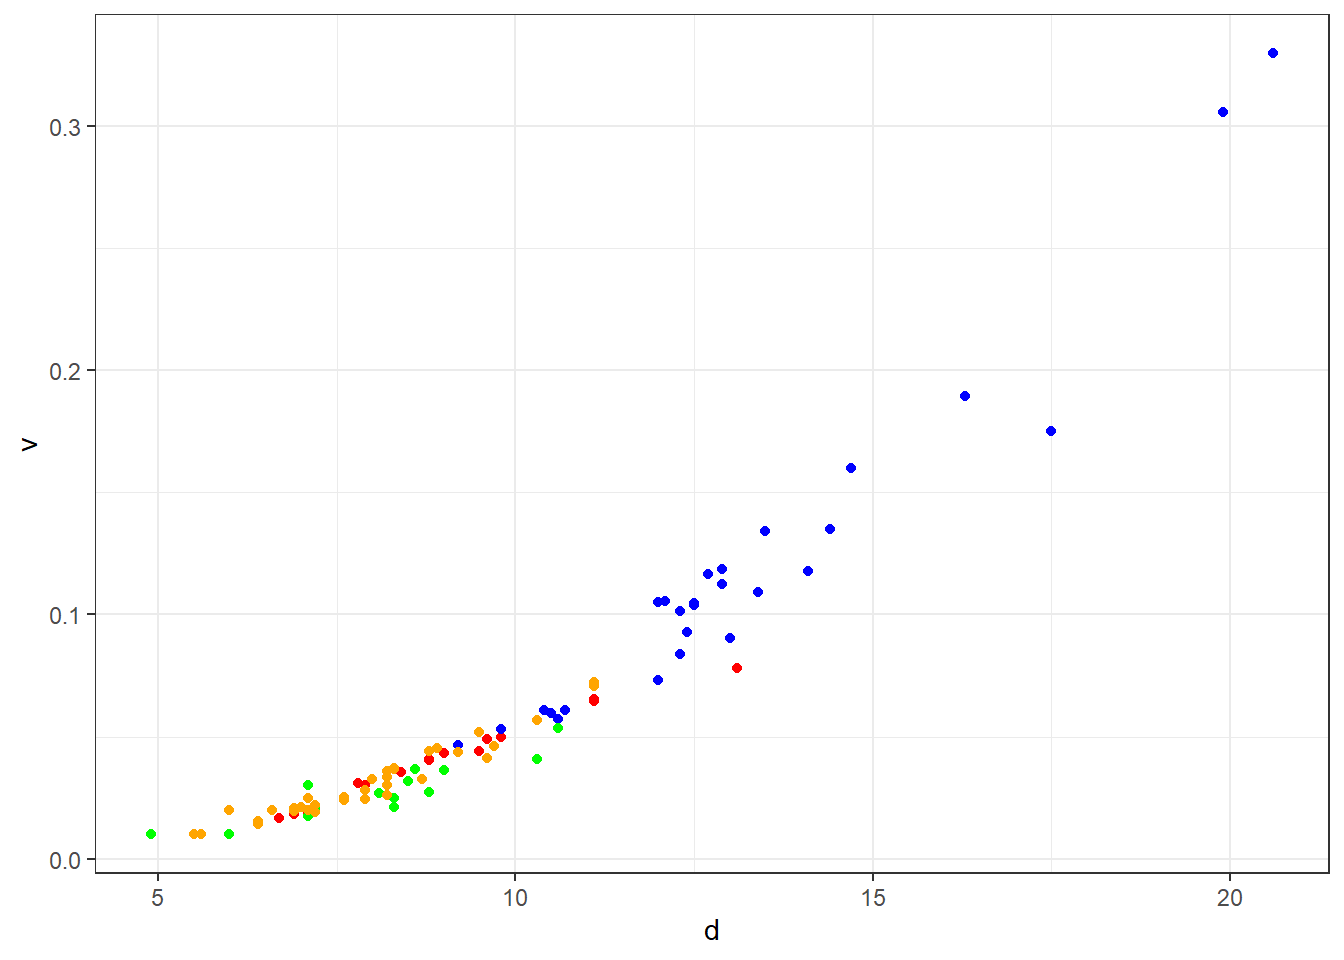
df.p1 <-subset(dados, projeto =="Campina")df.p2 <-subset(dados, projeto =="Campo Alto")df.p3 <-subset(dados, projeto =="Lageadinho")df.p4 <-subset(dados, projeto =="Perdidinha")#________________________________________________________ggplot() +# Os pontos vêm de data frames diferentes, então não há necessidade de definir um data frame global aquigeom_point(data = df.p1, aes(d,v), color ="red") +geom_point(data = df.p2, aes(d,v), color ="blue") +geom_point(data = df.p3, aes(d,v), color ="green") +geom_point(data = df.p4, aes(d,v), color ="orange")
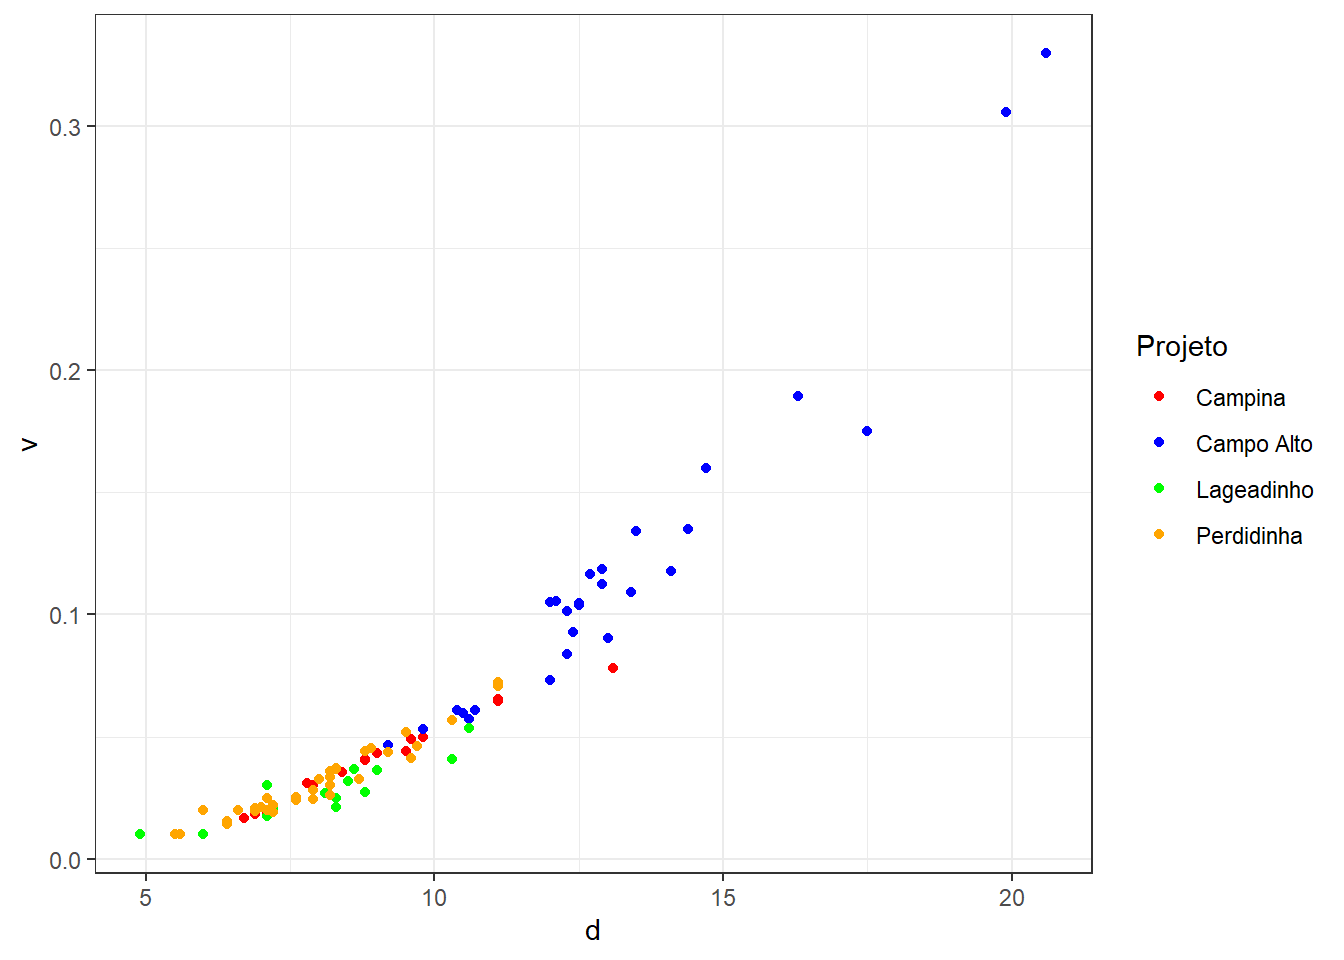
Como nenhuma variável foi mapeada para color, o ggplot não cria um guia de cores. Uma estratégia é mapear, dentro de aes(), uma constante de texto diferente em cada camada. Essas constantes passam a funcionar como categorias de uma escala discreta e podem ser associadas às cores desejadas com scale_color_manual().
ggplot() +geom_point(data=df.p1, aes(d,v, color ="p1")) +geom_point(data=df.p2, aes(d,v, color ="p2")) +geom_point(data=df.p3, aes(d,v, color ="p3")) +geom_point(data=df.p4, aes(d,v, color ="p4")) +scale_color_manual(name ="Projeto", values =c("p1"="red", "p2"="blue","p3"="green","p4"="orange"),labels =c("p3"="Lageadinho","p1"="Campina","p4"="Perdidinha","p2"="Campo Alto"))
# Perceba que em geom_point() foi utilizado um nome qualquer apenas para mapear a cor, e consequentemente gerar uma escala para isso. Já em scale_color_manual(), cada nome vinculado com uma cor específica no argumento values, bem como cada nome foi vinculado com um rótulo específico no argumento labels. Note também que, uma vez que cada nome é vinculado a um rótulo específico, não há necessidade de informar os campos em alguma ordem específica.#Caso o nome do projeto fosse escrito diretamente nos geom_point(), o argumento labels poderia ser omitido.
`geom_smooth()` using method = 'loess' and formula = 'y ~ x'
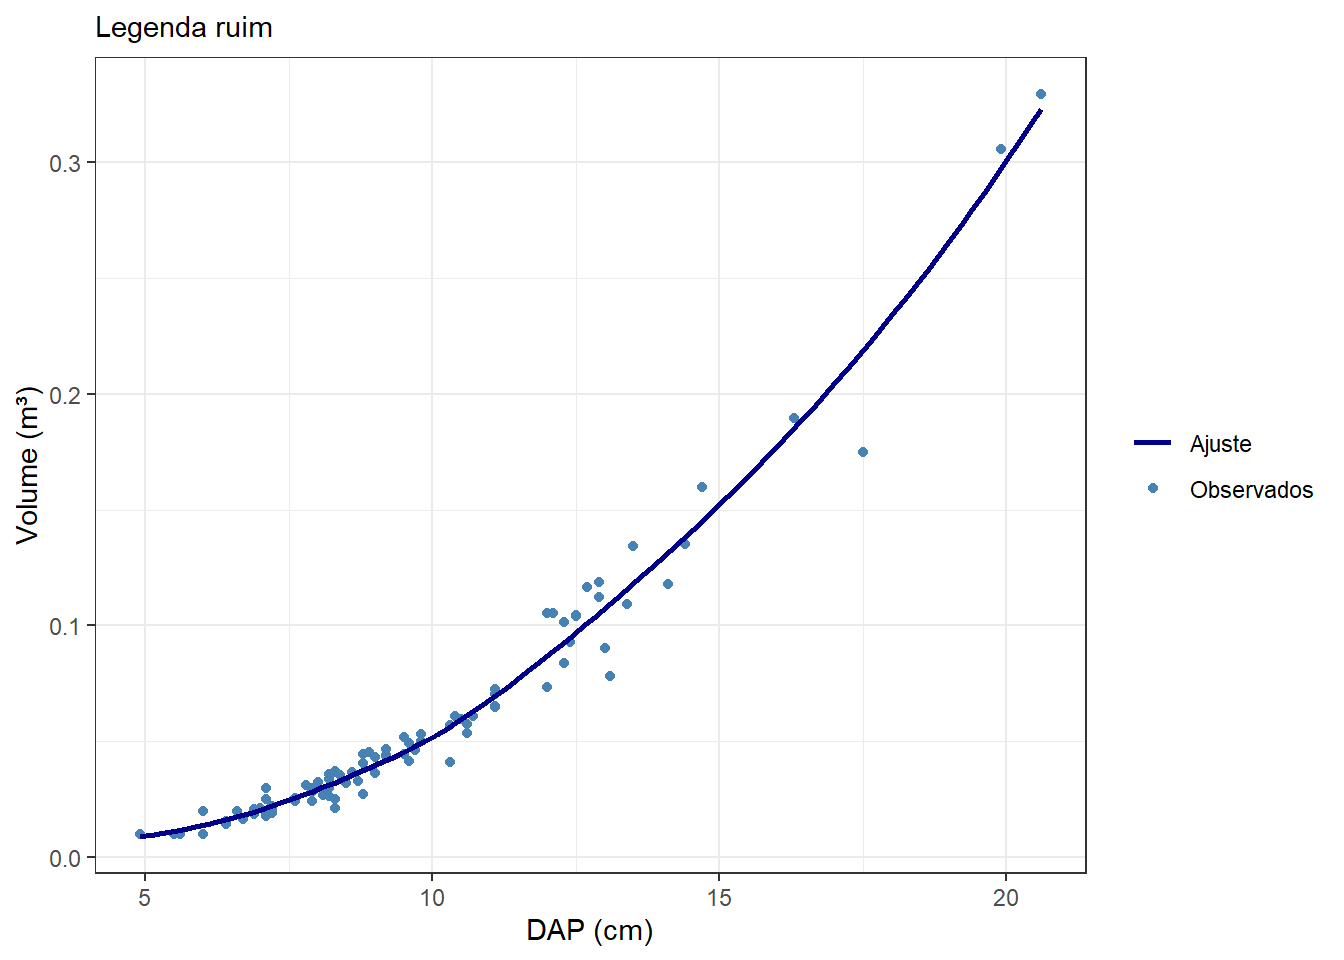
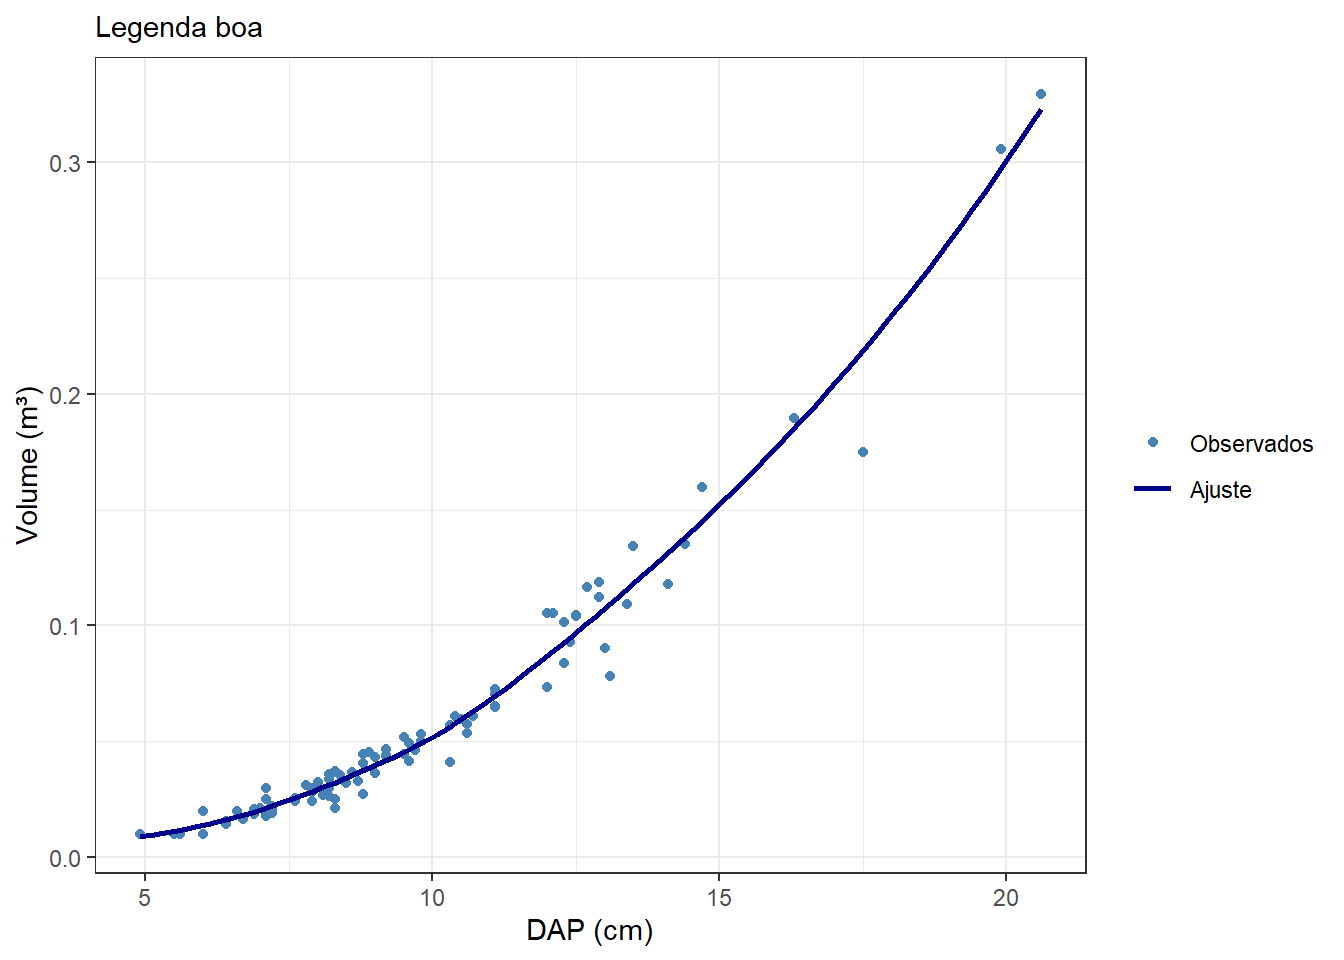
Desde o ggplot2 3.5.0, as legendas passaram a identificar automaticamente quais camadas estão associadas a cada categoria. Assim, no exemplo abaixo, "Observados" é representado apenas por um ponto e "Ajuste" apenas por uma linha, sem necessidade de ajustes adicionais.
Ainda assim, é mantida uma maneira de escrita totalmente manual, utilizando guides() e seu argumento override.aes=..., que permite personalizar manualmente a legenda e seus símbolos.
`geom_smooth()` using method = 'loess' and formula = 'y ~ x'
# color = indica que a modificação será feita no guia associado à escala de cores.# override.aes substitui apenas a aparência dos símbolos da legenda, sem alterar o gráfico.# shape = c(16, NA): o item "Observados" aparece como ponto e "Ajuste" sem ponto.# linetype = c(NA, 1): "Observados" aparece sem linha e "Ajuste" com linha contínua.
Fill, Shape, Size, Linewidth, Linetype…
Para nossa alegria, quase todas as demais escalas (scale_fill_, scale_size_, scale_shape_, scale_linetype_…) funcionam de maneira igual ou semelhante à apresentada na escala de cores
X e Y
Como mencionado anteriormente, as variáveis mapeadas em X e Y também recebem uma escala, e são apresentadas como os eixos X e Y, porém elas também podem ser manipuladas, de maneira similar às demais. As funções são escritas com scale_x_ e scale_y_.
Dentre as opções de escala, estão _continuous(), _discrete(), _log10(), _reverse(), _date(), _sqrt() e _time().
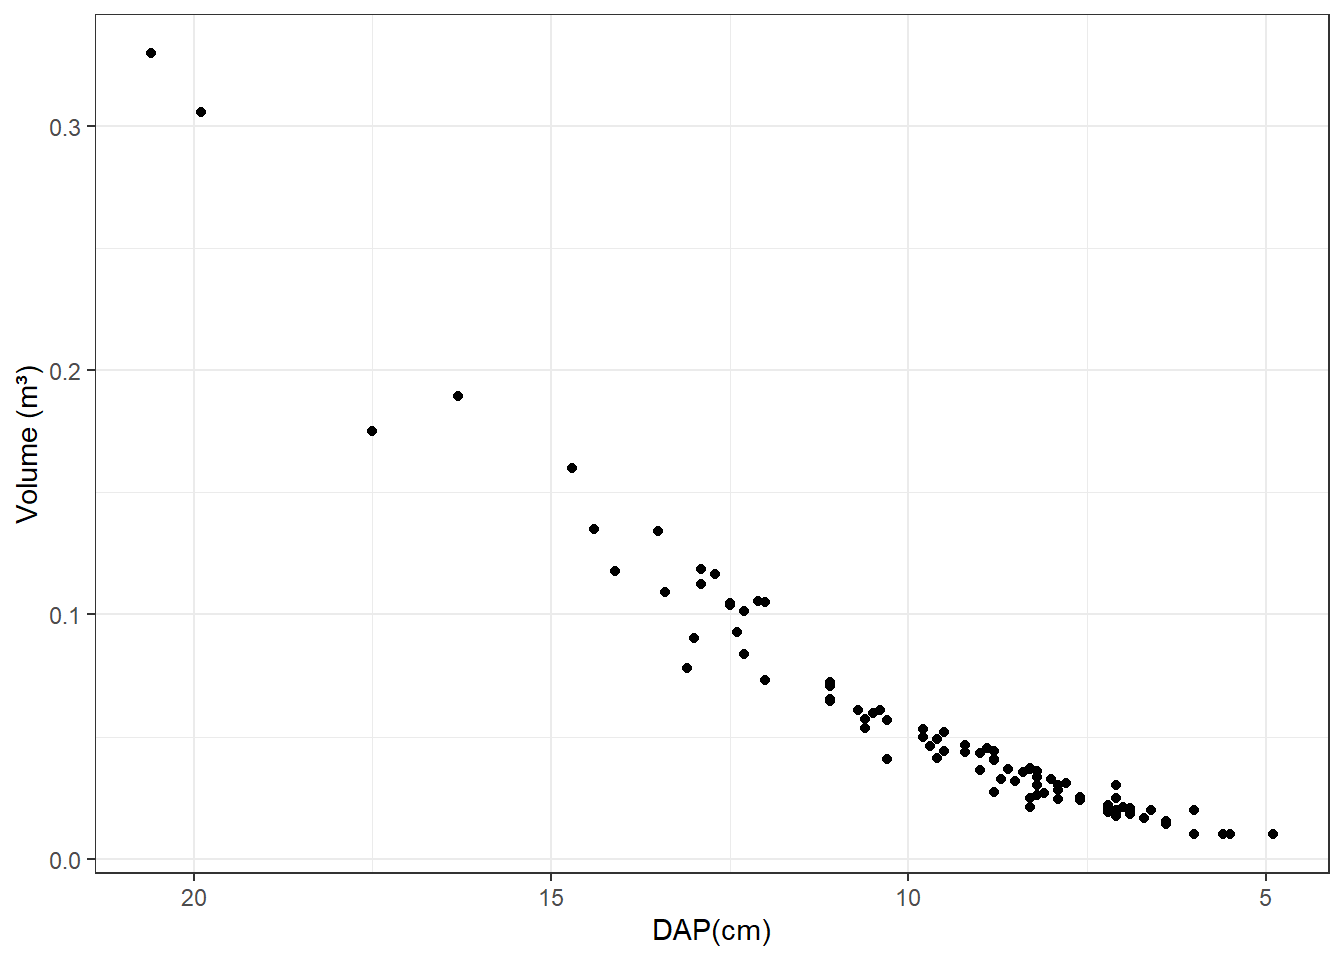
Como se pode perceber, é possível organizar os eixos de acordo com o tipo de variável inserida, como datas ou tempo, e ainda fazer transformações dos dados, como raiz quadrada ou logaritmo. Também é possível inverter a escala com _reverse().
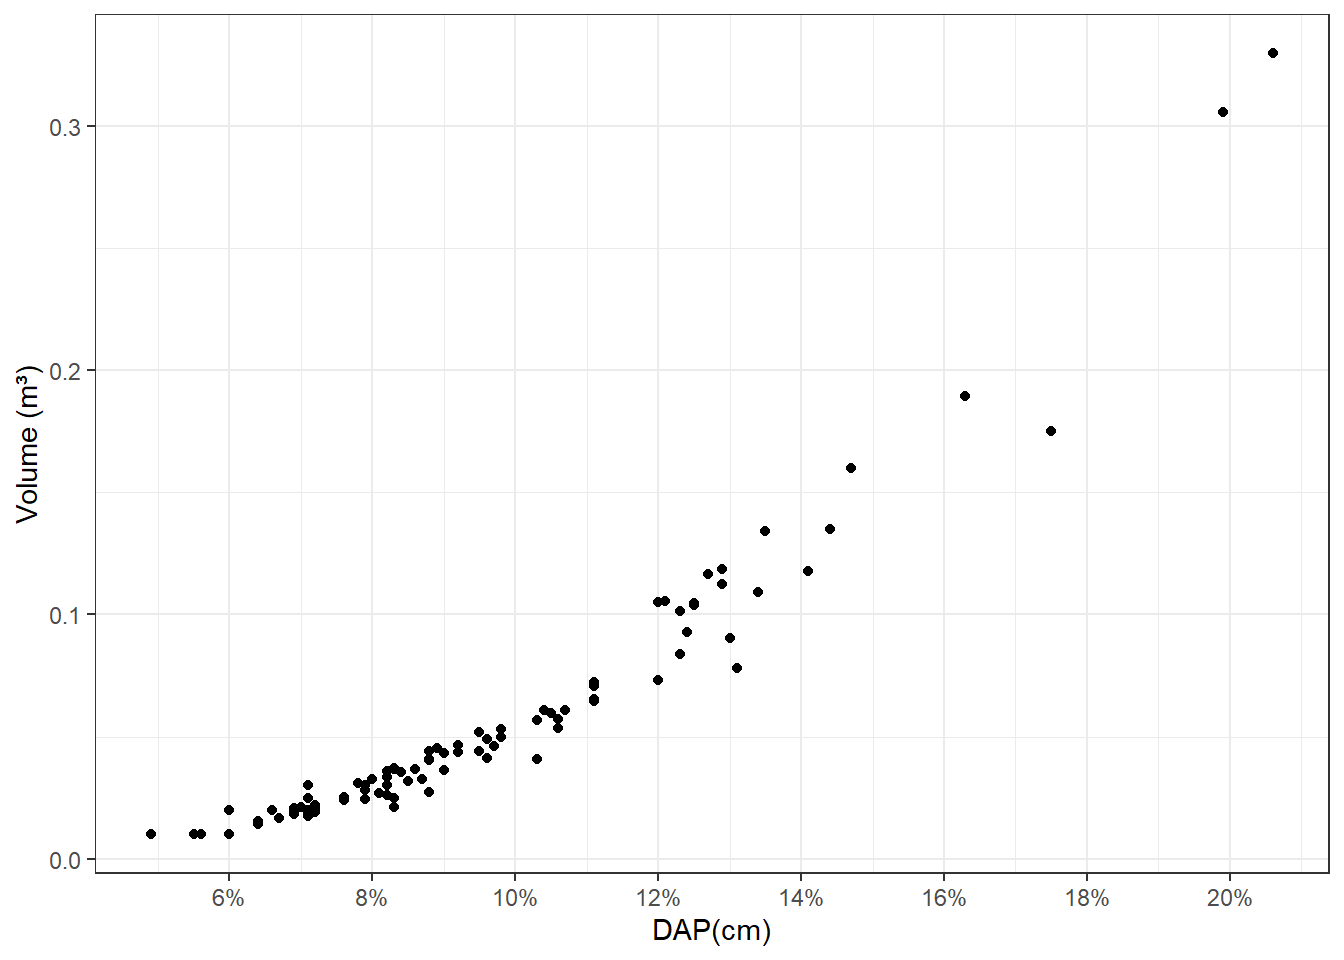
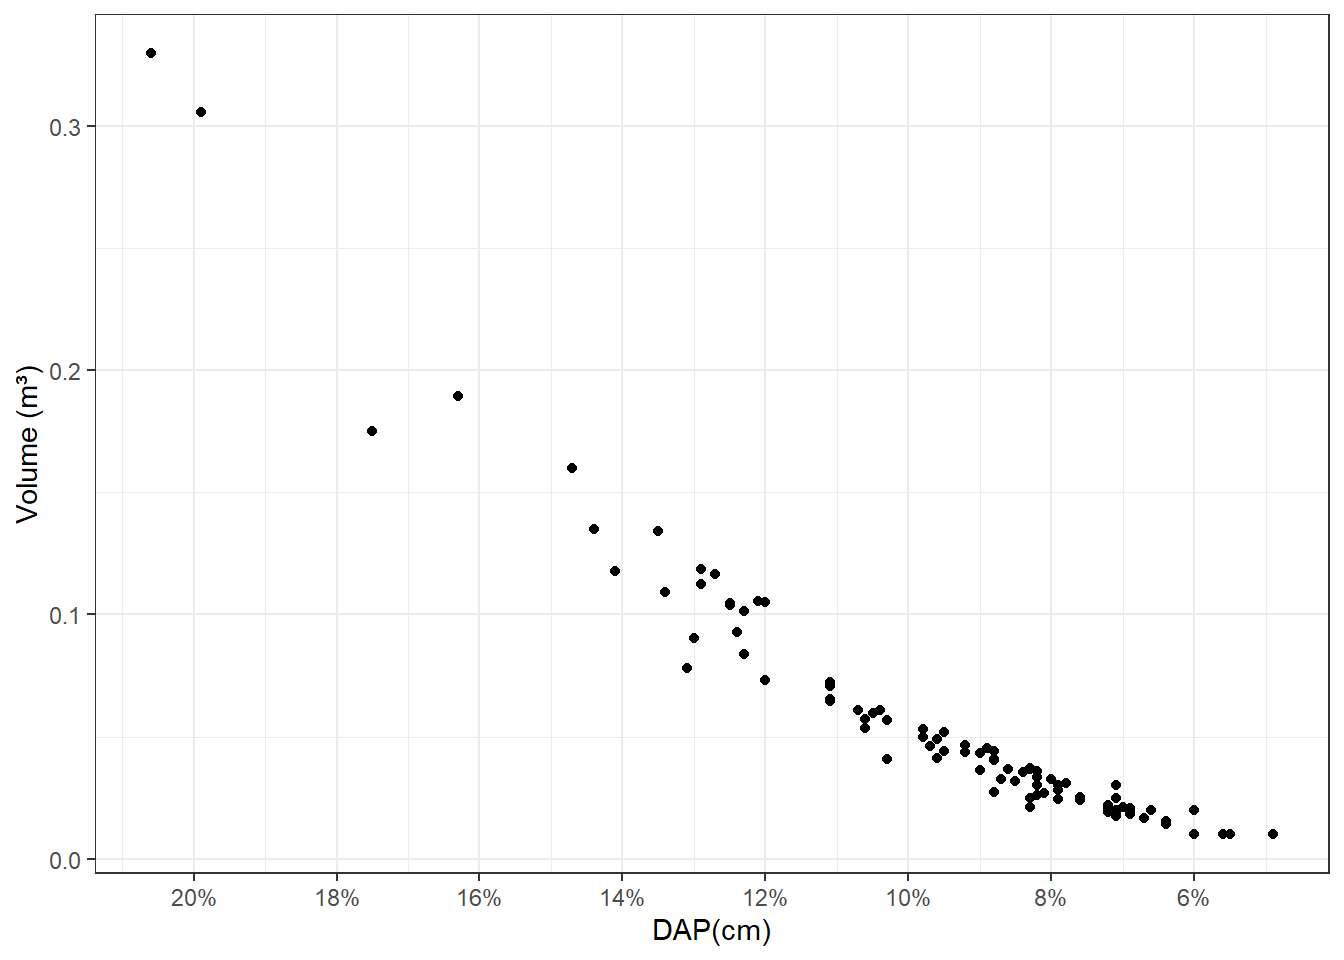
Uma das principais razões em alterar a escala dos eixos é para modificar a numeração de cada eixo, adicionando mais ou menos marcas, com números mais ou menos espaçados. Além disso, é possível adicionar pequenos símbolos junto aos números em escalas contínuas, como porcentagem ou expoentes.
Por praticidade, as operações serão todas feitas no eixo X, mas alterações no eixo Y são da mesma forma.
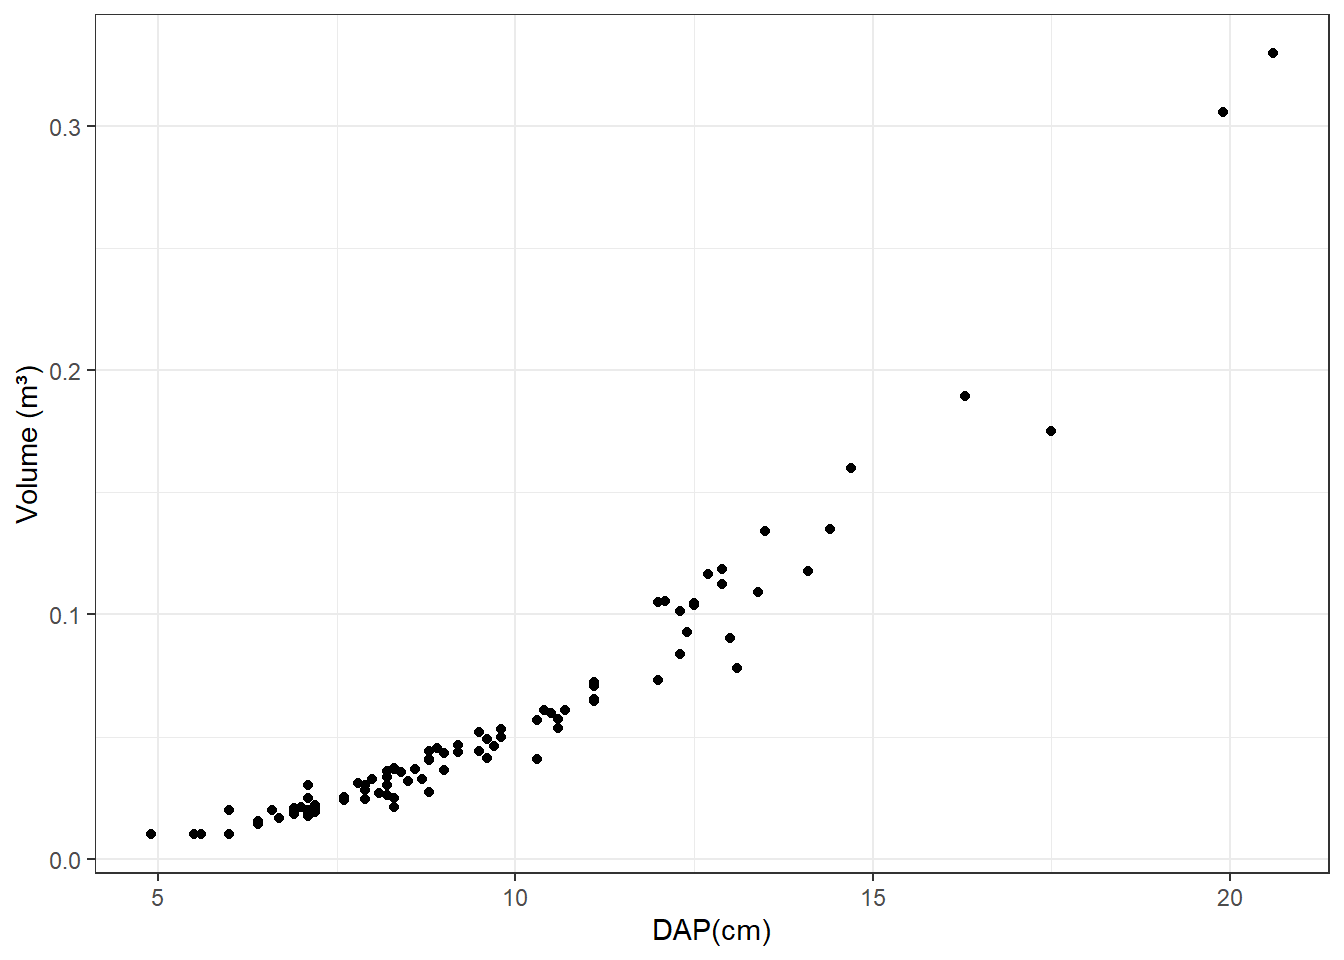
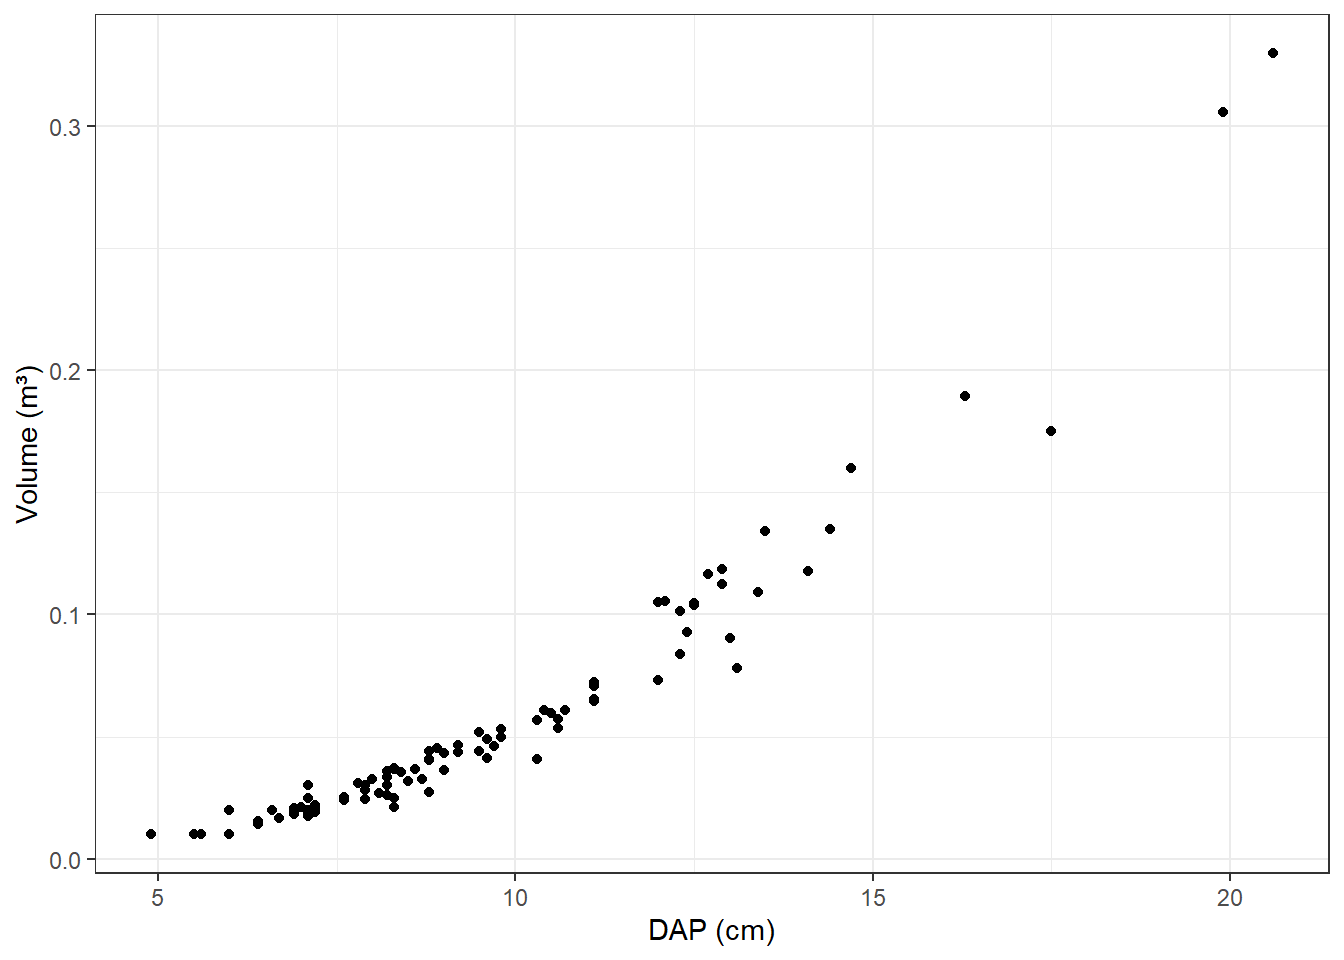
g.base <-ggplot(dados, aes(d,v)) +labs(x ="DAP(cm)", y ="Volume (m³)") +geom_point()g.base
Exemplos
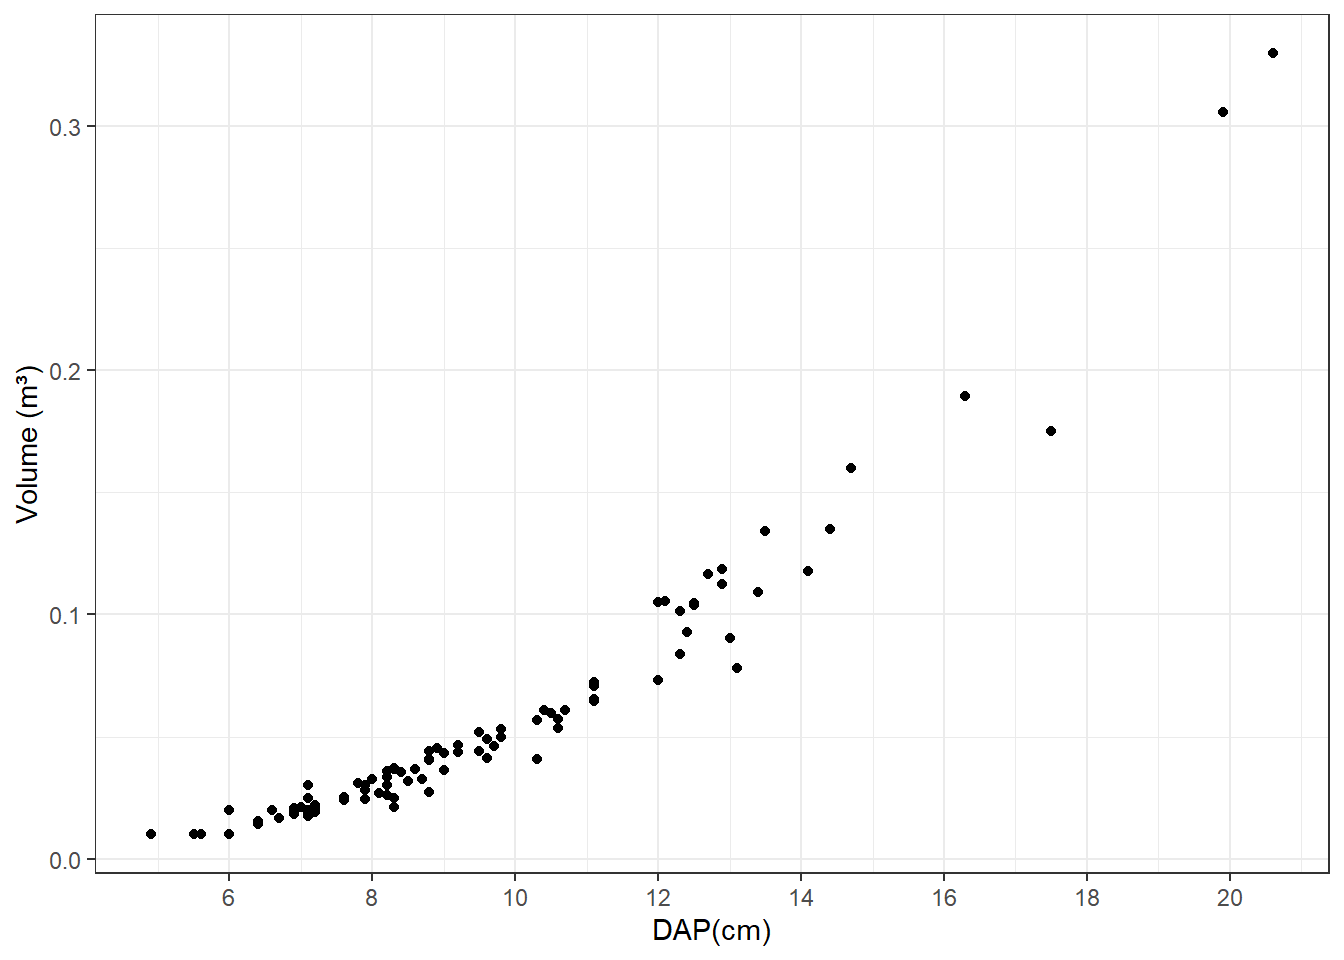
#Define que as quebras serão uma sequência de 0 a 30, de 2 e 2g.base +scale_x_continuous(breaks =seq(0,30,2))
#As quebras são definidas no argumento breaks.#Define que as quebras irão de 0 a 10, de 1 em 1g.base +scale_x_continuous(breaks =seq(0,10,1))
#Observe que informar uma amplitude de valores menor que a real amplitude dos dados não delimita o início e fim do eixo.#Adiciona um símbolo nos númerosg.base +scale_x_continuous(labels =function(numero) paste0(numero, "%"))
#Os rótulos dos eixos são definidos pelo argumento labels. Note que o argumento recebe uma função que, para cada número do eixo, pegue esse número e cole-o junto com o símbolo "%".#Juntando breaks e labelsg.base +scale_x_continuous(breaks =seq(0,30,2), labels =function(x) paste0(x,"%"))
#Invertendo o eixog.base +scale_x_reverse()
#Os outros comandos permanecem disponíveisg.base +scale_x_reverse(breaks =seq(0,30,2), labels =function(x) paste0(x,"%"))
TEMA
O tema é onde são feitos os acabamentos do gráfico. No tema, pode-se tornar negrito os títulos dos eixos, mudar o local de inserção da legenda, aumentar o espaço entre o título e o gráfico, mudar a cor do fundo, etc.
As mudanças de tema são passadas dentro da função theme(), que normalmente é a última ou uma das últimas camadas inseridas no gráfico. Dentro de theme() há uma infinidade de argumentos passíveis de alteração. Digite theme() no console e pressione a tecla Tab entre os parênteses para conferir.
A família element_
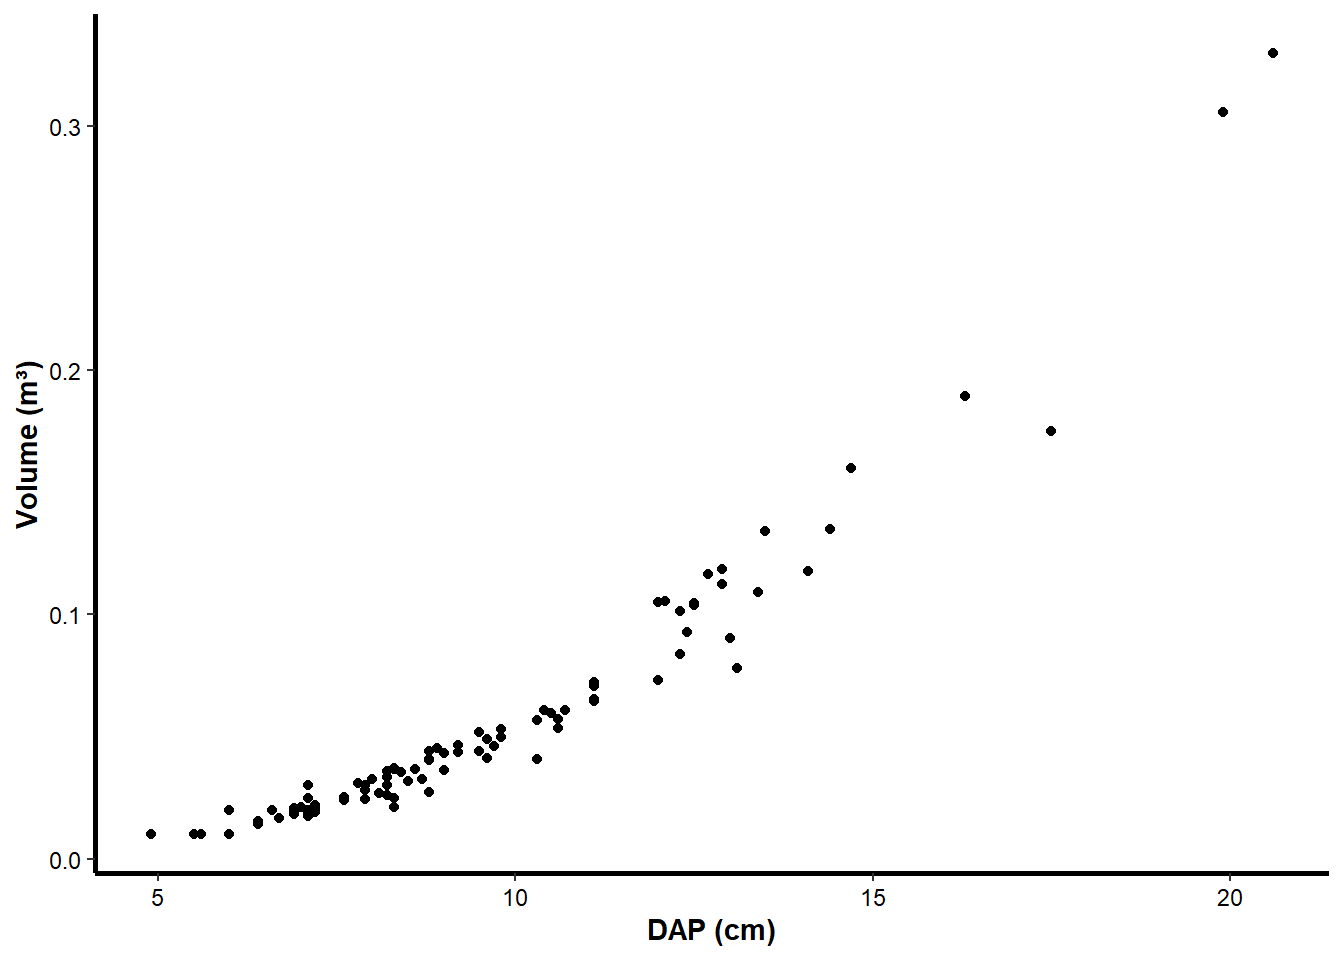
Para fazer alguma mudança nos títulos dos eixos, por exemplo, o argumento é theme(axis.title = ). Assim, será realizada uma mudança dentro dos títulos dos eixos. Note que essas opções também podem ser feitas para algum eixo específico (via axis.title.x e axis.title.y).
Já para alterar as linhas de grade do fundo do gráfico, o argumento é panel.grid, com suas variações para eixo e para maiores ou menores.
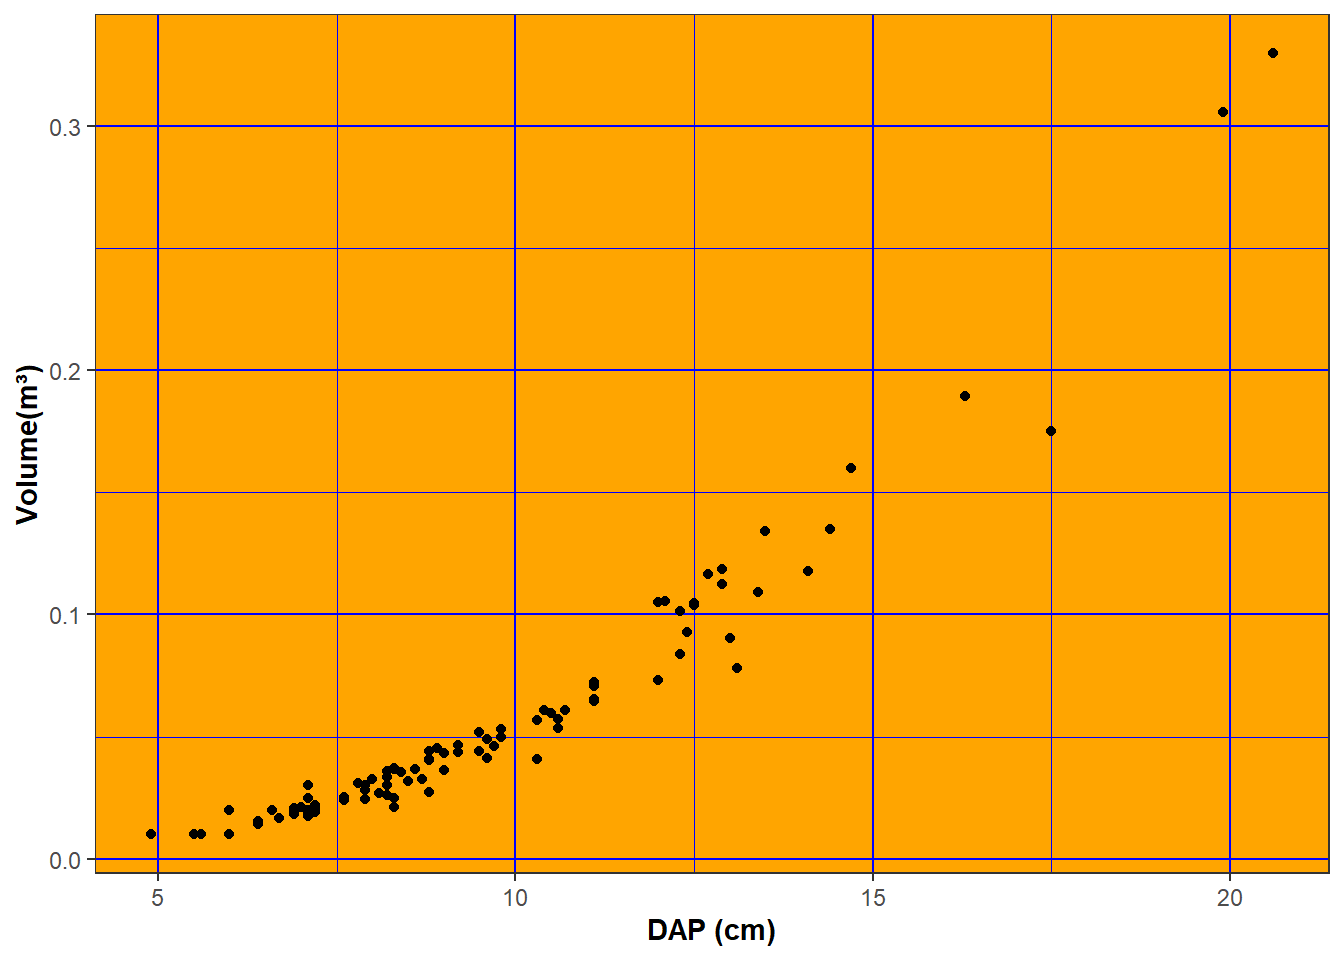
Como terceiro exemplo, é possível alterar a cor do fundo do gráfico, pelo argumento panel.background. Vamos ver esses três exemplos no gráfico abaixo.
Note que para cada alteração há uma função element_ diferente. A decisão de qual usar depende do tipo de alteração.
element_rect(): usada para alterar elementos que envolvem uma área, que possam ser preenchidos (fill);
element_line(): usada para alterar linhas em geral;
element_text(): usada para alterar caracteres de texto;
element_blank(): usada para remover o elemento do gráfico.
Perceba que no exemplo acima, a mudança dos títulos dos eixos recebe element_text; as linhas de grade são alteradas com element_line; e o fundo do gráfico recebe element_rect. Cada função da família element_ possui dentro de si argumentos referentes ao seu tipo de alteração, ou seja, não há a opção ‘fill’ dentro de element_line, por exemplo, pois linhas não possuem preenchimento.
g.base <-ggplot(dados, aes(d,v)) +geom_point() +labs(x ="DAP (cm)", y ="Volume (m³)")
Exemplos
# Removendo linhas de grade - element_blank()g.base +theme(panel.grid =element_blank())
# Mudando o tamanho dos textos dos eixosg.base +theme(axis.text =element_text(size =12))
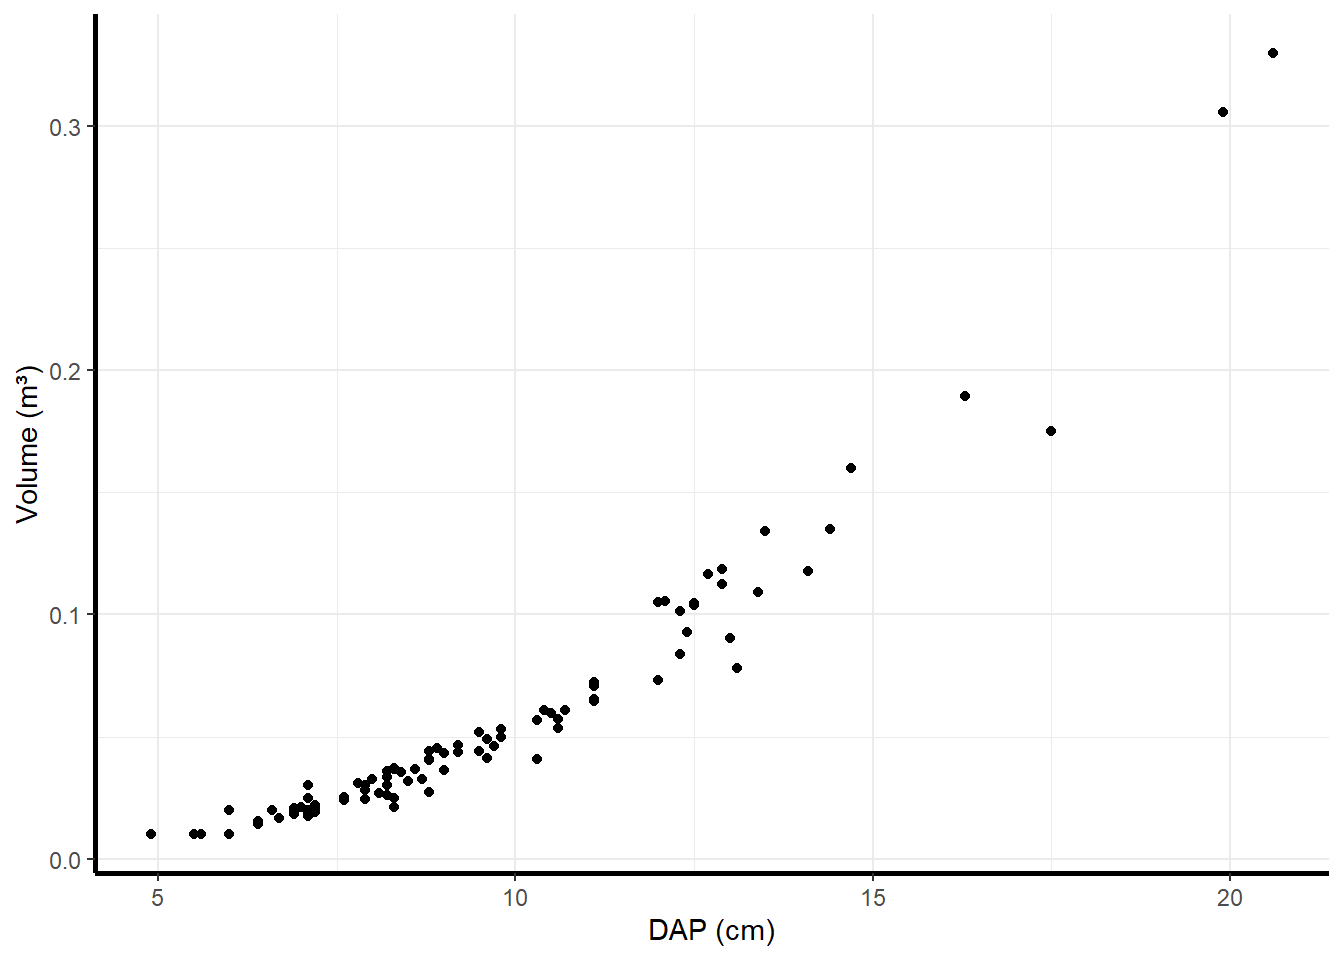
# alterando a caixa do gráficog.base +theme(panel.border =element_blank(),axis.line =element_line(linewidth =1))
#Note que hjust realiza um deslocamento horizontal relativo ao próprio eixo.
Temas prontos
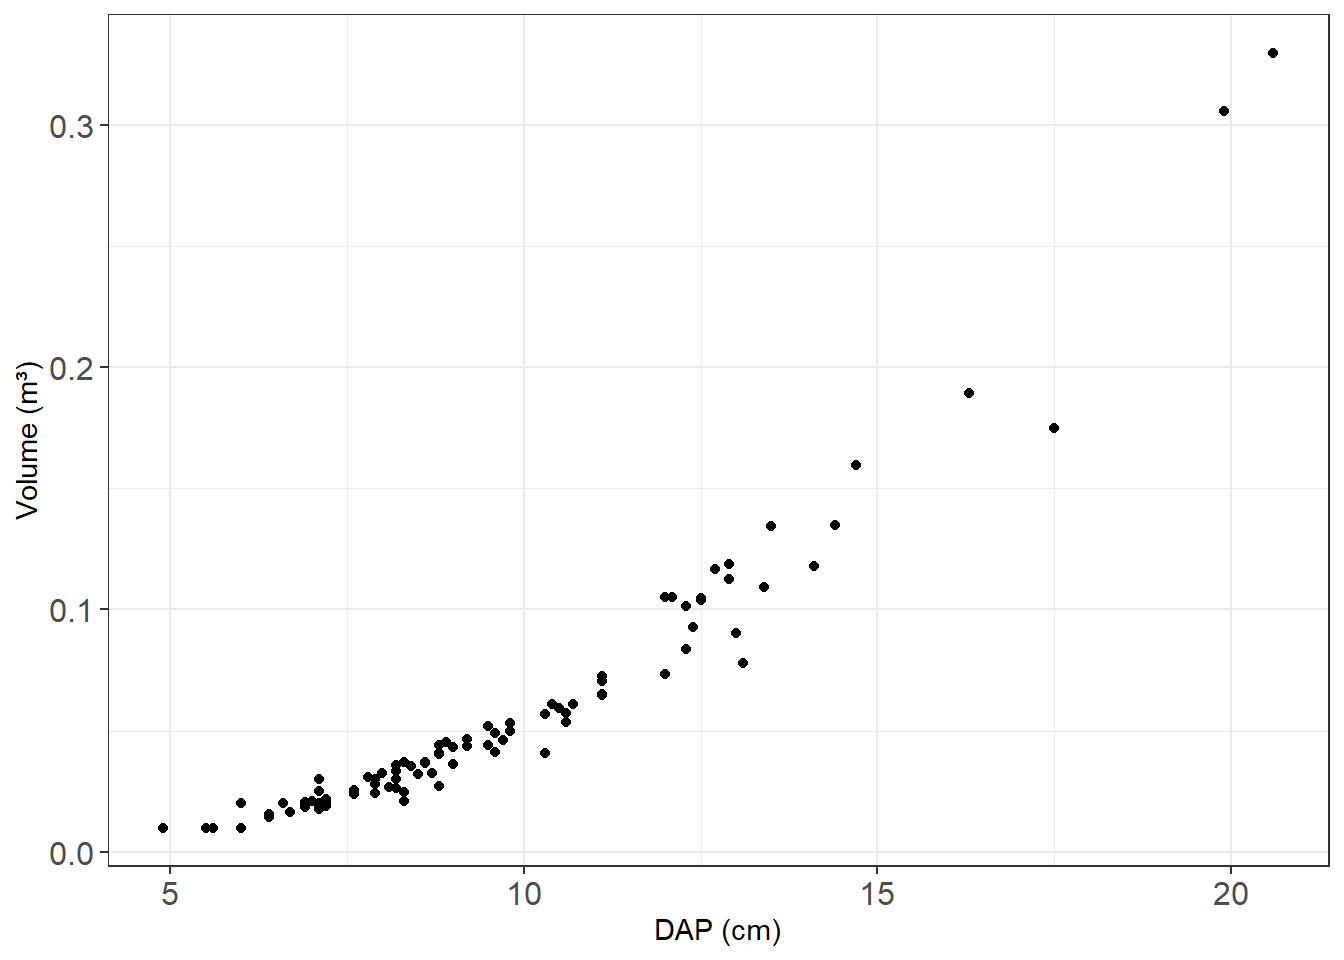
Há também uma porção de temas prontos. Para utilizá-los, basta adicionar alguma função theme_ e selecionar a função desejada. Alguns exemplos são theme_classic(), theme_bw(), theme_minimal(), theme_grey(), theme_dark().
Mais temas podem ser obtidos no pacote ggthemes
IMPORTANTE: Caso queira utilizar um tema pronto, e ainda assim realizar alguns ajustes nele, apenas tenha o cuidado de adicionar o tema pronto (theme_) antes da função de modificação de temas (theme()). Caso contrário, o tema pronto irá sobrepor as modificações.
g.base +theme_get()
g.base +theme_gray()
g.base +theme_dark()
g.base +theme_minimal()
g.base +theme_light()
g.base +theme_linedraw()
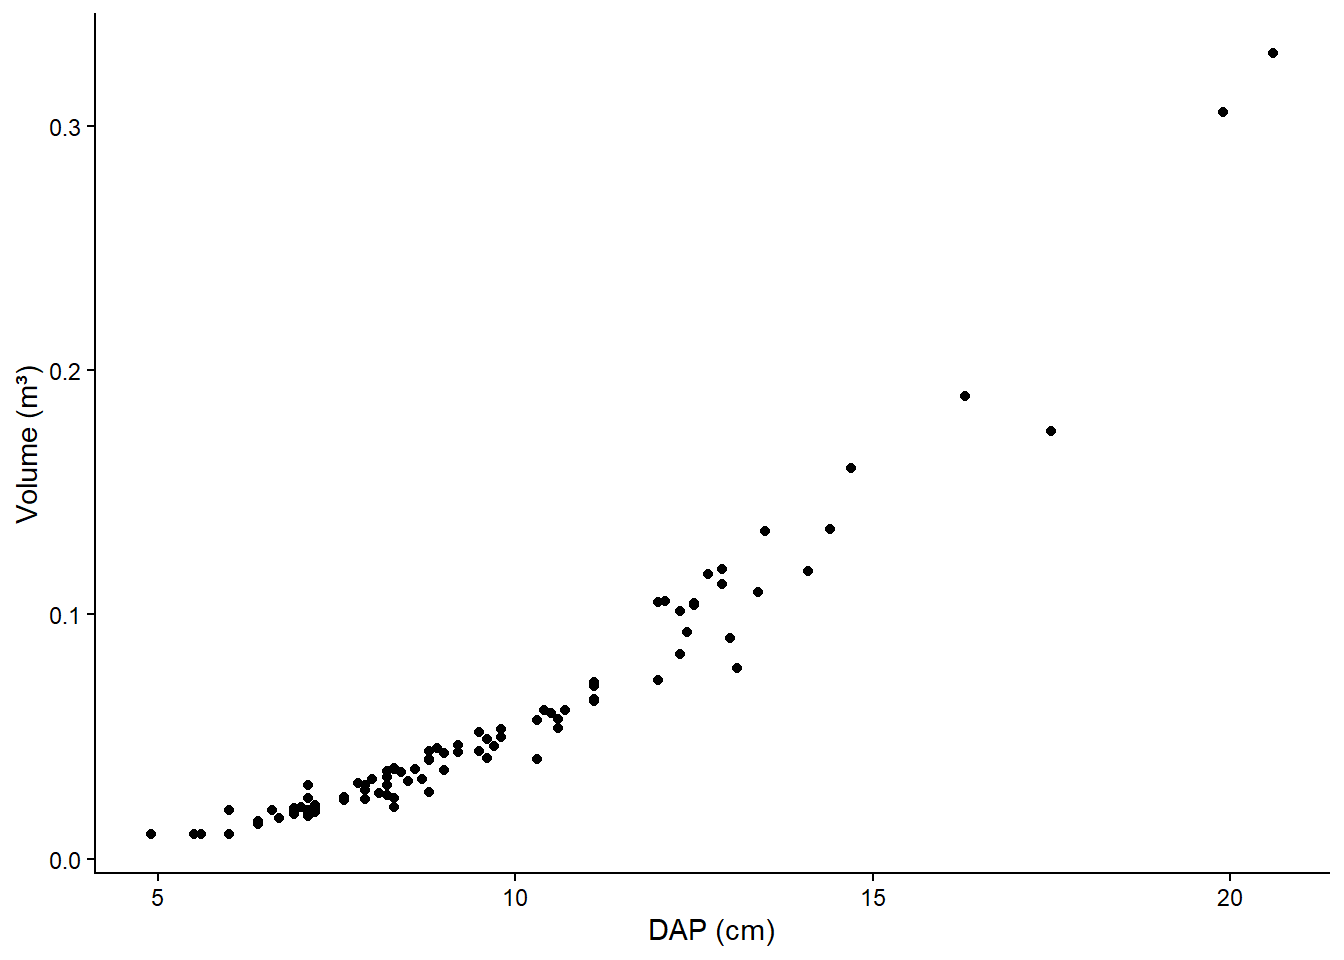
g.base +theme_classic()
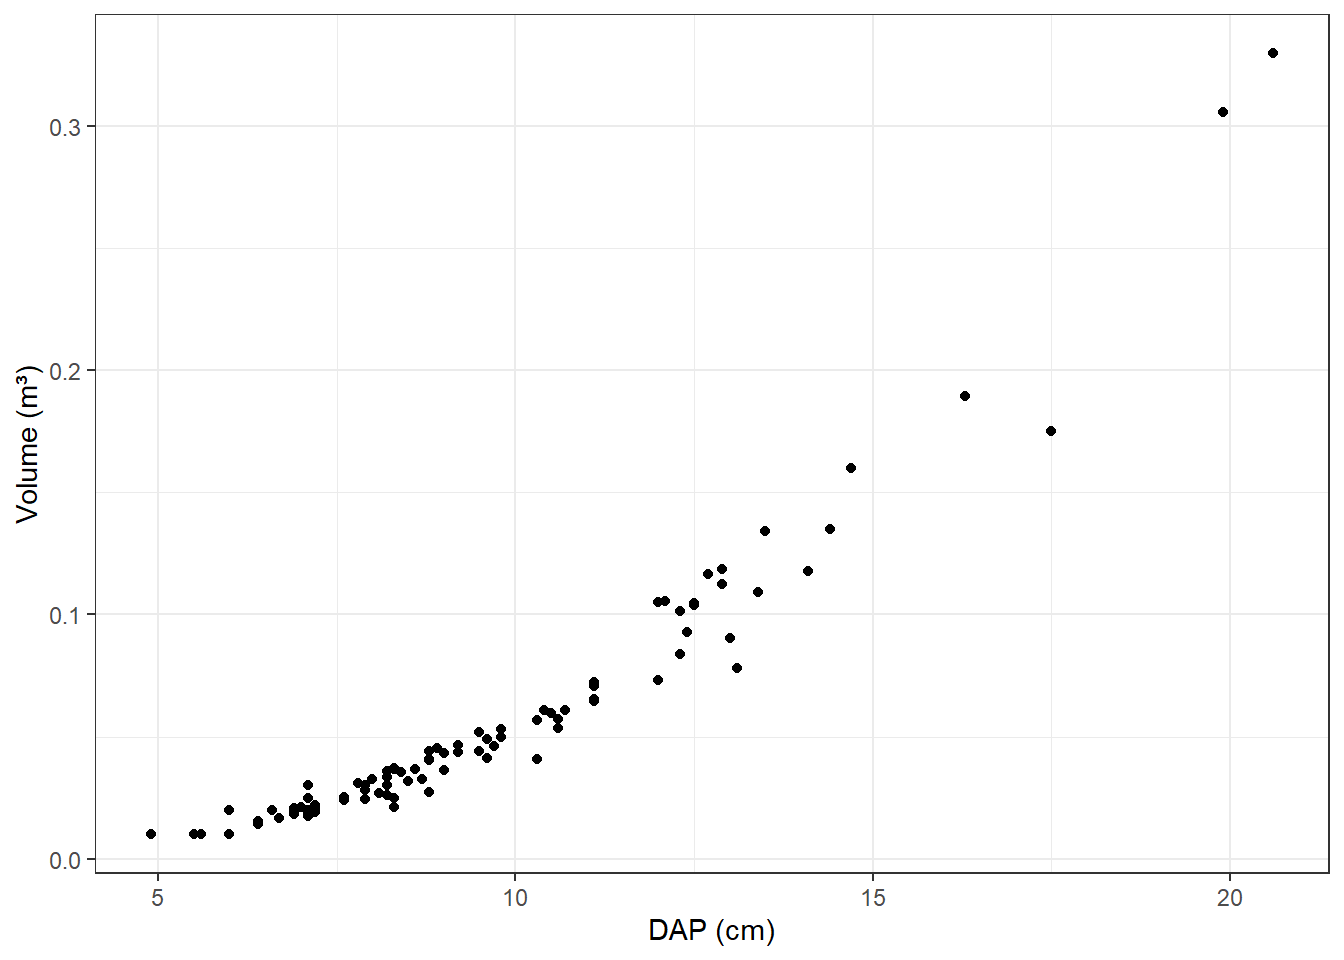
g.base +theme_bw() #é o utilizado ao longo desse script
Mudando a legenda
No tema, é possível fazer algumas alterações na legenda. As principais são definir a posição da legenda ou ocultá-la.
g.base <- g.base +geom_point(aes(color = classe))#____________________________________________________________# Inserindo a legenda na base do gráficog.base +theme(legend.position ="bottom")
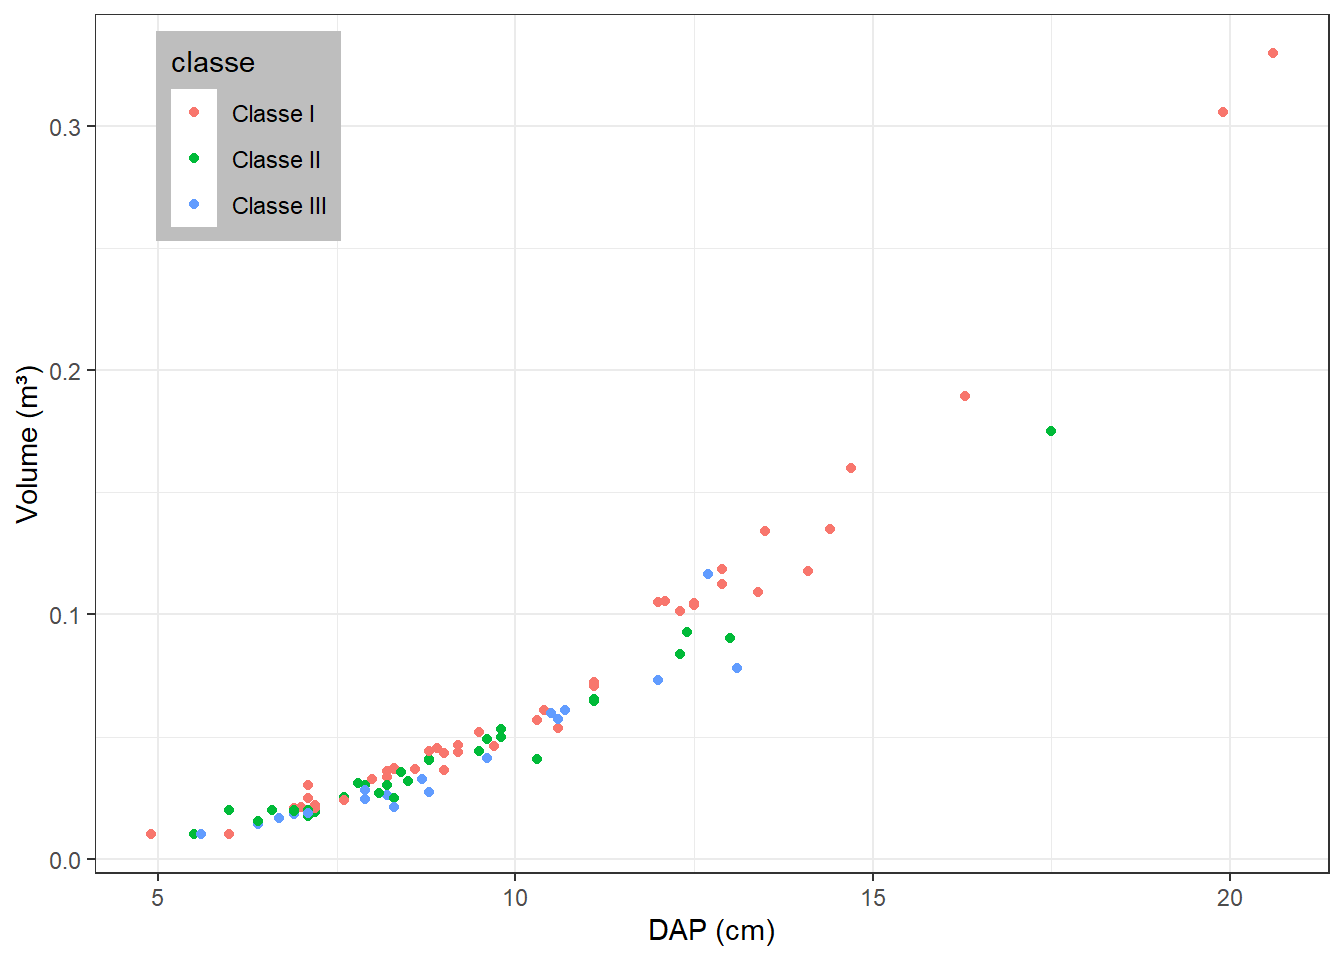
#o padrão é right, mas é possível informar "bottom", "left", e "top"# Inserindo dentro do gráficog.base +theme(legend.position ="inside",legend.position.inside =c(0.05, 0.98),legend.justification =c(0, 1),legend.background =element_rect(fill ="grey"))
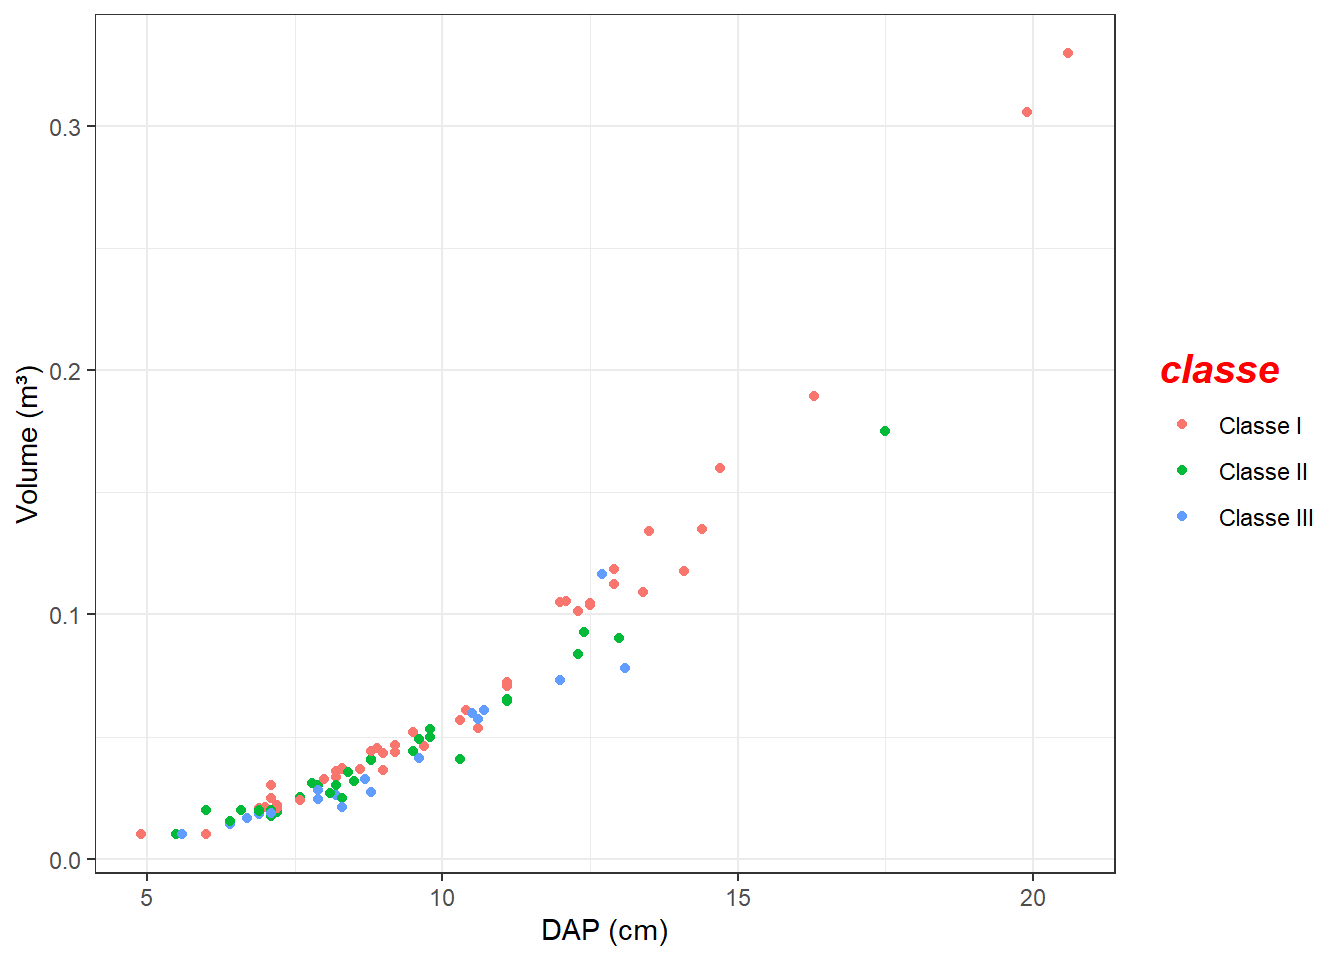
# Para inserir a legenda dentro do painel, legend.position = "inside" ativa essa posição.# legend.position.inside recebe coordenadas relativas (x, y), variando de 0 a 1.# legend.justification define qual ponto da própria legenda será ancorado nessas coordenadas.# No exemplo, c(0, 1) representa o canto superior esquerdo da legenda.# Alterando título da legendag.base +theme(legend.title =element_text(face ="bold.italic", size =15, color ="red"))
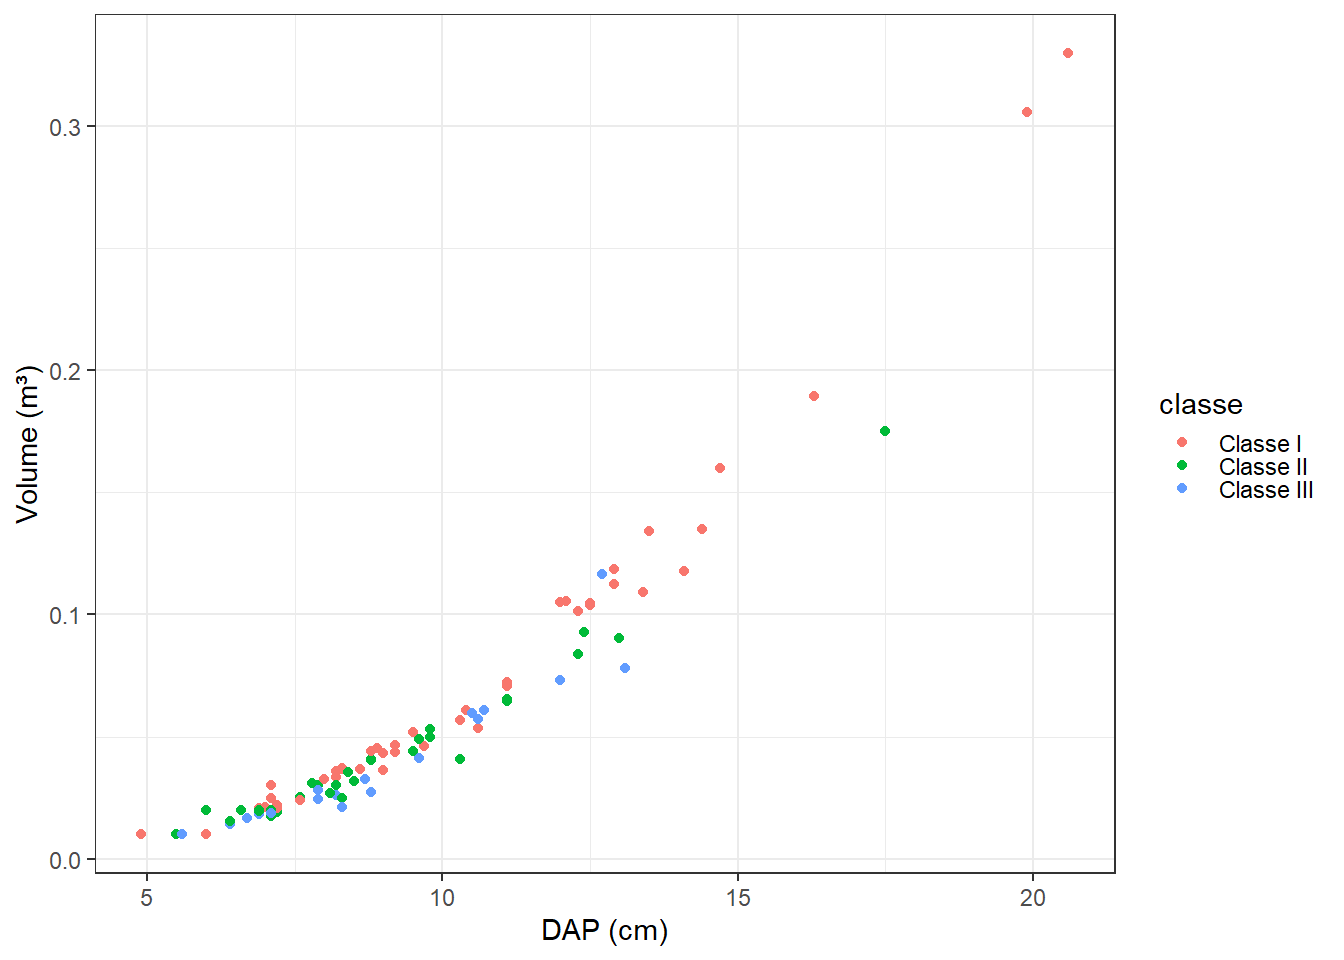
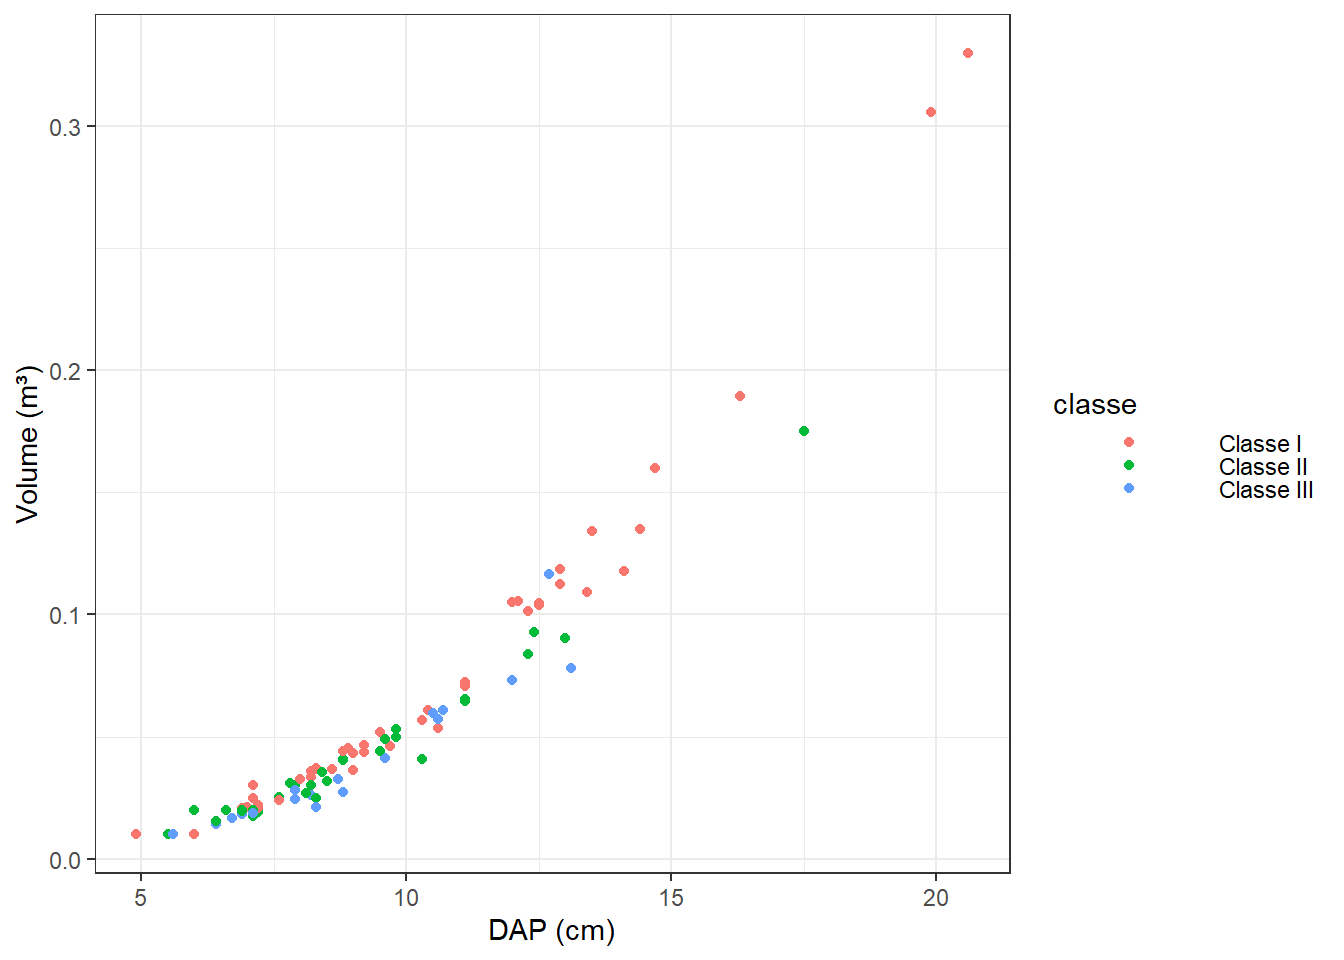
# Espaçamento dos símbolosg.base +theme(legend.key.height =unit(0,"mm"))
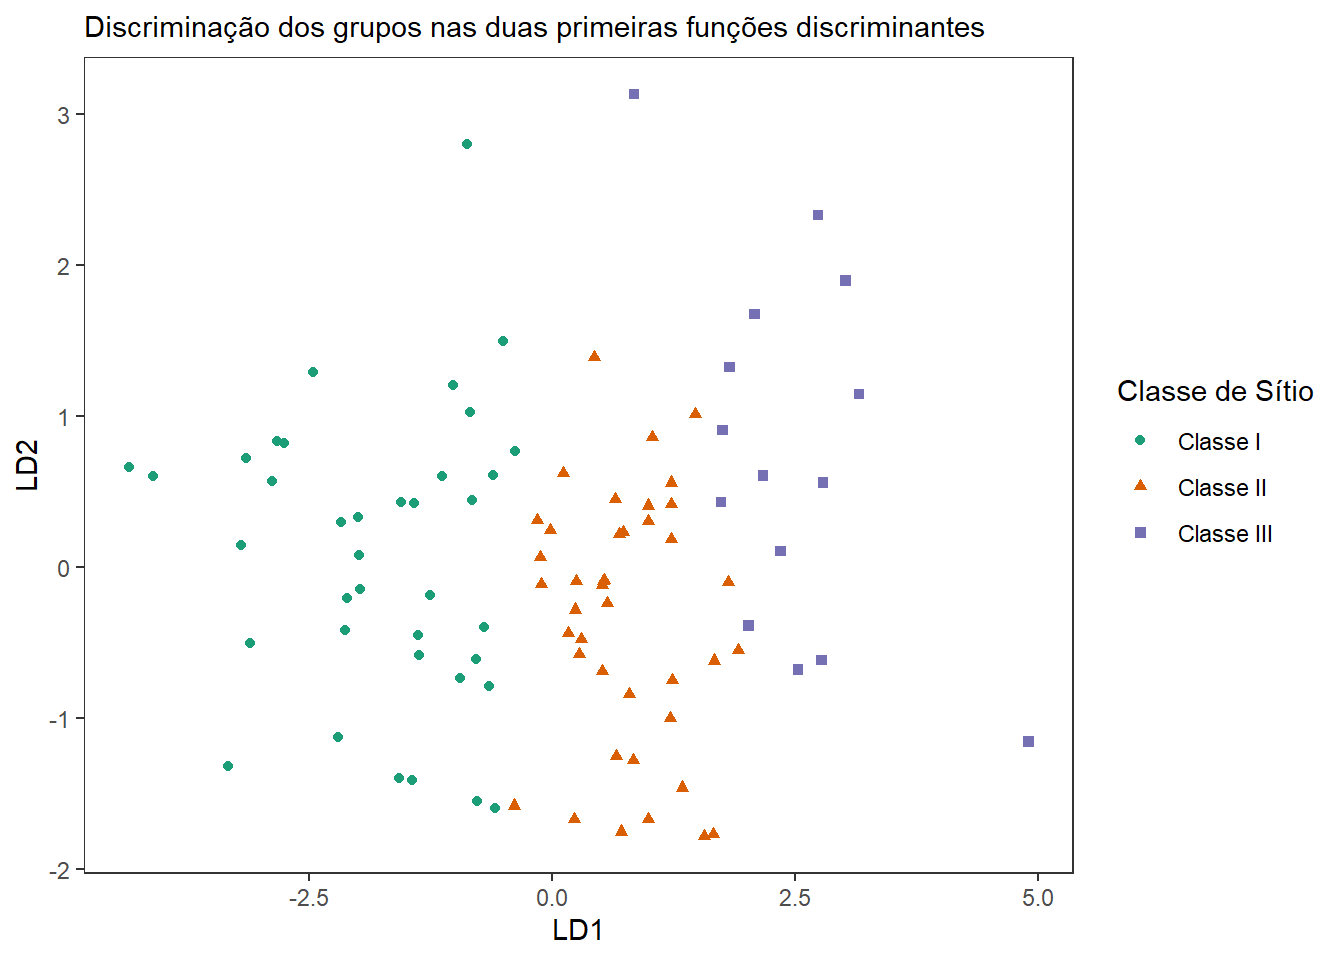
# Ajuste da análise discriminante linearad <-lda(classe ~ d + hdom + gha + npragas + idade, data = dados)# Escores das observações nas funções discriminantespred.ad <-as.data.frame(predict(ad)[["x"]])pred.ad$class <-predict(ad)$class# Plotando os escores nas duas primeiras funções discriminantesggplot(pred.ad) +geom_point(aes(x = LD1, y = LD2, shape = class, color = class)) +labs(subtitle ="Discriminação dos grupos nas duas primeiras funções discriminantes") +scale_color_brewer(palette ="Dark2", name ="Classe de Sítio") +scale_shape(guide ="none") +guides(color =guide_legend(override.aes =list(shape =c(16, 17, 15),linetype =c(NA, NA, NA) ) ) ) +theme(panel.grid =element_blank())
Regressão
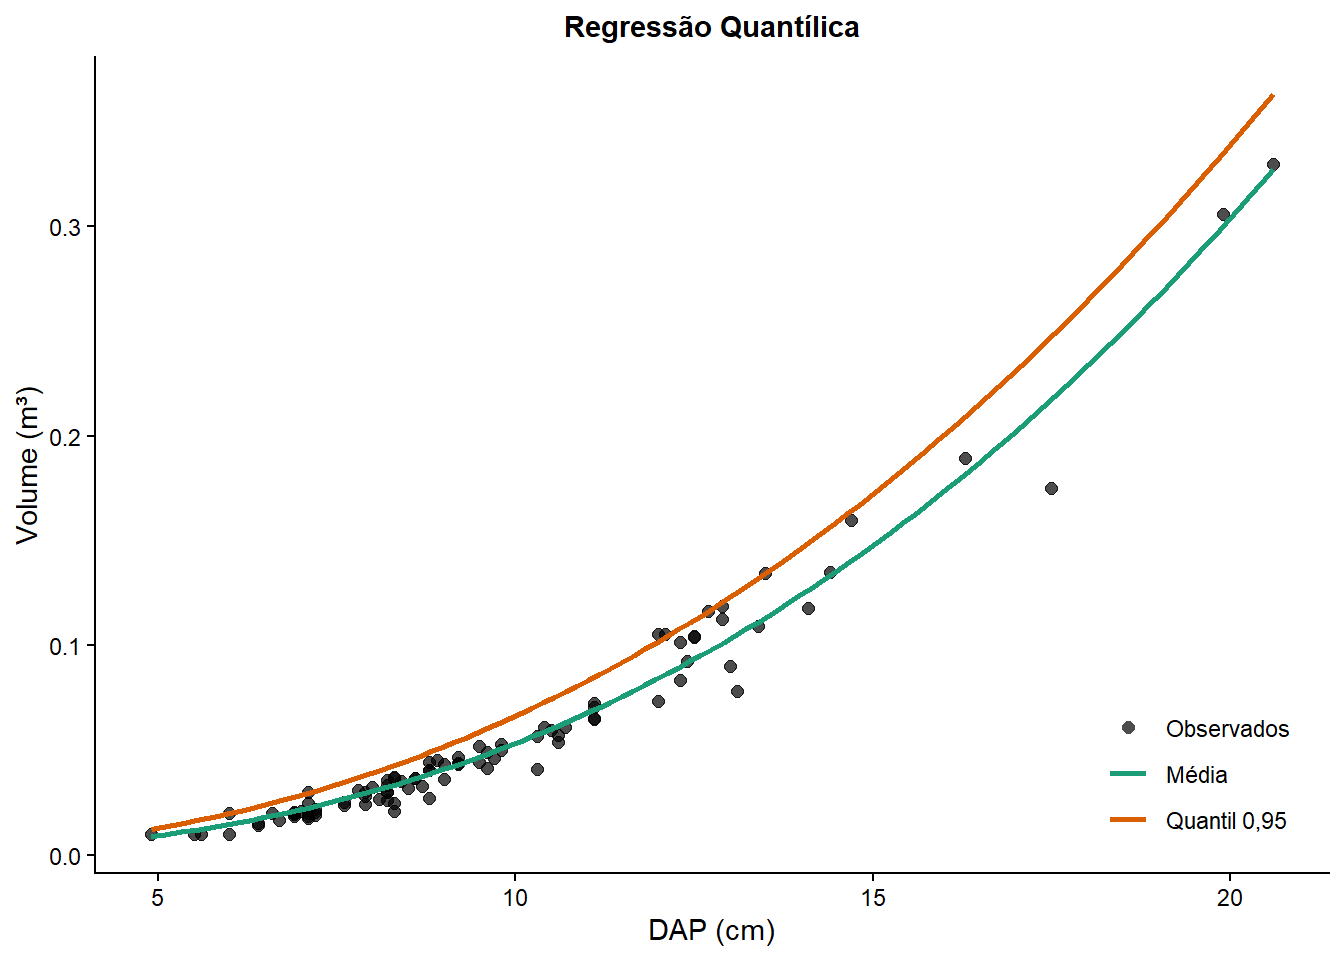
#Ajuste não linear#___________________________________________________fit <-nls(v ~ b0*d^b1, data = dados, start =list(b0 =1, b1 =3))coef(fit)
          b0           b1
0.0001662425 2.5072366647
func.fit <-function(x) {coef(fit)[1]*x^coef(fit)[2]}#___________________________________________________#Ajuste por regressão quantílica#__________________________________________________#install.packages("quantreg")library(quantreg)